论文:Beyond Point Predictions: Manifold Expansion and Dual Alignment for Robust Time Series Distillation(ICML 2026, PMLR 306) 作者:Junyao Hong、Zesheng Lai、Xinyi Xiao、Suyang Zhou、Aodong Shen、Youyong Kong(东南大学) 定位:时间序列预测的结构蒸馏框架 DSD——老师给的方法论教材之一。核心价值不在时序任务本身,而在**“结构蒸馏优于逐点匹配 + 教师不可靠时要会说不”**这两个可迁移到检测的思想
背景:为什么“逐点匹配预测”不够
问题:传统时序蒸馏继承 CV 范式,用逐点预测匹配(输出级蒸馏)约束学生——但时序预测的教师输出天然不确定(噪声、分布偏移、相位错位),盲目模仿会引发负迁移(学生学到教师的错误而非知识)。
逐点匹配:学生预测 ≈ 教师预测(连错误一起学)
   ✗ 教师输出不可靠时 → 学生继承"虚假误差"而非"有效动力学"
   ✗ 特征粒度不匹配:教师是 token/patch 级,学生是 point 级,直接 MSE 不适定
DSD 的答案:
① 优先做【结构关系对齐】(拓扑/几何),而不是值对齐 → 更稳定的知识
② 预测级蒸馏【按需开启】:regime 先验 + 置信度门控,不可靠就关掉
③ 学生架构【流形扩展】(LMP-Net):轻量但表达力足
核心思想:Dynamic Structural Distillation(DSD)框架
教师(冻结,如 PatchTST):token/patch 级特征 + 预测
   ↓ 蒸馏
学生 LMP-Net(轻量 point 输入):流形扩展 + 双重对齐 + 按需预测蒸馏三大组件:
| 组件 | 解决什么 | 一句话 |
|---|---|---|
| LMP-Net(流形扩展) | 线性模型表达力不足 | Expand→Evolve→Contract,把季节动态升到高维潜在流形再演化 |
| Dual Manifold Alignment | 粒度不匹配(token vs point) | Macro-SPKD 保全局拓扑 + Micro-OT 做局部软对应 |
| RAAD | 教师预测不可靠 → 负迁移 | dataset 级 regime 开关 + instance 级置信度门控 |
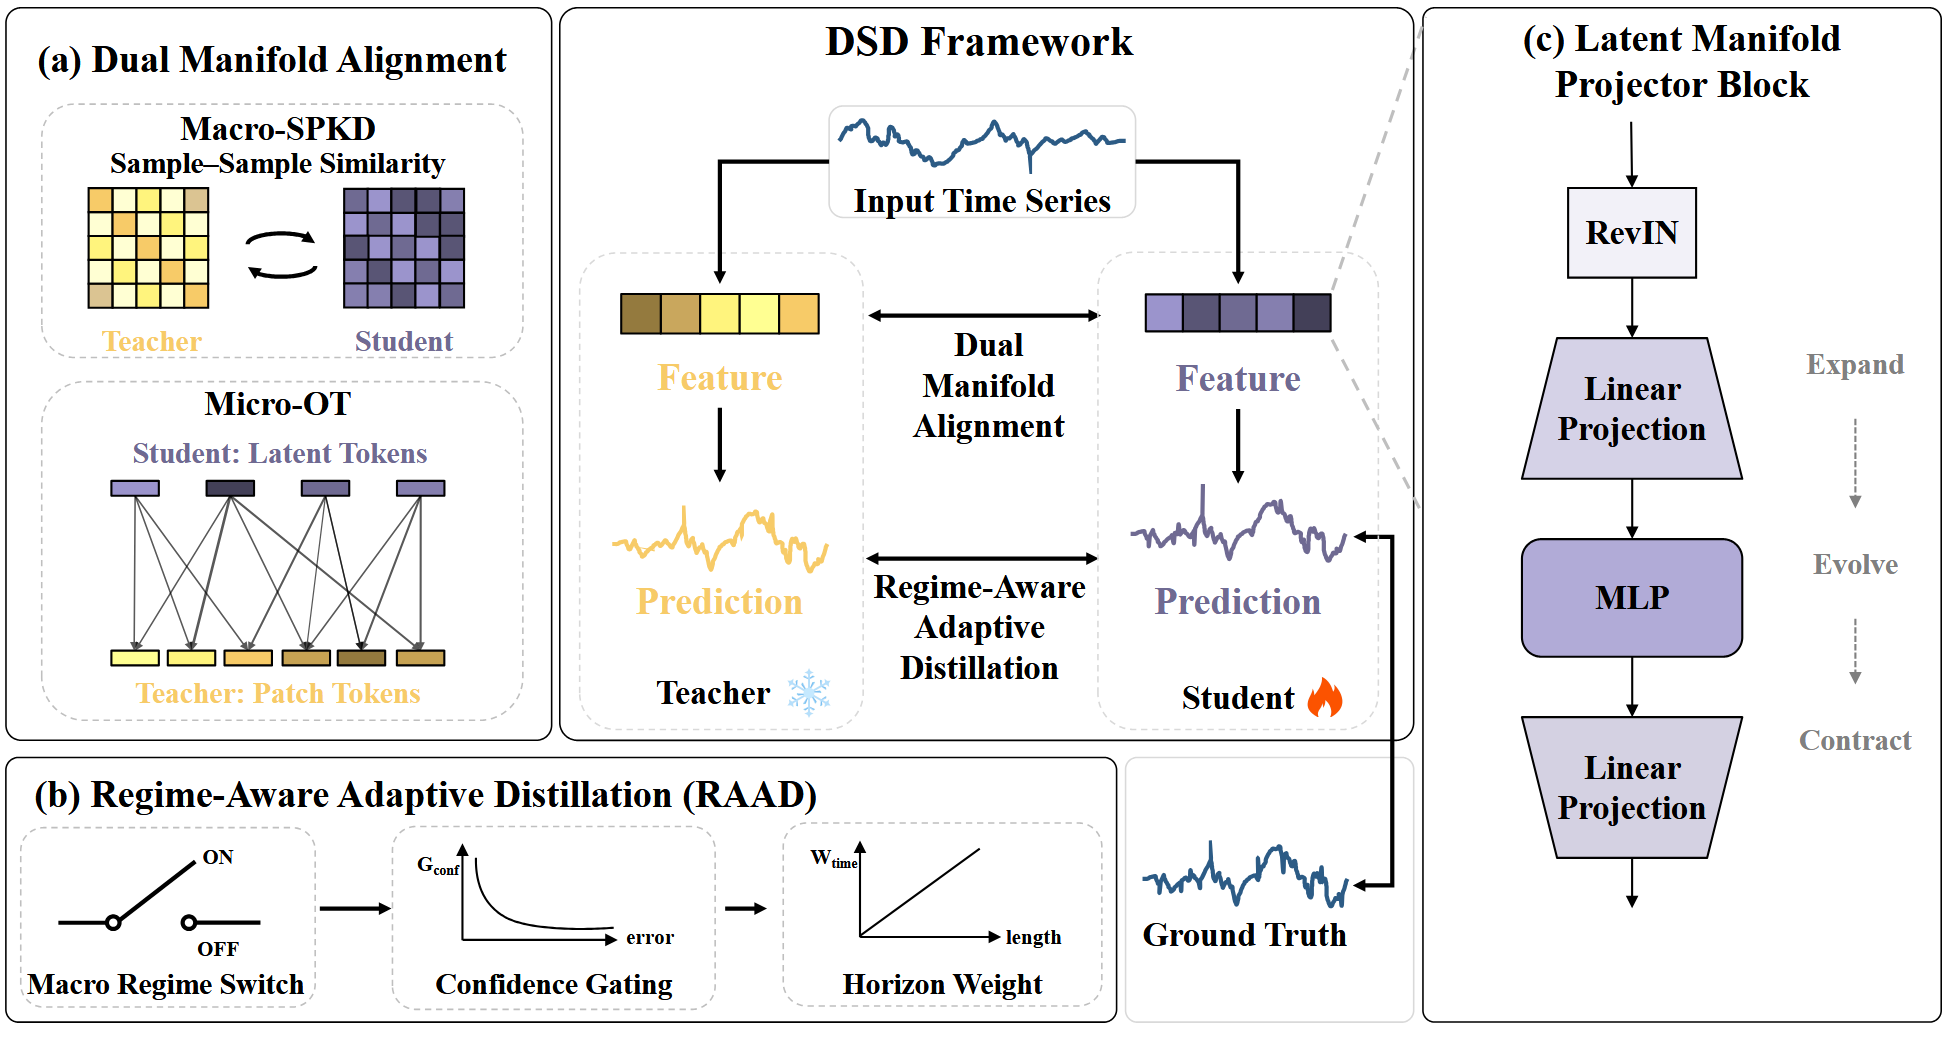
模块①:LMP-Net——流形扩展(Expand-Evolve-Contract)学生模块
动机:DLinear 等线性模型高效但表达力不足。受 Cover 定理启发(数据在高维空间里更容易被线性/简单结构建模),把序列投影到高维流形上演化——轻量但表达力足。
完整流水线(公式 1→4):
X(真实尺度,96 步)
  ↓ ① RevIN 归一化(公式1)→ 标准尺度
  ↓ ② 分解(公式2):趋势 + 季节
趋势分支:X_trend ──线性 W_trend──→ Ŷ_trend ──┐
季节分支:X_season ─Expand→Evolve→Contract──→ Ŷ_season ──┼→ 相加
                                             ↓ ③ DeNorm(还原尺度)
                                        Ŷ(真实数值,H 步)
Step 1:RevIN 归一化(公式 1)
- 沿时间维归一化每个样本/变量:均值 0、方差 1,训练更稳
- 后面 DeNorm 要还回来(乘回 σ、加回 μ),输出才是真实数值
Step 2:移动平均分解(公式 2)
| 分量 | 特征 | 建模方式 |
|---|---|---|
| 趋势 X_trend | 慢变化、平滑(整体走势) | 线性就够 |
| 季节 X_season | 快波动、非线性(峰值/周期) | 才需要升维演化 |
算力花在刀刃上:趋势平缓→线性;季节复杂→上高维房间。这是 LMP-Net 轻量(0.18M)的原因之一。
Step 3:趋势分支(线性映射)
- channel-independent:每个变量通道独立一个小线性层(DLinear 惯例),省参数、避免通道间虚假耦合
Step 4:季节分支 —— Expand(升维,公式 3)
本质:一个单层全连接(不是 MLP!)——和 d2l 的 Linear + 激活 + Dropout 完全一样:
| 符号 | 是什么 | 形状 |
|---|---|---|
| 输入(季节分量) | 维(96) | |
| 可学习权重 | (96×512) | |
| GELU 激活(非线性关键) | — | |
| 高维潜在表示 | 维(512) |
为什么必须有激活 ?没有它,“升维”就只是线性变换,和 DLinear 没区别。升维 + 激活才是“流形扩展”能工作的关键。
Step 5:Evolve(演化,公式 3b)
- 多层 MLP(区别于 Expand 的单层),在高维空间里做非线性处理
- 与 Expand 分工:Expand 管“搬进高维房间”(维度变换),Evolve 管“在房间里干活”(信息加工)——不是重复
Step 6:Contract + 合并 + DeNorm(公式 4)
三件事:
- Contract(收缩):,512 维压回 H 步预测(与 Expand 对称);
- 合并:趋势预测 + 季节预测相加(开头拆开的,现在加回来,恢复完整信号);
- DeNorm(反归一化):把标准尺度还原成真实数值(如 3500 kW、23.5°C)。
蒸馏锚点
取演化后的高维表示作为学生结构特征,供模块②的 Macro-SPKD / Micro-OT 对齐用——架构和蒸馏是配套设计的。
为什么“升维 + 分步”有效
- Cover 定理:高维空间里非线性关系更容易被简单结构建模(揉皱的纸摊开后结构就直了);
- 单层升维 + 多层演化:一个管“维度变换”、一个管“非线性加工”,职责分离不能合并(线性+线性=线性);
- 趋势/季节分流:只有复杂的季节分支花钱升维,趋势保持线性——轻量的关键。
效果背书:0.18M 参数 / 0.08G MACs,MSE 0.472 超过 13.89M 的 PatchTST 教师(0.488)——轻量且表达力足的实证。
大白话:把“季节模式”扔进更高维的房间(Expand),在房间里仔细找规律(Evolve),再把结论压回输出(Contract),最后和趋势预测合并、还原成真实数值(DeNorm)。
模块②:Dual Manifold Alignment——双视角流形对齐(核心)
一句话本质:模块② = 两道题,每题算一个“差距数字”,训练时让差距变小。① 样本间“谁像谁”的关系像不像(Macro);② token 细节对得上吗(Micro)。
模块定位:模块②是训练时的特征级蒸馏损失(不是网络组件)——把学生中间特征 向教师特征 对齐,学“思考过程”而非“答案”。推理时模块②消失,只剩学生模型(模块①)。
问题:教师是 token/patch 粒度(P 个 patch token),学生是 point 粒度——直接特征匹配(MSE)因 token 数/维度不匹配而不适定。
解法:把教师表示统一成两个视角,宏观 + 微观分别对齐:
教师特征两视图:
  全局视图 F_T^mean:沿 token 维池化(每个变量的整体表示)→ 用于 Macro
  token 视图 F_T^token:保留 patch 维 → 用于 Micro(教师非 token 化则退化)
第一题:Macro-SPKD——样本关系账本(公式 5-8)
人话故事:老师心里有本“相似度账本”(样本 1 和 2 很像=0.9,1 和 3 不像=0.3…)。学生一开始的账本不对。模块②让学生把账本改成和老师一样。
| 公式 | 人话 |
|---|---|
| (5) | 统一尺码:学生特征 512 维、教师 128 维没法比 → 可学习投影 g 把学生特征变成教师大小 |
| (6) | 只看方向:每个样本展平 + L2 归一化(去掉强弱,只留方向) |
| (7) | 算账本:样本两两相似度 → Gram 矩阵(B 个样本 = B×B 表) |
| (8) | 比账本:两张表逐格相减平方求和。表一样→0,不一样→正数要减小 |
具体例子(3 个样本):教师认为样本 1-2 像(0.9)、1-3 不像(0.3);学生一开始只给 0.5 → 损失惩罚它,训练后学生的账本逐渐贴近教师。不匹配激活值,只匹配“关系”——拓扑蒸馏,对特征幅度不敏感。
第二题:Micro-OT——细节搬运费(公式 9-12)
人话故事:教师 8 个 patch token(8 段),学生 4 个 latent token(4 段),数量不同还可能错位。把学生 token 当“货”、教师 token 当“收货点”——找最便宜的搬法,运费就是损失。
| 公式 | 人话 |
|---|---|
| (9) | 学生也切段:可学习投影 ψ 把学生特征变成 K=4 个“潜在段” |
| (10) | 运费表:学生第 k 段和教师第 p 段有多不像(越不像运费越贵),4×8 的表 |
| (11) | 找最省搬法:Sinkhorn 算出最优搬运方案 T(εH(T) 是“软度”,允许模糊匹配) |
| (12) | 运费=损失:最省运费越小,说明学生细节越能对上教师细节 |
为什么用“搬运”而不是“一一对齐”? 数量不同(4 vs 8)+ 可能相位错位。硬对齐(第 1 段对第 1 段)会错位;搬运允许“学生第 1 段同时部分对应教师第 2、3 段”——软匹配,对时间偏移鲁棒。
Macro 与 Micro 互补(为什么两个都要)
| Macro-SPKD | Micro-OT | |
|---|---|---|
| 视角 | 宏观(整批样本之间) | 微观(单个样本内部) |
| 对齐什么 | 关系/拓扑(谁和谁像) | 细节/几何(段和段像) |
| 类比 | 比较“账本” | 计算“搬运费” |
| 单独用的问题 | 看得到全局关系,漏掉局部细节 | 看得到局部细节,漏掉全局结构 |
合起来 = 既保全局拓扑、又保局部几何——这就是“双流形对齐”里“双”的含义:一个学“关系结构”(谁和谁近),一个学“细节结构”(段和段像),互补覆盖特征对齐的两个层面。
总对齐损失(公式 13)
人话:宏观账本差 + 微观搬运费加权相加。 = 教师不是 token 结构时第二题不考(跳过)。
与模块①的关系:模块②对齐的对象 正是模块①(LMP-Net)的中间产物——没有模块①就没有可对齐的特征;没有模块②学生只学“答案对”不学“思路像”。推理时模块②消失,只剩模块①。
模块③:RAAD——Regime-Aware Adaptive Distillation(核心洞察)
一句话本质:老师(教师预测)也不是全对——瞎抄老师的错误答案会把自己学坏(负迁移)。RAAD 给“抄答案”装了两道过滤器:先看“这个数据集老师靠不靠谱”,再看“这个样本/这一步老师靠不靠谱”,不靠谱就少抄。
和模块②的分工:
模块② = 学"解题思路"(特征结构对齐)→ 【始终开】
模块③ = 学"答案"(预测值对齐)     → 【按需开,不靠谱就关】
核心疑问:有真实值了,为什么还要学老师的答案?
真实值只有一个“硬答案”(含噪声),教师的预测是“软的、结构化的规律答案”——学教师学的是归纳偏置,不是结果本身:
| 真实值 y | 教师预测 ŷ_T | |
|---|---|---|
| 是什么 | 实际发生的数值 | 教师基于历史学到的规律性估计 |
| 含什么 | 含噪声(数据不确定性) | 相对平滑、去噪(模型学到的模式) |
| 性质 | 硬目标(只有结果) | 软目标(隐含对数据规律的理解) |
例:预测未来 96 步电量
真实值:3500, 3512, 3498, 3605, 3511, ...(每步都有测量噪声/突发事件)
教师预测:3500, 3508, 3515, 3521, 3528, ...(平滑趋势线,体现"缓慢上升"的规律)
学真实值 = 连噪声一起拟合;学教师 = 学"规律"(归纳偏置/平滑先验)
为什么两者都要(κ_KD 平衡的意义):
L_task(学真实值):保证不过度偏离真实数据分布(防跑偏)
L_KD(学教师预测):获得结构先验/平滑归纳偏置(学规律)
κ_KD 就是两者配比——真实值防跑偏,教师教规律,各司其职
为什么不可靠域要关掉(RAAD 存在的理由):
可预测域(Traffic):数据有强规律 → 教师的平滑预测≈真实规律 → 学教师有用(消融 0.491→0.479 ✅)
不可预测域(Electricity/Weather):数据噪声大 → 教师也在拟合噪声 → 学教师=学错误(负迁移 ❌)
"教师不可靠"的本质:任务本身难预测,教师预测里没有可学的规律,只有噪声
第一道过滤器:数据集级 Macro Regime Switch(先看整体靠不靠谱)
用一个参数 控制“抄答案的总强度”,用验证集小实验试出来(不是拍脑袋定):
| Regime | 情形 | 策略 |
|---|---|---|
| Structure-Dominant | 这个数据集上老师逐点预测不可靠(如 Electricity/Weather) | :不抄答案,只学真实值 + 学思路(模块②) |
| Prediction-Dominant | 这个数据集上老师预测靠谱、有指导价值(如 Traffic) | :抄答案,但再过第二道过滤器 |
类比:挑培训班——这个老师整体教得好就多听他的,整体不行就只听他讲思路、不听他的答案。
κ_KD 具体怎么操作(插值开关)——看总损失:
| κ_KD | 学生主要学 | 场景 |
|---|---|---|
| 0 | 真实值 + 思路 | 老师不可靠,答案别抄 |
| 0.5 | 一半真实值、一半老师 | 折中 |
| 1 | 老师预测 + 思路 | 老师很可靠,放心抄 |
如何判断老师是否可靠(论文明确的方法):
① 直觉参考:SNR(信噪比)——数据可预测性的粗略指标
② 金标准:验证集小实验(validation sweep)
   固定学生架构和其他超参 → 试 κ_KD ∈ {0, 0.3, 0.5, 0.7, 1.0}
   → 选验证集误差最小的 κ_KD
   → 最优 ≈ 0:Structure-Dominant(不可靠,别抄)
   → 最优 > 0:Prediction-Dominant(可靠,抄)
论文原话:“SNR can serve as an intuitive descriptor of dataset predictability, but the final value of κ_KD is determined by validation performance”——试了才知道,不拍脑袋。
第二道过滤器:实例级 Micro Confidence Gating(再看每步靠不靠谱)
就算整体靠谱的数据集,老师也有“不会的题”——某些样本、某些预测步数(尤其预测得很远时)它也会瞎蒙。所以实时检测老师什么时候在瞎说:
| 符号 | 人话 |
|---|---|
| 第 i 个样本第 t 步:老师预测和真实答案差多远(偏差) | |
| 信任度:差得远 → e 大 → g 接近 0(不抄这步);差得近 → g 接近 1(放心抄) | |
| 敏感度:多严地惩罚老师的错误 |
带信任度的抄答案损失:
人话:学生抄老师答案时,每步都乘以信任度 ——老师这步靠谱就重点抄,不靠谱就少抄。 是“越远的预测越难”的补偿权重(远程预测本来就难,多给它一点监督)。
两道过滤器合起来
数据集级别:κ_KD ≈ 0 → 整个数据集不抄答案(只学思路)
            κ_KD > 0 → 进入实例级检查
实例级别:  g_{i,t} 小 → 这步不抄(老师在这步不靠谱)
g_{i,t} 大 → 这步放心抄类比总结:学霸不是全对——先选“这科的老师值不值得抄答案”(数据集级),再选“这道题老师会不会”(实例级)。两道过滤就是为了避免“抄到老师的错误”(负迁移)。
网络架构(冻结/未冻结标注)
注意:DSD 是学生-教师蒸馏框架——教师(PatchTST)冻结提供答案,学生(LMP-Net)训练做预测。没有检测论文的 backbone 冻结概念,学生全网络可训练。
训练时(双模型):
┌────────────────────┐      ┌────────────────────┐
│ 教师 PatchTST(❄️冻结) │      │ 学生 LMP-Net(🔥训练)  │
│ 输入 X               │      │ 输入 X               │
│ → 特征 F_T(patch)   │      │ → RevIN 归一化(🔇)  │
│ → 预测 Ŷ_T            │      │ → 分解(🔇):趋势+季节 │
│                      │      │   趋势:线性 W_trend(🔥)│
│                      │      │   季节:Expand(🔥)→Evolve(🔥)→Contract(🔥)
│                      │      │ → 特征 F_S = Z_E(🔥) │
│                      │      │ → 预测 Ŷ_S             │
└────────────────────┘      └────────────────────┘
         │ 特征对齐(模块②)      │ 预测蒸馏(模块③,按需)
         └────────── L_align ────┘

推理时:只用学生 LMP-Net(教师/模块②③全部退场)冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| 教师 PatchTST | ❄️ 冻结 | 预训练后固定,只提供特征/预测 |
| RevIN 归一化 / 分解 | 🔇 固定 | 无参数操作 |
| 趋势线性层 W_trend | 🔥 训练 | 学生趋势分支 |
| Expand / Evolve / Contract | 🔥 训练 | 学生季节分支(流形扩展) |
| 投影 g(SPKD)/ 投影 ψ(OT) | 🔥 训练 | 模块②的对齐投影层 |
| RAAD 门控 | 🔇 无网络参数 | κ 是超参、g 是公式计算 |
关键设计解读:
- 教师冻结是蒸馏惯例:PatchTST 预训练后固定,防止蒸馏过程中“参考答案漂移”;
- 学生全网络可训练:LMP-Net 本身轻量(0.18M),没有冻结必要;
- 推理 = 纯学生前向:模块②③只是训练损失,推理时零额外开销。
总目标
= 有监督预测损失(MSE); = regime 先验; = 结构对齐。结构蒸馏始终开,预测蒸馏按需开——这就是“鲁棒”的含义。
实验要点
设置:8 个数据集(ETT 家族 ×4、Electricity、Traffic、Weather、Exchange),look-back L=96,预测视野 H∈{96,192,336,720},默认教师 PatchTST,5 次重复取均值。
主结果:DSD 稳定提升学生(MSE 越低越好)
| 数据集 | 无 DSD | +DSD | 提升 |
|---|---|---|---|
| ETTh1 | 0.452 | 0.430 | -4.87% |
| Weather | 0.254 | 0.246 | -3.15% |
| Traffic | 0.490 | 0.479 | -2.24% |
效率(Table 2,H=720):
| 模型 | Params | MACs | Throughput | MSE (ETTh1) |
|---|---|---|---|---|
| PatchTST(教师) | 13.89M | 26.42G | 6,124 sps | 0.488 |
| DLinear | 0.14M | 0.03G | 74,744 sps | 0.510 |
| LMP-Net (DSD) | 0.18M | 0.08G | 96,398 sps | 0.472 |
学生 0.18M 参数/0.08G MACs,吞吐 9.6 万样本/秒——比教师快 15 倍、参数少 77 倍,精度反而超过教师(0.472 vs 0.488)。
消融(Table 3,按 regime 分组)关键发现:
| 发现 | 数据集证据 | 含义 |
|---|---|---|
| 流形扩展(Exp)普遍重要 | Traffic 去掉 Exp 误差 0.490→0.615 | 高维扩展是学生表达力的基础 |
| 结构对齐(Align)在结构主导域有用 | Weather 0.251→0.246 | 拓扑/几何蒸馏价值稳定 |
| 预测蒸馏(PredKD)只在特定 regime 有用 | Traffic 0.491→0.479(有用);Electricity 无变化(该关) | 实证支持 RAAD:“不是所有域都该蒸馏预测” |
对“蒸馏 + Single-DGOD”课题的迁移价值(重点)
| DSD 的方法 | 迁移到检测的机会 |
|---|---|
| 结构蒸馏 > 逐点匹配(Macro-SPKD) | 检测里别只做特征余弦对齐(CD-FKD 的弱点)——做样本间关系/实例关系蒸馏,对域偏移更稳 |
| Micro-OT 软对应 | 教师(大检测器)和学生(轻量检测器)特征粒度不同(FPN 多层 vs 单层)——用 OT 做软匹配代替硬对齐 |
| RAAD 负迁移防护 | 域偏移下教师特征也可能不可靠(雨夜教师也看不清)——加“置信度门控”:教师不可信时别蒸馏 |
| Regime 先验(验证集扫描) | 在 SDGOD 里:不同目标域用不同蒸馏强度(夜间域少蒸预测、白天域多蒸) |
| LMP-Net 流形扩展 | 轻量学生也需要表达力——扩展-演化-收缩结构可以直接设计进轻量检测骨干 |
一句话:CD-FKD 给你“蒸馏+SDGOD”的基线,DSD 给你“怎么蒸得更稳”的答案——结构对齐 + 软对应 + 按需蒸馏(防负迁移),三件套正好对应 CD-FKD 的三个弱点。
一句话总结
DSD 证明了两件事:蒸馏该传的是结构关系(拓扑/几何)而不是数值,教师不可靠时要敢关掉预测蒸馏(regime+置信度双层过滤)。配合 LMP-Net 的流形扩展,轻量学生(0.18M)能做到比 13.89M 教师更快更准——这套“结构蒸馏 + 防负迁移”方法论,是你在检测域做出比 CD-FKD 更稳方案的直接弹药。
相关资料
- 论文(ICML 2026, PMLR 306):ICML 官方页面 | OpenReview
- 代码:github.com/jyh0526/DSD