如果一个 100B 参数的大模型已经学会了一个任务,我们是否真的需要重新训练另一个小模型?
知识蒸馏(Knowledge Distillation)的核心思想,就是让小模型直接学习大模型已经总结出来的“知识”。
随着深度学习的发展,模型越来越大:参数越来越多 → 性能越来越强 → 计算成本越来越高 → 部署越来越困难。于是出现了一个非常现实的问题:**能不能把一个大模型的能力“压缩”到一个小模型里面?**这就是 Knowledge Distillation,简称 KD(知识蒸馏)。
Hinton、Vinyals 和 Dean 在 2015 年的经典论文 Distilling the Knowledge in a Neural Network 中系统推广了这一思想:将大型模型或者模型集成中的知识,转移到一个更容易部署的小模型中。
1. 核心思想:Teacher、Student 与 Soft Label
知识蒸馏中通常存在两个模型:Teacher Model(教师模型)——参数多、模型大、性能好、推理慢;Student Model(学生模型)——参数少、模型小、推理快、容易部署。整个过程可以简单理解成:
             Teacher(大模型 / 强模型)
                  │
                  │ 传递知识
                  ↓
             Student(小模型 / 轻量模型)
但真正的问题是:**Teacher 到底把什么“知识”传给 Student?**答案并不只是正确答案。
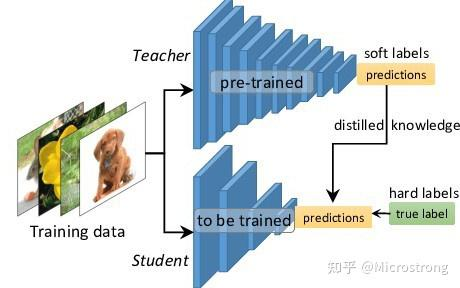
图片来源:知乎·知识蒸馏
传统监督学习给的是 Hard Label(one-hot),例如一张“马”的图片:。它只告诉 Student“这是一匹马”,却没有告诉模型“马和谁比较像”。
而一个训练得很好的 Teacher 可能输出 Soft Label:
对应:马 70%、驴 25%、狗 3%、汽车 1%、飞机 1%。Teacher 不只是知道“这是马”,还知道“它很像驴,但基本不像汽车和飞机”——这些类别之间的相似关系就是 Hinton 所说的 dark knowledge(暗知识)。
因此:Student 不只是学习“答案是什么”,还学习 Teacher 是如何看待这些答案的。
2. Temperature:把知识“软化”
神经网络分类器通常输出 logits ,经过 Softmax: 得到概率。但问题在于:训练良好的 Teacher 往往非常自信——例如 logits 经过 Softmax 后变成“马 99.3%、驴 0.7%、狗≈0%”,“驴比汽车更像马”这样的知识几乎消失了。
Hinton 引入了一个关键参数 Temperature(温度),修改 Softmax:
普通 Softmax 用 ,知识蒸馏通常用 。以 为例: 时分布非常尖锐,Teacher 几乎只告诉 Student“A”; 时实际上计算的是 ,分布平缓很多,Student 能看到“A 最像 → B 次之 → C 最不像”的相对关系——这些相对关系就是 Teacher 学到的知识。
概率分布更平滑。这个名字来自统计物理的直觉:温度低 → 概率集中、分布尖锐、模型非常确定;温度高 → 概率扩散、分布平缓、模型更加“不确定”。Temperature 实际控制的是概率分布的平滑程度。
3. 蒸馏损失:Soft Loss + Hard Loss
现在整个知识蒸馏过程就清楚了:Teacher 的 logits 经过带温度的 Softmax 得 ,Student 的 同样得 ,然后要求 ——Student 模仿 Teacher 的概率分布。
Soft Loss(蒸馏损失):
**但为什么还需要真实标签?**因为 Teacher 也会犯错。所以知识蒸馏同时保留两部分:
Hard Loss(普通监督):——告诉 Student“真正的正确答案是什么”;
Soft Loss(蒸馏):——告诉 Student“Teacher 是如何理解不同类别之间关系的”。
于是最终损失通常写成:
**为什么有一个 ?**很多教程直接给公式却不解释。我们把 变成了 ,所以当 增大时,Softmax 不仅变平滑,它对 logits 的梯度也会缩小。 就是在 Loss 层面对梯度尺度进行补偿——它不是为了软化概率(软化来自 ),这是两个不同的作用。
4. 为什么知识蒸馏有效?
为什么学习 Teacher 会比直接学习 Ground Truth 更好?因为 Ground Truth 给的信息太少。
Ground Truth:猫 = 1,其他 = 0
Teacher:    猫 0.70,老虎 0.15,狮子 0.10,汽车 0.003,飞机 0.002
Teacher 实际告诉 Student:猫很像老虎、比较像狮子、不像汽车、更不像飞机
这已经是一种 Representation Structure。Teacher 不只提供答案,而是在提供:类别关系、决策边界、数据结构、泛化规律。
一个很好的类比是老师批改试卷:普通监督学习只告诉学生“答案:B”;知识蒸馏则告诉学生“正确答案:B;A 看起来有点像但忽略了条件 X;C 方向基本正确但推导错了;D 完全不相关”。显然后者包含的信息更多——知识蒸馏真正传递的是 Teacher 对问题空间的理解。
5. 三类知识蒸馏:从“答案”到“表示”到“结构”
最经典的 Hinton KD 主要蒸馏 Logits(输出层)。但后来研究者发现 Teacher 的知识不只存在于最终答案,中间层也有大量知识。于是知识蒸馏逐渐发展成三大类:
第一类:Response-Based Distillation(响应/输出蒸馏)——经典 KD:Teacher logits → 概率分布 → Student logits,目标 。代表:Hinton KD。优点:简单,Teacher 和 Student 架构甚至可以完全不同。缺点:只利用最终输出。
第二类:Feature-Based Distillation(特征蒸馏)——既然 Teacher 中间层已经学到了很好的表示,为什么不直接学?
通过匹配 Teacher 和 Student 的中间表示,让 Student 学习比最终输出更加丰富的内部语义信息。代表:FitNets。
第三类:Relation-Based Distillation(关系蒸馏)——也许 Student 根本没必要复制 Teacher 的 feature,真正重要的是 Teacher 学到的结构关系。例如三个样本(猫 A、猫 B、汽车 C),Teacher feature space 中 ,Student 只需要保持这种关系 。可以蒸馏:pairwise distance、cosine similarity、angle、similarity matrix、correlation、graph structure。代表:Relational KD(Park et al.)。
| 类型 | Student 学什么 |
|---|---|
| Response KD | Teacher 怎么回答 |
| Feature KD | Teacher 怎么表示 |
| Relation KD | Teacher 怎么看关系 |
知识蒸馏的发展过程其实是:答案 → 表示 → 结构,越来越深入 Teacher 内部真正学到的知识。
6. 进阶扩展:Self-Distillation、大模型时代与模型压缩
Self-Distillation(自蒸馏):Teacher 一定需要比 Student 大吗?不一定,自己也可以蒸馏自己——同一个网络的 Deep Layer(Teacher)教 Shallow Layer(Student),或者上一代模型教下一代。现代 KD 研究把 self-distillation 与 cross-modal distillation、adversarial distillation 等一起视作传统 Teacher–Student KD 之外的重要扩展方向。
**为什么大模型时代 KD 又火了?**到了 LLM 时代:Teacher 是 GPT 级大型模型(几十 B / 几百 B 参数),Student 是 1B/3B/7B 小模型。Teacher 很聪明但推理贵、显存高、延迟大、部署困难;Student 能力稍弱但快、便宜、可以本地运行。今天的知识蒸馏已经从 CNN → CNN 扩展到:LLM → Small LLM、Vision Model → Mobile Model、Vision-Language Model → Lightweight VLM、Multimodal Model → Edge Model。
KD 与模型压缩:KD 可以放进整个模型压缩体系,与量化、剪枝并列:
             Model Compression
                    │
        ┌───────────┼───────────┐
        ↓           ↓           ↓
   Quantization   Pruning   Distillation
     (INT8/INT4)   (剪枝)    Teacher→Student
三者甚至可以一起使用:大模型 → KD → 小模型 → Pruning → Quantization → 端侧部署。
7. 从信息论重新理解:蒸馏 = 让概率世界逼近
和前面学过的 Entropy → Cross Entropy → KL Divergence 完全连接起来:
知识蒸馏的本质就是让 Student 的概率世界逐渐逼近 Teacher 的概率世界。这也是“蒸馏”这个名字非常形象的地方:不把 Teacher 整个复制过去,而是把其中真正有用的知识提取出来。
总结
知识蒸馏最核心的思想其实非常简单:
Student 不应该只学习正确答案,还应该学习 Teacher 对答案的理解。
知识蒸馏的发展路线:
Hard Label → Soft Target → Logit Distillation
  → Feature Distillation → Relation Distillation
  → Self / Cross-modal Distillation → LLM Distillation
而经典 KD 最值得记住的公式就是:
- Hard Loss:别忘了真正的答案;
- Soft Loss:学习 Teacher 的知识;
- Temperature :把 Teacher 隐藏的类别关系暴露出来;
- :补偿温度带来的梯度尺度变化。
知识蒸馏不是简单地把“大模型变小”,而是让小模型学习大模型已经形成的知识结构。
参考资料
- Hinton, Vinyals & Dean — Distilling the Knowledge in a Neural Network:https://arxiv.org/abs/1503.02531
- FitNets(Romero et al.):https://arxiv.org/abs/1412.6550
- Relational Knowledge Distillation(Park et al.):https://arxiv.org/abs/1904.05068
- Knowledge Distillation: A Survey(Gou et al.):https://arxiv.org/abs/2006.05525
- Categories of Response-Based, Feature-Based, and Relation-Based KD:https://arxiv.org/abs/2306.10687
- Bilibili 视频(同济子豪兄《精读 AI 论文·知识蒸馏》):https://www.bilibili.com/video/BV1gS4y1k7vj/
- RepDistiller(KD benchmark):https://github.com/HobbitLong/RepDistiller
- MMRazor(OpenMMLab 模型压缩工具箱):https://github.com/open-mmlab/mmrazor
延伸阅读
本文涉及的知识点与博客对应:
- KL 散度(蒸馏损失 L_soft 的数学本质就是 KL 散度):KL 散度
- 交叉熵与大模型(Hard Loss 的监督本质 + 概率视角):交叉熵与大模型
- CDSD 论文笔记(DIR 自蒸馏:Fdi 当老师蒸馏骨干中间层):CDSD(CVPR 2022)
- DSD 论文笔记(结构蒸馏:拓扑 SPKD + 几何 OT):DSD(ICML 2026)
- TimeDistill 论文笔记(跨架构蒸馏:多尺度 + 多周期):TimeDistill(KDD 2026)