论文:TimeDistill: Efficient Long-Term Time Series Forecasting with MLP via Cross-Architecture Distillation(KDD 2026) 作者:Juntong Ni、Zewen Liu、Shiyu Wang(Emory)、Ming Jin(Griffith)、Wei Jin(Emory) 定位:时间序列跨架构蒸馏(Transformer/CNN 教师 → MLP 学生)——老师给的方法论教材之二。核心价值:“跨架构怎么蒸”(多尺度+多周期)+ 理论视角(KD ≈ mixup 增广),直接对应“大检测器→轻量检测器”的迁移需求
背景:MLP 差在哪?(初步研究)
动机:Transformer/CNN 强但重;MLP 轻但弱。为什么弱?初步研究找原因:
① 多尺度模式(时域):同一序列按不同采样率看(细→粗)
   教师(Transformer/CNN)能抓"Scale 0(细粒度)到 Scale 3(粗粒度趋势)"
   MLP 在粗粒度(趋势)上明显偏离真实值

② 多周期模式(频域):把序列做 FFT 看频谱图
   低 MSE 的模型频谱更接近真实值的主导频率
MLP 频谱偏差大 → 抓不住周期性结论:MLP 弱是因为抓不住多尺度 + 多周期模式——蒸馏就把这两样从教师搬过来。
核心思想:跨架构 KD 框架(时域 + 频域双对齐)
通用目标(教师冻结):
| 项 | 人话 |
|---|---|
| 监督损失:学生预测 vs 真实值(必须对) | |
| 预测级蒸馏:学生预测 vs 教师预测 | |
| 特征级蒸馏:学生中间特征 vs 教师特征 |
两个蒸馏都在“预测级 + 特征级”双层面做:
多尺度蒸馏(时域):下采样对齐粗/细粒度模式
多周期蒸馏(频域):FFT 频谱对齐周期模式
└── 每个都在 预测级(输出对齐)+ 特征级(内部表示对齐)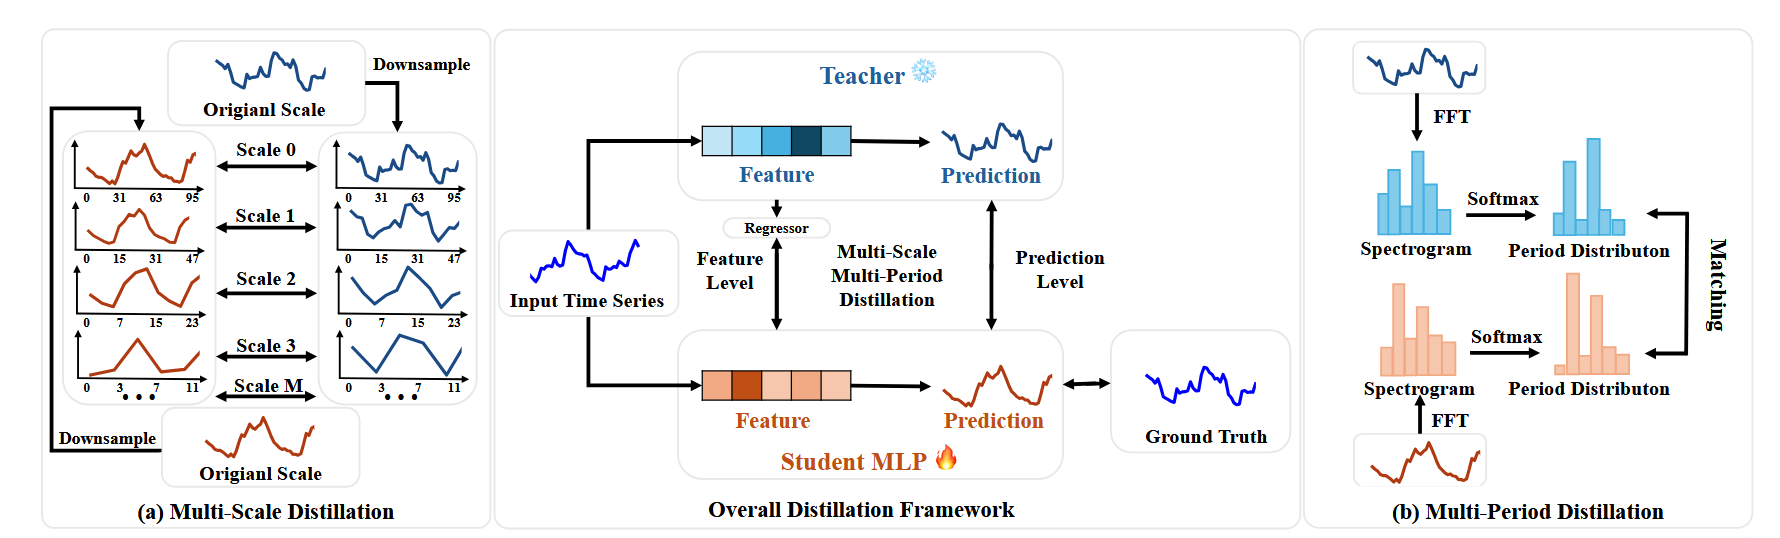
模块①:Multi-Scale Distillation(时域多尺度)
大白话:把预测/特征“越看越粗”(下采样 2 倍、4 倍…),每个粗细级别都对齐——学生不仅要预测对,粗看细看都得像教师。
预测级(公式 3-4)
下采样(1D 卷积 stride=2,逐级变粗):
每一次下采样都是在 1 前一轮的基础上做的,做两次卷积==下采样四倍,做的卷积次数越多,预测越粗
多尺度预测蒸馏(各级 MSE 平均):
Scale 0 = 原始预测(最细),Scale M = 最粗(只剩趋势)。学生每级都要跟上。
此外还有一个学生和真实值的损失
特征级(公式 5-6)
先对齐维度(学生/教师特征维数不同): (5) 其中 Regressor 是一种 MLP
然后同样多尺度下采样 + MSE:
模块②:Multi-Period Distillation(频域多周期)
大白话:把预测/特征做 FFT,看“哪些周期(频率)占主导”,让学生的“周期分布”对齐教师的——学生要学会“这个序列是 24 小时周期还是 7 天周期”。
FFT 频谱 + 冷温度 softmax → 周期分布:
公式 (7) 详解——把预测序列“拆成不同频率的成分”:
| 符号 | 是什么 | 人话 |
|---|---|---|
| 预测序列(H 步) | 一段随时间变化的波形 | |
| 快速傅里叶变换 | 把波形分解成不同频率的正弦波之和 | |
| 取振幅(模长) | 看每个频率的成分有多强 | |
| 振幅谱(频谱) | 每个频率一个数:对应周期在序列里多显著 |
具体例子(96 步预测):
预测 Ŷ = [y₁, y₂, ..., y₉₆]
   ↓ FFT → 分解成 96 个频率成分(复数:振幅+相位)
   ↓ Amp → 取模,利用对称性取一半、去掉 DC 分量
A = [a₁, ..., a₄₈],a_f 对应周期 = 序列长度 ÷ 频率(如频率 4 → 周期 96/4 = 24 步)
a 大 → 该周期显著(如电力数据 24h 日循环、168h 周循环)为什么取振幅不取相位:FFT 输出是复数(振幅+相位)。振幅 = 该频率成分有多强 → 代表“有哪些周期”(要对齐的);相位 = 波形位置偏移(不关心)。
流水线位置(公式 7→8→9/10):
预测序列 Ŷ → (7) FFT+Amp → 振幅谱 A → (8) softmax 冷温度 → 周期分布 Q → (9)(10) KL 对齐师生(冷温度)让分布“尖锐”,突出最重要的频率,抑制噪声频率。
KL 散度匹配周期分布(预测级 + 特征级):
网络架构(冻结/未冻结标注)
注意:TimeDistill 是跨架构蒸馏——教师(ModernTCN,CNN)和学生(纯 MLP)结构完全不同;教师冻结提供答案,学生全网络可训练。
训练时(双模型,跨架构):
┌──────────────────────┐      ┌──────────────────────┐
│ 教师 ModernTCN(❄️冻结) │      │ 学生 纯 MLP(🔥训练)     │
│ 输入 X(L 步)          │      │ 输入 X(L 步)          │
│ → 特征 H_T(patch)     │      │ → 特征 H_S             │
│ → 预测 Ŷ_T(H 步)       │      │ → 预测 Ŷ_S(H 步)       │
└──────────────────────┘      └──────────────────────┘
         │                              │
         └──── 蒸馏(训练期)────────────┘
   ① 多尺度(时域):预测/特征下采样(🔇固定)→ 逐级 MSE 对齐
   ② 多周期(频域):FFT(🔇)→ 冷温度 softmax → KL 对齐
   ③ 特征维度对齐:Regressor(🔥可学习 MLP)
   (预测级 + 特征级双层面)

推理时:只用学生 MLP(教师和蒸馏全部退场)冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| 教师(ModernTCN / iTransformer 等) | ❄️ 冻结 | 预训练后固定,只提供特征/预测 |
| 学生 MLP | 🔥 训练 | 轻量学生(7× 快、130× 小) |
| 多尺度下采样 Conv(stride=2) | 🔇 固定 | 用于生成多尺度视图(非训练模块) |
| FFT / 冷温度 softmax | 🔇 无参数 | 频域变换 |
| 特征 Regressor | 🔥 训练 | 学生特征 → 教师维度对齐 |
关键设计解读:
- 跨架构 = 师生结构不同:教师 CNN/Transformer、学生纯 MLP——蒸馏靠“多尺度+多周期”对齐,而不是结构复制;
- 教师冻结、学生全训:MLP 本身轻量,无需冻结;
- 推理 = 纯学生前向:蒸馏装置(下采样/FFT/Regressor)只存在于训练期,推理零额外开销(7× 提速)。
总损失 + 理论(KD ≈ mixup 增广)
理论卖点(Theorem 4.1 / 4.2)——完整陈述:
Theorem 4.1(多尺度版):
设 为原始数据对, 为教师数据对。定义增广函数 生成增广样本 ,增广损失 。当 实例化为 mixup(在原始数据与教师数据之间插值,混合系数 )时,有:
人话:联合优化“监督损失 + 多尺度蒸馏” ≈ 最小化“真实值 Y 和教师预测 Ŷ_T 按 λ 混合”的增广损失上界——混合系数 ,蒸馏越强(κ 大)教师占比越高。
Theorem 4.2(多周期版):
其中 (周期分布)。人话:频域版同样成立——混合的是“周期分布”而不是原始数值。
总结:蒸馏损失 + 监督损失 联合优化
   ≈ 最小化"特殊 mixup 增广"损失的上界
   mixup = 把真实值 Y 和教师预测 Ŷ_T 按 λ=1/(1+κ) 混合成新训练样本
为什么 mixup 视角有价值(三个好处):
- 增强泛化:混合样本 = 更丰富的监督信号,缓解过拟合(尤其数据少/噪声大时);
- 显式整合模式:混合目标里显式包含多尺度/多周期模式,真实值里看不出来;
- 稳定训练:软化的目标降低对噪声的敏感度,优化更平稳。
类比:蒸馏 ≈ “答案打折扣”的增广——和分类里的 label smoothing 同族。
实验要点
设置:8 数据集(ECL、ETTh1/2、ETTm1/2、Solar、Traffic、Weather),输入 720,预测 H∈{96,192,336,720};默认教师 ModernTCN(CNN);对比 8 个 baseline(iTransformer/PatchTST/FEDformer/Autoformer/ModernTCN/MICN/TimesNet/TimeMixer)。
主结果:7/8 数据集 MSE 最优,全部数据集 MAE 最优(Table 1,如 ETTh1 MSE 0.429 vs iTransformer 0.468)。
| 提升对象 | 幅度 |
|---|---|
| vs 教师(ModernTCN) | 最多 +5.37% |
| vs 无蒸馏 MLP | 最多 +13.87%(摘要口径 18.6%) |
| 换教师(iTrans/TimeMixer/PatchTST) | 超教师最多 +21.41% |
效率:MLP 学生 7× 推理加速、130× 少参数(vs baseline);vs Autoformer 196× 加速。
通用性:
- 不同教师:iTransformer / TimeMixer / PatchTST 都行(不绑定架构);
- 不同学生:TSMixer +6.26%、LightTS +8.02%、FITS +3.96%(能增强其他轻量模型);
- 不同 look-back:全部长度下都超教师。
与 DSD(LMPNet)对比——两篇时序蒸馏教材
| 维度 | DSD(ICML26) | TimeDistill(KDD26) |
|---|---|---|
| 蒸馏什么 | 结构关系(拓扑 SPKD + 几何 OT) | 多尺度 + 多周期(时域下采样 + 频域 FFT) |
| 防负迁移 | ✅ RAAD(regime+置信度门控) | 无显式机制(靠软目标天然平滑) |
| 理论 | 无 | ✅ KD ≈ mixup 增广(Theorem) |
| 学生 | LMP-Net(线性+MLP) | 纯 MLP |
| 特色 | 教师不可靠时会说不 | 时域+频域双视角、跨架构通用 |
对“蒸馏 + Single-DGOD”课题的迁移价值(重点)
| TimeDistill 的方法 | 迁移到检测的机会 |
|---|---|
| 跨架构蒸馏(Transformer/CNN → MLP) | 大检测器(DINO/扩散)→ 轻量检测器——CD-FKD 教师学生同构,这是空白 |
| 多尺度蒸馏(下采样多级对齐) | 检测的 FPN 天然多尺度!教师 FPN 各层 ↔ 学生 FPN 各层对齐(比 CD-FKD 只对齐最后一层强) |
| 频域蒸馏(FFT 周期分布) | 检测里对齐“频谱分布”可增强对模糊/纹理域偏移的鲁棒性(呼应 Cauvis 的傅里叶思想) |
| 预测级 + 特征级双层面 | 检测对应:检测头输出对齐 + backbone 特征对齐 |
| 理论视角(KD ≈ mixup) | 给你的蒸馏损失提供理论包装,审稿人加分项 |
一句话:DSD 教你“蒸得稳”(防负迁移),TimeDistill 教你“蒸得全”(多尺度+多周期+跨架构+理论)——两个教材合起来,就是“大检测器→轻量检测器”完整蒸馏方案的设计蓝图。
一句话总结
TimeDistill 用多尺度(时域下采样)+ 多周期(频域 FFT)两种视角,在预测级和特征级双层面把 Transformer/CNN 教师的知识蒸馏进纯 MLP 学生——7/8 数据集 MSE 最优、7× 更快、130× 更小,还给出“KD ≈ mixup 增广”的理论解释。它是“跨架构蒸馏 + 时频双域对齐”的方法论范本,正好补上你课题里“大检测器→轻量检测器”最缺的一环。
相关资料
- 论文(KDD 2026):ACM DOI
- 代码:github.com/LingFengGold/TimeDistill