论文:Towards Single-Source Domain Generalized Object Detection via Causal Visual Prompts(NeurIPS 2025) 作者:Chen Li、Huiying Xu(共同一作)、Changxin Gao、Zeyu Wang、Yun Liu、Xinzhong Zhu(通讯) 单位:华中科技大学 / 浙江师范大学 / 西北工业大学 / 南开大学 ⚠️ 定位:非武老师课题组(武阿明只是其基线 CDSD 的作者,勿混淆)。与“模拟派”(SE-COT/MR-DCoT/LTFE 靠造未知域样本)对立的因果干预派——不造任何合成数据,冻结 DINOv2 + 视觉提示抑制伪相关
背景:单源域训练会记住“伪相关”(Section 3.1 控制实验)
问题:单源域训练的模型会依赖统计捷径(spurious correlation)而非物体的因果特征:
颜色偏置:卡车几乎都是白色 → 模型用"白色"判断"卡车"
位置偏置:车辆居中、行人靠边 → 模型用位置判断类别
背景偏置:背景与类别共现控制实验(证明问题存在):选 bus/truck 两类(跨域多为白色),人为把“白色→truck”的关联概率 从 0.75 提到 0.9 构造有偏数据集:
| 指标 | 结果 | 含义 |
|---|---|---|
| 有偏测试精度 | 随 上升 +4.2% | 模型越来越依赖颜色捷径 |
| 无偏测试 Truck mAP | 暴跌 21% | 颜色捷径在真实世界失效 |
结论:模型在有偏集上越“好”,在无偏/未知域上越差——这就是 Single-DGOD 泛化失败的根源之一。
核心思想:因果视角(Section 3.2)
特征分解:输入特征 = 因果部分 + 伪部分 。目标:对 敏感、对 鲁棒。
视觉提示 = 对低频成分的微小扰动(因果不变性证明):
- 一阶泰勒展开:提示扰动 足够小时,因果特征变化可忽略——提示不破坏因果结构;
- 傅里叶视角:提示扰动集中在低频,因果滤波器 对低频响应≈0——同样不影响因果特征;
- 所以提示只扰动伪特征(颜色/背景/光照),逼模型把注意力放在因果特征上。
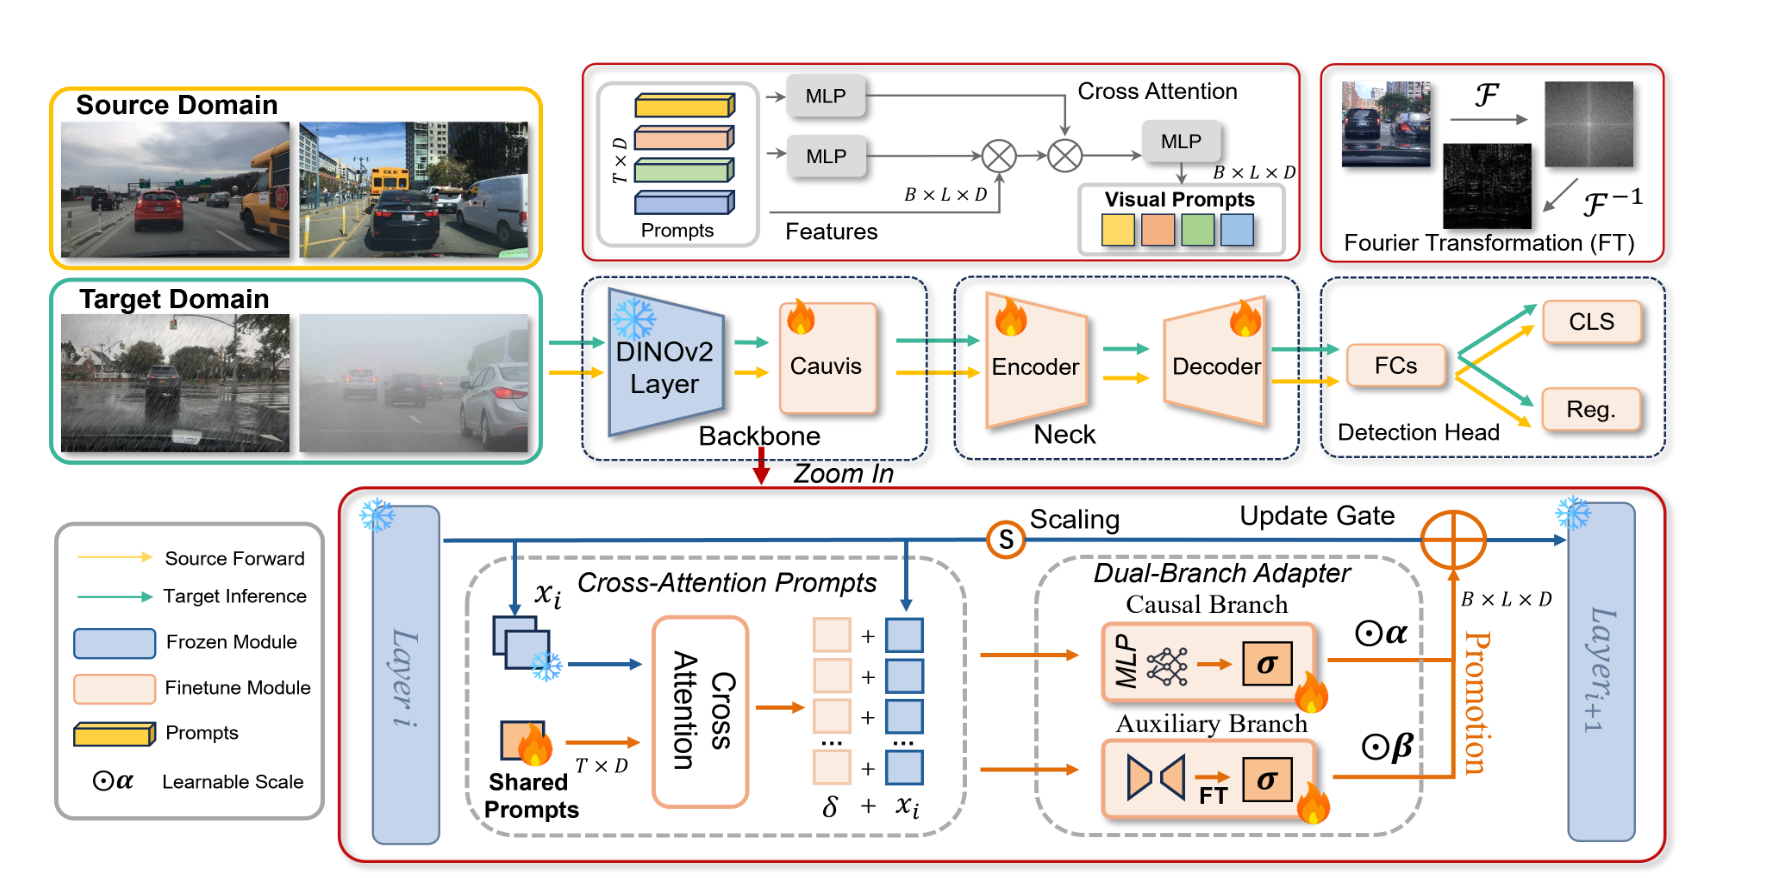
方法①:Cross-Attention Prompts(4.1,核心创新)
大白话:把“视觉提示”当成一个独立于图像域的伪模态信号,用交叉注意力让它和图像特征互相看——提示负责“挡住伪相关方向”,图像只能从提示没挡住的方向提取特征。
SVD 因果子空间分解:对注意力矩阵 做奇异值分解:
- top-k 大奇异值方向 = 因果子空间(特征的本质结构,如物体轮廓)
- 小奇异值方向 = 伪相关/噪声(颜色、背景等捷径)
- 用软阈值(惩罚 范数)让网络自然把权重放在因果子空间,避免硬截断 k
后门调整等价性(理论卖点):
论文证明:交叉注意力提示机制等价于 Pearl 后门调整(back-door adjustment)——提示方向张成混淆因子空间 Z,交叉注意力聚合 后,非因果路径被阻断,等价于对 X 做干预 ,从而抑制伪相关。
shared prompt 详解
它是什么、怎么来的:
初始化:随机噪声(或零初始化)——"prompt vectors are just random noise"
维度:t 个 prompt token,每个 d 维(P ∈ R^{t×d})
更新:训练时用标准检测损失(交叉熵)反向传播更新
本质:独立于图像域的【可学习参数】,不来自任何图像/数据集
“shared” = 跨层共享(论文 Prompt Length 消融,Fig. 4 right):
| 变体 | 含义 | 100 tokens 时 mAP |
|---|---|---|
| layer-wise | 每一层各有一套提示参数 | 59.7% |
| shared(默认) | 所有层共享同一套提示参数 | 59.8% |
两者几乎持平 → 论文推荐 shared(省参数且略好)。提示长度消融:约 100 tokens 为性价比最优(59.8%),对齐序列长度 L_seq(~1600 tokens)最高 59.9% 但计算成本暴涨。
交叉注意力的 Q/K/V 分工(附录 E):
Q = X·Wq   ← 来自图像特征 X(query)
K = P·Wk   ← 来自提示 P(key)   —— 提示当"被查询的库"
V = P·Wv   ← 来自提示 P(value)
A = QKᵀ/√d → softmax → 对 t 个提示槽加权求和
输出 = Σ 注意力权重 × 提示的 value作用(三个层面):
- 充当混淆因子(confounder)的编码器:提示的 key = 各种 confounder 状态 z(颜色偏置、背景、光照)的表示;注意力对提示的加权求和 = —— 正是后门调整对 z 求期望的操作(“prompt keys act like a representation of confounder states Z”);
- 提供因果过滤器:配合 SVD 软阈值,提示被训练成只落在因果子空间(),注意力更新退化为只沿 top-k 因果方向——图像从提示里只能拿到因果信息;
- 引导因果不变性:优化使 ,无法驱动因果不变的提示会被剪枝/重初始化。
“清洗”机制总结(特征净化的分工):
prompt = 被查询的"过滤库"(只放因果方向,训练塑形后的结果)
交叉注意力 = 执行查询(决定每个位置从库里取什么)
SVD 软阈值 = 过滤器(小奇异值=伪相关方向 → 压成 0)
洗掉:颜色/背景/光照等伪相关成分;留下:轮廓/结构/类别本质
类比:shared prompt = 一张跨层共用的“作弊禁止清单”,图像特征在注意力里查这份清单,和清单条目(伪相关方向)对齐的成分被扣掉,只留“清单之外的干净信息”(因果特征)。
方法②:Dual-Branch Adapter(4.2)
动机:零样本(SDGOD)比 few-shot 更难——提示在 SDGOD 只 +2.6%(NC),few-shot 有 +4.1%,需要额外适配器补足泛化差距。
与方法①的衔接(关键):方法①的输出就是方法②因果分支的输入——一个“清洗”、一个“翻译+补滤”:
方法①(Cross-Attention Prompts)
   图像特征 X + 提示 p_i
       ↓ 交叉注意力
   p̃_i = CAP(p_i, X)          ← 交叉注意力激活(清洗后的信息载体)
       ↓
方法②(Dual-Branch Adapter)
   ├── 因果分支:y_i = σ(MLP(p̃_i))       ← 输入是 p̃_i(方法①的输出!)
   └── 傅里叶分支:Z → FFT → 滤波          ← 输入是 backbone 特征 Z(不是 p̃_i)
       ↓
   两分支输出合并 → 供检测头使用
⚠️ 两个分支的输入不一样:
| 分支 | 输入 | 来源 | 抓什么 |
|---|---|---|---|
| 因果分支(MLP) | 方法①的交叉注意力激活(公式 9) | 局部空间模式 + 因果语义(空间域) | |
| 傅里叶分支(FFT) | (backbone 中间特征图) | 原始 backbone 特征(未经提示交互) | 域不变频谱结构(频域),互补视角 |
设计原因:因果分支吃“清洗后的激活”(已过滤伪相关、携带因果语义);傅里叶分支吃“原始特征”,在频域独立再滤一遍域伪影。空间域 vs 频域互补,共享同一分类器(无额外损失,靠结构先验分工)。
双分支结构:
| 分支 | 做法 | 作用 |
|---|---|---|
| 因果分支 | MLP 把交叉注意力激活映射成因果特征(sigmoid 归一化) | 显式建模因果语义,关注物体本质 |
| 辅助分支(傅里叶) | 对 backbone 特征做 2D DFT,幅度/相位滤波(低通、幅度阈值) | 提取域不变结构(相位稳定、幅度易变),抑制色偏/光照/纹理等域伪影 |
网络架构(冻结/未冻结标注)
输入图像(源域)
   ↓
DINOv2 Backbone(❄️ 冻结,ViT-L/14)
  每一层 block:
    图像特征 X
      ↓
    Cauvis 模块(【嵌入每一层】):
      X ── 交叉注意力 ──← 视觉提示 P(🔥,~1% 参数)
      → 提示激活 p̃_i
      → 因果分支 MLP(🔥)→ 因果特征 y_i
      → 傅里叶分支:FFT(🔇 无参数)+ 滤波
      → 合并 → 继续下一层
   ↓
DINO 检测头(🔥)
   ↓
预测框 + 类别冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| DINOv2 Backbone(ViT-L/14) | ❄️ 冻结 | 基础模型红利的主要来源(消融显示去掉后 Avg 掉 20+) |
| 视觉提示 P | 🔥 训练 | ~1% 可学习参数的核心 |
| 交叉注意力投影 | 🔥 训练 | 提示与图像交互 |
| 因果分支 MLP | 🔥 训练 | 映射提示激活 → 因果特征 |
| 傅里叶分支(FFT + 滤波) | 🔇 固定 | 傅里叶变换无参数;掩码/滤波基本固定 |
| DINO 检测头 | 🔥 训练 | 标准检测组件 |
关键设计解读:
- 只调 ~1% 参数:整个 Cauvis 只训练提示 + 适配器 + 检测头,DINOv2 完全冻结——训练极省;
- Cauvis 模块嵌入每一层:每层 block 都有一份提示/适配器(交叉注意力查询提示、双分支提取),“清洗”贯穿整个骨干;
- 训练/推理无不对称:推理时 Cauvis 模块照常前向(参数固定)——没有“训练用、推理关”的装置(对比 MR-DCoT 关 Dual-CoT、LTFE 减步数)。
训练特点(很省)
骨架:DINOv2 ViT-L/14(冻结,只调 ~1% 可学习参数)+ DINO 检测头
损失:只用标准检测损失(交叉熵)
     【不加】显式解耦损失 / 对抗损失 / 合成样本 —— 靠结构先验让网络自然分工
训练:AdamW,12 epochs,lr 1e-4,batch 16(8×RTX 4090),AMP
提示长度:12(prompt length)
训练 vs 推理:没有不对称设计(Cauvis 的结构特色)
论文没有专门的 inference 小节——因为推理 = 训练时的同一条前向路径,只是参数固定。提示和双分支适配器就是网络结构的一部分,推理时照常工作(“清洗”是前向操作,不需要测试时额外处理)。
| 维度 | 训练 | 推理 |
|---|---|---|
| 前向路径 | backbone → 每层 Cauvis 模块(交叉注意力 + 双分支)→ 检测头 | 完全相同(模块还在!) |
| 提示 + 适配器 | 参与前向,被训练(只调 ~1%) | 参与前向,参数固定 |
| DINOv2 backbone | 冻结 | 冻结 |
| 损失 | 标准检测损失反向传播 | 无损失、无梯度 |
| 测试时操作 | — | 无(不演化、不调整、不重算) |
和模拟派三篇的不对称设计对比:
| 方法 | 训练 | 推理 | 不对称? |
|---|---|---|---|
| Cauvis | 完整前向(清洗机制在) | 同样的完整前向(参数固定) | ❌ 无不对称 |
| MR-DCoT | 双流输入(Fp + Fe) | 单流(只用 Fp),关 Dual-CoT | ✅ 有(训练重、推理轻) |
| LTFE | T=8 全轨迹演化 | T=2 轻量演化(测试时自适应) | ✅ 有(程度不同) |
| SE-COT | 风格演化造样本 | 标准前向(演化只在训练) | ✅ 有 |
原因:模拟派把泛化能力“训练时练出来”→ 推理时要关掉造样本装置;Cauvis 把“清洗”做成网络结构本身 → 推理时每层天然在过滤。类比:模拟派像“训练时健身、上场靠肌肉”,Cauvis 像“随身净水器,每时每刻过滤”。
推理成本:标准检测前向 + 每层交叉注意力 + FFT——无测试时额外开销(与 MR-DCoT 同属“零测试时操作”派),但比纯 baseline 多提示/适配器的轻量前向(~1% 参数)。
创新点总结(与模拟派对比)
| 维度 | SE-COT / MR-DCoT / LTFE | Cauvis |
|---|---|---|
| 路线 | 模拟派:造未知域样本(文本/扩散/时序) | 因果干预派:不造数据,抑制伪相关 |
| 关键工具 | CLIP/ChatGPT、扩散、LSTM/ODE | DINOv2、交叉注意力、傅里叶 |
| 骨干 | Res101/Swin(要训练) | DINOv2 冻结(只调 1%) |
| 核心假设 | 多模拟 → 见多识广 | 靠因果特征 → 免疫捷径 |
| 合成数据 | 需要 | 零合成 |
| 理论 | 流形/时序假设 | 因果 + 后门调整(Pearl) |
实验
设置
- 基准:SDGOD(Diverse-Weather,Day Clear 训练)+ Cityscapes-C(损坏鲁棒性)
- 检测器:DINO(损坏实验用 Faster R-CNN 保证公平);骨干 DINOv2 ViT-L/14 冻结
主结果(Table 2,mAP%)
| 方法 | Day Foggy | Dusk Rainy | Night Rainy | Night Clear |
|---|---|---|---|---|
| UFR (Res101) | 39.6 | 33.2 | 19.2 | 40.8 |
| FR + DINOv2(w/o Cauvis) | 50.6 | — | — | — |
| Cauvis (Ours) | 56.5 | 64.6 | 47.6 | 61.2 |
⚠️ 注意公平性:Cauvis 的高分包含 DINOv2 冻结骨干的“基础模型红利”——消融显示去掉 DINOv2(退化为 Faster R-CNN 基线)Avg 从 60.7 掉到 34.2。与 Res101 系方法比数字时要小心。
消融(Table 5)
| 配置 | Day Clear | DF | DR | NR | NC | Avg |
|---|---|---|---|---|---|---|
| w/o DINOv2(Baseline) | 54.5 | 35.2 | 29.8 | 14.1 | 37.4 | 34.2 |
| w/o Visual Prompts | 66.9 | 50.5 | 57.0 | 42.1 | 54.8 | 54.3 |
| w/o Cross-Attention Prompts | 70.5 | 53.3 | 60.0 | 45.5 | 57.6 | 57.4 |
| w/o Dual-Branch Adapter | 73.0 | 55.1 | 62.8 | 48.5 | 59.4 | 59.8 |
| Full Model (Cauvis) | 73.7 | 56.5 | 64.6 | 47.6 | 61.2 | 60.7 |
三件套都有收益;DINOv2 冻结骨干贡献最大(+20.1 Avg),其次提示(+3.1)、交叉注意力(+3.1)、双分支(+0.9)。
其他亮点
- 源域 Day Clear 73.7:超第二 UFR(58.6)15.1 个点,7 类全第一——强源域 + 强泛化正相关
- 损坏鲁棒性(Cityscapes-C):mPC 超此前 SOTA(OA-DG)13.8 个点(用 Faster R-CNN 保证公平)
- 跨 VFM 通用:EVA02 / SAM / DINOv2 上 +Cauvis 都优于 +VPT/EVP/AdaptFormer/Rein 等 PEFT 方法
- 零样本 vs few-shot:SDGOD 提示增益小于 CD-FSOD(+2.6% vs +4.1%),说明零样本更难——双分支适配器的存在必要
一句话总结
Cauvis 从因果视角重新审视 Single-DGOD:单源域训练的病根是模型记住伪相关(颜色/位置/背景捷径)。它冻结 DINOv2,用交叉注意力视觉提示(理论等价 Pearl 后门调整)抑制伪相关方向,用傅里叶双分支适配器提取域不变高频结构,全程不造合成数据、只调 1% 参数——用“因果干预”对抗“模拟覆盖”,是武老师组三篇之外的另一极。
相关资料
- 论文 arXiv:arXiv:2510.19487
- 代码仓库:github.com/lichen1015/Cauvis