论文:Simulating Distribution Dynamics: Liquid Temporal Feature Evolution for Single-Domain Generalized Object Detection(arXiv 2511.09909 / AAAI 2026) 作者:Zihao Zhang(天津大学)、Yang Li(天津大学)、Aming Wu*(合肥工业大学,通讯)、Yahong Han(天津大学) 定位:武老师组“模拟派”的第三条技术路线——甩开文本/VLM,回到纯视觉时序演化:把域偏移建模成“特征随时间连续演化”的过程,用 LSTM + Neural ODE/液态神经网络(LNN)动态生成卷积核
背景:为什么“离散模拟”不够了
批判对象(两个):
① 离散数据增强(DIV/UFR 等):一次性扰动,捕捉不到连续渐变
② 静态文本 prompt(SE-COT 等 VLM 方法):
    - 同样是"静态"的,描述不了连续演化
    - 依赖目标域的文本先验(如 rainy night 的描述)
- 这与 Single-DGOD 的假设冲突:目标域是【未知】的,哪来的文本先验?核心观察:真实域偏移是连续、渐进的——晴 → 多云 → 雨,特征分布是“流动”的,不是跳变的。
两条动机:
- 连续性可建模:渐进高斯扰动(模糊逐渐加强、噪声逐渐衰减)可以模拟特征从源域到目标域的流动轨迹;
- 液态神经网络(LNN)天生动态:LNN 的 ODE 式连续演化适合“根据时序信息动态调整演化路径”。
核心思想:连续时序特征演化(LTFE)
流程总览(对应论文 Fig. 2 / Algorithm 1):
F0(backbone 第 1 层特征)
  ↓ PTFE:迭代扰动(模糊↑ + 噪声↓)→ 特征序列 {F1,...,FT}
  ↓ TDM:LSTM 建模时序依赖 → 时序编码 {Ht}
  ↓ LPE:Neural ODE/LNN 动态生成卷积核 Wt → 调整特征 → {F̂t}
  ↓ TFAM:类内一致 + 类间可分,保证演化不毁语义
↓ F̂T → backbone 2~4 层 → RPN → 检测实验证明:在第一层特征上演化、再用它生成 2~4 层效果最好(和 SE-COT/MR-DCoT 的选择一致——浅层=风格/退化信息)。
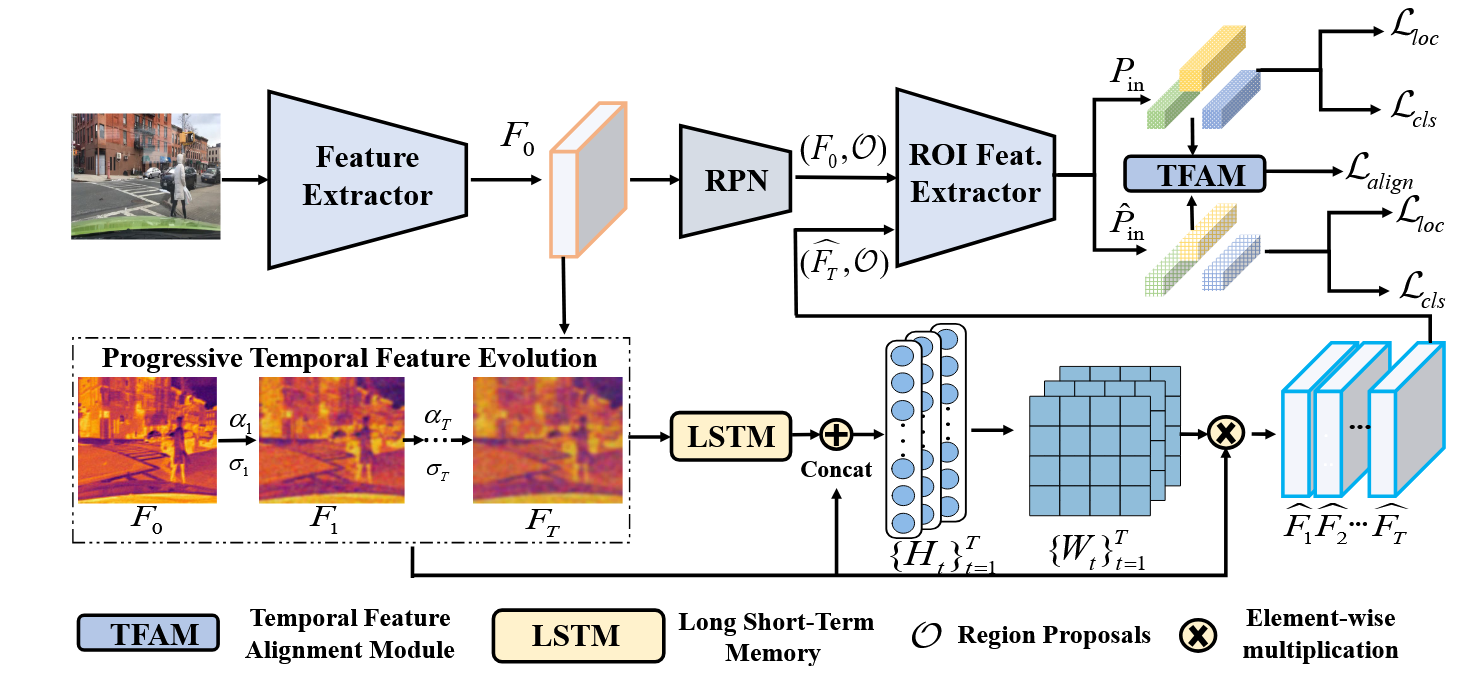
模块①:PTFE——渐进时序特征演化
大白话:把“晴天→雨夜”的渐变,模拟成对特征图做 T 步的“逐渐变糊 + 逐渐加噪(但噪声快速衰减)”的迭代。
两个对抗的调度(模拟“从精细到粗糙”的真实退化):
| 项 | 公式 | 行为 | 直觉 |
|---|---|---|---|
| 噪声强度 | ,, (3) | 指数衰减 | 噪声是“启动扰动”,很快退场 |
| 模糊强度 | ,, (4) | 指数增长 | 模糊是“主导退化”,逐渐加强 |
第一项 逐步模糊模拟视觉退化;第二项 注入快速衰减的高斯噪声。
模块②:TDM——时序依赖建模
大白话:特征序列不是一堆独立的图,而是“一条演化轨迹”——用 LSTM 记住“之前演化到哪了”,让每一步演化都参考历史。
- (5) LSTM:隐藏态 抓当前步抽象,细胞态 存长期记忆
- (6) 特征-状态融合:把 LSTM 记忆和原始特征拼接投影 → 时序编码 ,捕捉从 到 的演化模式
模块③:LPE——液态参数演化(核心中的核心,“Liquid”的真正含义)
大白话:域偏移越大,特征就演化得越“久”、卷积核就变得越“远”——用一个连续动态系统(Neural ODE)按需生成卷积核,而不是固定核。
ODE 动态生成卷积核:
- :向量场,用**液态神经网络(LNN)**实现——卷积核沿虚拟时间 连续演化
- :初始核(继承 Faster R-CNN 预训练权重)
- 求解器:四阶 Runge-Kutta(RK4)
演化时间自适应(最妙的设计):
由当前时序编码的 L2 范数归一化决定——时序偏差越大( 大)→ 核演化越久 → 对显著域偏移的适应性越强。
残差调整(保语义):
- 用动态生成的 核卷积原始特征 ,残差连接保留原始语义
- 训练时生成全序列 ;推理只用 (中间步是给 LSTM 学演化动力学的)
模块④:TFAM——时序特征对齐
大白话:演化不能把语义演丢了——同一个物体,演化前和演化后必须是“同一个东西”(类内一致),不同类之间还得分得开(类间可分)。
做法:F0 喂 RPN 出候选框 O,F0 和最终特征 分别 ROI 出实例特征 和 :
| 损失 | 大白话 |
|---|---|
| (11) | 演化前后同一个实例特征要近(别演着演着变样了) |
| (12) | 不同实例特征要远(类别可分性保持) |
网络架构(冻结/未冻结标注)
⚠️ 与 SE-COT/MR-DCoT 不同:LTFE 没有冻结 backbone——论文未提任何冻结/CLIP 初始化,整个网络端到端训练(SGD,20 epochs)。
输入图像(源域)
   ↓
Backbone 第 1 层(🔥 训练)→ F0
   ↓(拦截:F0 转去旁路加工)
┌──────────────────────────────────────────────┐
│ 旁路加工(LTFE 核心)                          │
│ ① PTFE:迭代扰动(高斯模糊 🔇 + 噪声)          │
│    → 特征序列 {F1...FT}                        │
│ ② TDM:LSTM(🔥)→ 时序编码 {Ht}              │
│ ③ LPE:Neural ODE/LNN 向量场 f(🔥)           │
│    → 动态生成核 Wt = ODESolve(f, W0, Ht, τ̂)   │
│    → F̂t = Conv2D(F0, Wt) + F0(🔥)           │
│ ④ TFAM:类内一致 + 类间可分(对齐损失)          │
└──────────────────────────────────────────────┘
   ↓(续走:推理时只演化 T=2 步)
Backbone 第 2~4 层(🔥 训练)→ RPN → 检测头(🔥)
   ↓
预测框 + 类别冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| Backbone(全部) | 🔥 未冻结 | 论文未提冻结,端到端训练 |
| 高斯模糊核 G(σ) | 🔇 固定 | 高斯核函数,无参数 |
| LSTM(TDM) | 🔥 训练 | 时序依赖建模 |
| LNN/ODE 向量场 f(LPE) | 🔥 训练 | 动态生成卷积核 |
| 初始核 W0 | 🔥 训练 | 继承预训练 Faster R-CNN,继续优化 |
| RPN + 检测头 | 🔥 训练 | 标准检测组件 |
关键设计解读:
- 全网络可训练:没有冻结层(与 SE-COT 冻结 1-3 层、MR-DCoT 冻结 CLIP 权重不同)——LTFE 的卖点是“演化动力学”整体学习,不需要冻结主干保语义;
- 预训练知识只在 W0:初始卷积核继承 Faster R-CNN 预训练权重,作为 ODE 演化的起点;
- 推理也走旁路:推理时 T=2 步演化(LSTM/LNN 前向参与)——和其他论文“推理零开销”不同,这是“测试时特征自适应”。
总损失与训练/推理
| 阶段 | 行为 |
|---|---|
| 训练 | T=8 步演化(充分模拟演化轨迹);端到端优化,动态核由 ODE 生成 |
| 推理 | 只演 2 步(T=2)——真实测试样本已处于某种偏移状态,2 步是轻量补偿;LNN/ODE 前向生成核,不更新任何参数(测试时特征自适应,非测试时训练) |
推理成本:Table 4 显示 Ours(Res101) 6.4 FPS / 325G FLOPs——比 UFR(6.9 FPS)略慢但远快于 C-Gap(2.5)/ PDOC(2.2),且 mAP 更高。
训练 vs 推理路径对比(Algorithm 1)
训练(T=8):
F0 → PTFE 8 步 → {F1...F8} → LSTM 完整序列建模(学动力学)
     → 每步 ODE 生成核 {W1...W8} → 调整出 {F̂1...F̂8}(全序列)
     → L_cls + L_reg + L_align 反向传播,更新所有参数

推理(T=2):
F0 → PTFE 2 步 → {F1, F2} → LSTM 前向 2 步(只用,不学)
     → 生成 1 个核 W_test → 调整出 F̂2
→ 直接分类+定位(无损失、无梯度、无参数更新)| 维度 | 训练 | 推理 |
|---|---|---|
| 演化步数 | T=8(充分模拟完整轨迹) | T=2(轻量补偿) |
| LSTM | 处理完整 8 步序列,权重参与训练(学演化动力学) | 前向跑 2 步得到 H_t,只调用不学习 |
| 卷积核 | 每步 ODESolve 生成 8 个核 {W₁…W₈},调整出全序列 F̂₁…F̂₈ | 只生成 1 个核 W_test,调整出最终特征 F̂₂ |
| 损失/梯度 | L_cls + L_reg + L_align 全部反向传播 | 无梯度、无参数更新 |
| 目的 | 让模型见过“从源域到深层退化”的完整轨迹,学会演化+适应动力学 | 把测试特征推回模型熟悉的分布区域,轻量对齐 |
为什么推理只要 2 步就够了?
训练 8 步:源域 F0 是"干净的",要一路演到深层退化 → 让模型见过完整轨迹
推理 2 步:真实测试样本【本身已经处于某种偏移状态】(它已经是雨夜了!)
           → 不需要从头演到底,只需要"沿着学过的演化方向轻推 2 步"
           → 把特征推回"训练时见过的分布区域"里,检测就稳了
论文原话:推理时做 “limited perturbations to fine-tune adaptation to the real target domain and bridge the gap between simulated training and true distributions”——注意是 fine-tune(微调补偿),不是重新演化。步数再多会破坏目标域语义。
“测试时自适应”自适什么?(容易误解)
- 推理核是输入自适应的:每个测试样本根据它自己的演化状态(H_t 的 L2 范数)决定演化时间 ,生成自己的核
- 偏移大的样本 → 大 → 核演化久 → 调整幅度大;偏移小的样本 → 调整小
- 所以“自适应” = 参数不动(不是 TTT),但每个样本的处理强度不同(输入条件化)
与 MR-DCoT 推理的设计取舍:
| LTFE | MR-DCoT | |
|---|---|---|
| 推理 | 2 步特征演化(有前向成本,换来输入自适应) | 零开销标准前向(训练练好的静态鲁棒) |
| 自适应方式 | 测试时按样本动态调整(输入条件化核) | 无(靠训练内化的纠错能力) |
| 代价 | 6.4 FPS(Table 4) | 推理零额外开销(Table XIII) |
创新点总结(与 SE-COT / MR-DCoT 对照)
| 维度 | SE-COT (CVPR25) | MR-DCoT (TPAMI26) | LTFE (AAAI26) |
|---|---|---|---|
| 范式 | 文本模拟 | 模拟+流形回归 | 连续时序模拟(纯视觉) |
| 文本/VLM | ✅ CLIP+ChatGPT | ✅ 双链用文本 | ❌ 完全不用 |
| 扰动方式 | AdaIN 风格注入 | 扩散模糊+U-Net | 渐进模糊+噪声迭代(PTFE) |
| 自适应机制 | 静态学 (μ,σ) | 文本预测 (μ,σ) | Neural ODE/LNN 动态生成卷积核 |
| 时序建模 | 无 | 无(只有链式) | ✅ LSTM(TDM) |
| 纠错/对齐 | 原型增强内容 | 原型锚定投影 H | TFAM 类内/类间对齐 |
| 推理 | 标准前向 | 标准前向(零开销) | 2 步演化(测试时特征自适应) |
实验
设置
- 基准:Diverse Weather(只训 Day Clear)+ Real-to-Art(VOC → Clipart/Watercolor/Comic)
- 检测器:Faster R-CNN;骨干 Res50 / Res101 / Swin-T
- 训练:SGD(momentum 0.9)20 epochs,lr 0.02,2×RTX 3090,输入 800×800;训练 T=8,推理 T=2
主结果(Table 1,mAP%)
| 方法 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| Faster R-CNN | 48.1 | 34.4 | 26.0 | 12.4 | 32.0 |
| S-DGOD | 56.1 | 36.6 | 28.2 | 16.6 | 33.5 |
| UFR | 58.6 | 40.8 | 33.2 | 19.2 | 39.6 |
| SE-COT | 55.4 | 42.0 | 39.2 | 24.5 | 40.6 |
| LTFE (Res101) | 58.4 | 43.1 | 39.7 | 24.3 | 41.2 |
| LTFE (Swin-T) | 64.2 | 53.1 | 46.5 | 33.4 | 46.4 |
Real-to-Art(Table 2,mAP%):Res101 下 Comic 35.4 / Watercolor 58.2 / Clipart 42.1(比 SE-COT Clipart +4.7);Swin-T 37.3 / 61.3 / 44.5。
持续测试时自适应对比(Table 3)——独特实验
| 方法 | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|
| ECPG(TTA) | 35.3 | 35.7 | 18.2 | 33.7 |
| LTFE | 43.1 | 39.7 | 24.3 | 41.2 |
论文用“测试时特征演化”对标持续测试时自适应(TTA)方法——说明 LTFE 的推理演化确实有自适应味道,且比显式 TTA 方法更强(Night Sunny 35.3→43.1)。
效率(Table 4)
| 模型 | mAP 均值 | 参数 | FPS | FLOPs |
|---|---|---|---|---|
| Faster R-CNN | 26.2 | 90.8M | 4.7 | 267G |
| PDOC | 32.6 | 198.6M | 2.2 | 478G |
| UFR | 33.2 | 184.2M | 6.9 | 323G |
| LTFE (Res101) | 37.1 | 140.6M | 6.4 | 325G |
消融(Table 5)
| 配置 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| Baseline | 49.2 | 35.4 | 27.5 | 13.7 | 32.6 |
| + PTFE | 54.6 | 36.8 | 29.3 | 14.1 | 33.6 |
| + PTFE + TDM+LPE | 57.3 | 42.6 | 39.4 | 22.7 | 40.8 |
| + PTFE + TFAM | 56.8 | 40.2 | 34.1 | 19.7 | 36.5 |
| 完整模型 | 58.4 | 43.1 | 39.7 | 24.3 | 41.2 |
分析:PTFE 单独用提升有限;TDM+LPE 是最大增益来源(动态核演化大幅提升);TFAM 单独加在 PTFE 上也有用;完整模型最优——动态控制演化轨迹最接近真实分布偏移。
超参 T:训练时增大 T 模拟更完整的演化轨迹,T=8 最优;推理 T=2 即可(再多会破坏目标域语义)。
一句话总结
LTFE 把 Single-DGOD 的域偏移建模成连续时序特征演化:用渐进模糊+噪声(PTFE)造演化轨迹,LSTM(TDM)记时序依赖,Neural ODE/LNN(LPE)按需动态生成卷积核自适应调整特征,TFAM 保证演化不丢语义;推理时只演 2 步做测试时特征自适应——不靠文本、不靠扩散、不靠原型,纯视觉时序一条路走到底。
相关资料
- 论文 arXiv:arXiv:2511.09909
- 代码仓库:github.com/2490o/LTFE
延伸阅读
- 对比学习(TFAM 的 L_inter 类间可分性为对比形式)