论文:Prototype-Anchored Generalized Manifold Regression for Unknown-Domain Object Detection(TPAMI 2026) 作者:Zihao Zhang(天津大学)、Aming Wu(合肥工业大学)、Yang Li、Yahong Han(天津大学) 定位:SE-COT(CVPR 2025)的 TPAMI 期刊扩展版——范式从 Simulation(模拟覆盖)升级为 Simulation→Regression(模拟造难样本 + 回归纠错)闭环
背景:为什么“只靠模拟”不够了
对现有 Simulation-Driven 范式的批判:
旧思路(CDSD / SE-COT / LTFE 等):有限模拟 → 覆盖无限真实变化?
  ✗ 现实域偏移是:多因子耦合 + 连续渐变 + 结构退化
    (雾天不只是"风格变了",还有局部模糊;雨夜 = 暗 + 雨点遮挡 + 噪声)
  ✗ 离散增强 / 静态文本模拟不出这种复杂性
✗ 还容易过拟合合成风格,遇到真未知域性能崩塌流形假设(论文的理论基石):
高维观测数据并非随机分布,而是聚集在紧凑的低维流形附近(Li et al. [14] 的去噪视角);干净样本靠近流形支撑,扰动会把样本推离流形。
“低维”体现在哪:论文用 K 个类原型(K=类别数,如 7 个) 作为低维流形上的离散锚点——高维特征经软分配压成 K 维概率(式 16)、投影算子把偏离特征拉回原型邻域(式 20-21)。“有效数据在低维” = 决定语义的自由度很少,几个锚点就能钉住整个语义流形(7 << 特征维度)。
由此推出新范式:Single-DGOD 的关键不是穷举扰动,而是学一个投影算子 H,把任意偏离流形的特征拉回源域语义流形——从“让模型见过更多”转向“让模型有纠错能力”。
核心思想:Simulate-to-Deviate, Regress-to-Rectify
MR-DCoT 建立完整闭环:
模拟 → 制造偏离(造离流形难样本)    Off-Manifold Generation
   ↓
回归 → 纠正回来(拉回语义流形) Manifold Regression三大模块:Disentangled Feature Embedding(解耦)→ Visual-Text Dual CoT(造难样本)→ Manifold Regression via Prototype Anchoring(拉回流形)。训练流程见 Algorithm 1。
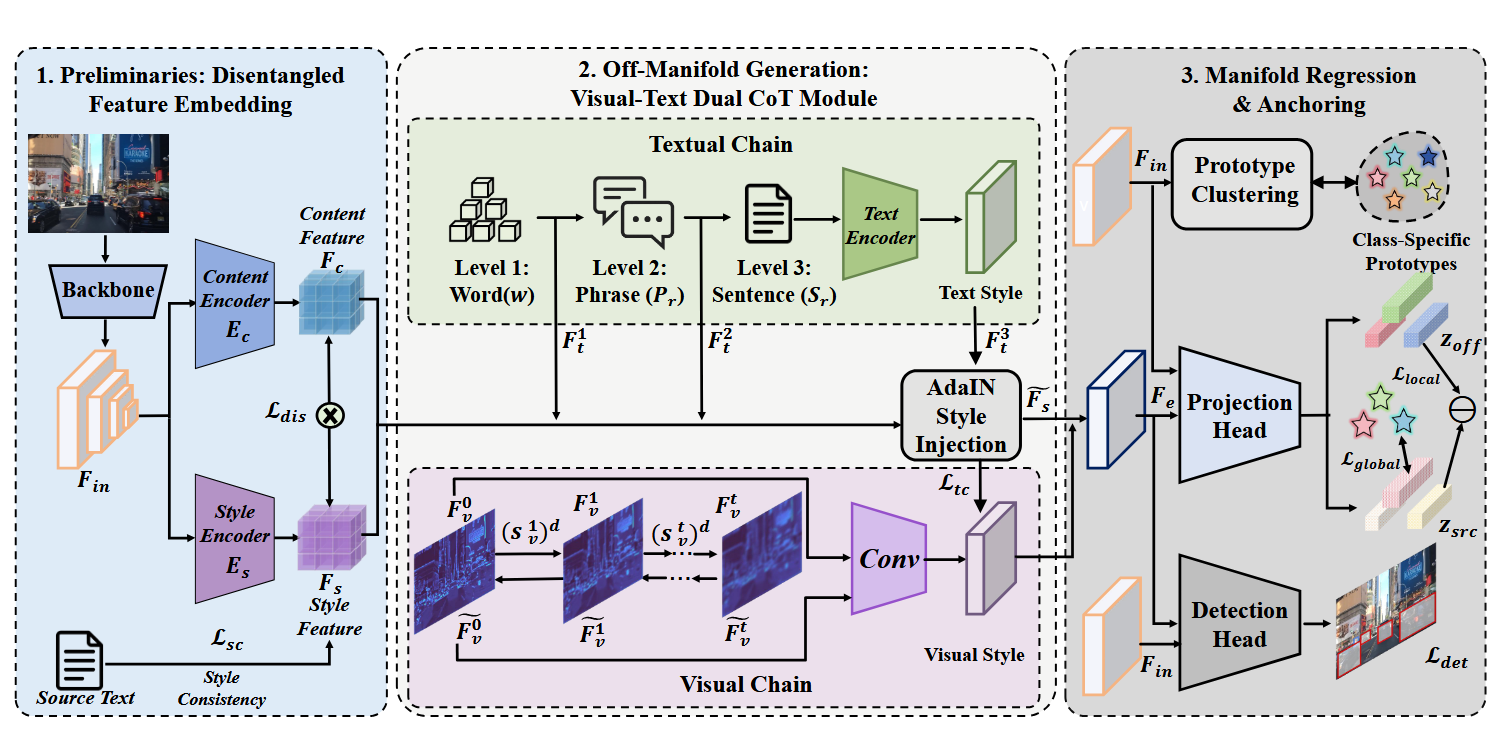
模块①:DFE——Disentangled Feature Embedding(解耦,继承 SE-COT 3.2 并简化)
两个轻量编码器把 backbone 第一层特征 拆成风格/内容:
两个损失:
| 损失 | 公式 | 作用 |
|---|---|---|
| 解耦损失 | (2) | 全局风格/内容近似正交,抑制跨分支冗余 |
| 风格一致性 | (3) | 对齐源域文本嵌入(CLIP),校准风格分支 |
相比 SE-COT 的三角色损失(L_d + L_sc + L_gc),期刊版简化为两损失(正交 + 文本校准),内容分支靠后面的原型回归来锚定。
模块②:Dual-CoT——视觉-文本双链造“离流形难样本”(核心新增)
动机:纯文本模拟只能改全局风格(色调、光照),描述不了局部结构退化(模糊、噪点、边缘破损)——语言表达不了这些细节。所以双链分工:语言定方向(宏观),视觉补细节(微观)。
文本链:CoT 引导的全局风格演化(继承 SE-COT 3.1 + 升级)
三级演化(词→短语→句子),CLIP 文本编码逐级累加:
AdaIN 风格注入(关键升级:参数由文本动态预测,而非静态学一组):
- 调制参数 由文本引导投影头从 预测(公式中 为通道级逐元素乘)
- 风格对齐损失: (9),确保演化出的视觉风格与文本语义一致
视觉链:扩散引导的局部特征演化(全新)
在内容特征 (记为初始状态 )上做特征扩散。与标准扩散注入高斯噪声不同,这里用高斯模糊作主退化算子,更好保留几何/语义结构:
前向模糊扩散(Markov 链逐步退化):
动态模糊调度(强度随局部特征统计自适应):
文本引导反向去模糊(生成“恢复过但已偏移”的特征):
( 为可学习去模糊网络,如 U-Net,以 为条件——去模糊过程中按文本描述幻觉出语义细节)
跨模态扩散一致性: (14),保证恢复特征既保留内容结构又带上文本风格。
双链融合(造出离流形样本)
同时包含全局风格偏移(文本链)和局部结构损坏(视觉链),是训练投影算子的硬样本。
模块③:MR——Manifold Regression via Prototype Anchoring(核心新增)
本质:训练时故意把特征弄脏(模块②干的),然后教模型一个本事——不管特征被弄得多脏,都能把它“修”回它本来该在的类别位置。就像人脸识别训练:故意给人脸图加墨镜、口罩、大雾,教网络“去掉干扰,认出这是谁”。
第一件事:学“类别原型”(每个类别的标准形象)
直觉:把所有“车”的特征平均出“车的标准长相”(原型 ),所有“人”平均出“人的标准长相”()……每个类别一个锚点,代表该类特征应该待的位置。
| 公式 | 本质 |
|---|---|
| (16) 软分配 | 每个像素投票:“我更像哪一类”(K = 类别数) |
| (17) 残差加权聚合 | 按投票权重,把“像素特征 − 聚类中心”加权平均 |
| (18) 原型 | 归一化 + 投影,得到紧凑的“类标准像” |
第二件事:造“配对训练样本”(纠错练习的题和答案)
用同一个 GT 框抠两个特征:
干净图上抠:z_src = ROI(F_in)   ← "这个人正常的样子"(答案)
脏图上抠:  z_off = ROI(F_e)    ← "这个人戴了口罩的样子"(题目,模块②造的)
第三件事:学“纠错器 H”(核心,分两步)
H 是什么:一个可学习的共享头(小网络)。输入脏特征 → 输出“修好的特征”。
怎么教它——两个损失,一个管“别认错类”,一个管“别修过头”:
| 损失 | 公式 | 本质 |
|---|---|---|
| 全局 | , (20) | 修完必须像本类原型:H( 口罩脸 ) 靠近“张三的标准照”,远离“李四的标准照” → 防止认错类别(对比损失,SE-COT 里见过同款) |
| 局部 | (21) | 修完还得像本人:H( 口罩脸 ) ≈ H( 正常脸 ),保留个体五官细节 → 防止修成“千篇一律的班花照”(stop-gradient 保证答案稳定) |
为什么不能直接把 z_off 拽向原型、非要学个 H?
因为原型是“类别平均脸”——直接拽过去,所有人都长成一张脸,物体细节全没了。H 是学出来的智能修图师:既往类别方向拉,又保留个体细节。这就是论文说的“不是简单的原型对齐,而是方向性纠错规则”(“rather than merely promoting prototype proximity”)。
原型引导特征增强(推理时用,公式 19):
把“类标准像”信息揉回原特征,让检测头看得更清楚——抑制背景噪声、突出类判别区域。推理时检测头就用这个增强后的特征。
公式 速查表
| 公式 | 本质 |
|---|---|
| (16) 软分配 | 每个像素投票“我像哪一类” |
| (17)(18) 原型 | 按投票加权平均出“类标准像” |
| (19) 原型增强 | 把“类标准像”揉回原特征,帮检测头看清 |
| (20) | 修完别认错类 |
| (21) | 修完别丢个体细节 |
| (22) | 两个一起管 |
总结
模块②:造脏特征 z_off(戴墨镜的人)
   ↓
模块③:H(z_off) 修回 → 靠近本类原型(还是这个人,没认成别人)
   ↓
训练完:模型对"没见过的新脏法"也有纠错能力(H 的本事长进模型里了)
网络架构(冻结/未冻结标注)
输入图像(源域)
   ↓
Backbone(❄️ 冻结:CLIP 权重初始化)→ Fin(第一层特征)
   ↓(拦截:Fin 转去旁路加工)
┌──────────────────────────────────────────────────┐
│ 旁路加工(训练期)                                  │
│ ① DFE 解耦:Es → Fs(🔥)│ Ec → Fc(🔥)             │
│ ② 文本链:CLIP 文本编码器(❄️冻结)                  │
│     → 文本投影头(阶段A🔥 / 阶段B❄️)→ (μt,σt)        │
│     → AdaIN 注入 Fs                                 │
│ ③ 视觉链:高斯模糊扩散(🔇固定核)                   │
│     → 动态调度 g(🔥)→ U-Net 去模糊 D(🔥)          │
│ ④ 融合:Fe = Conv(Concat(F̃s, F̂v0, Fv0))(🔥)      │
│ ⑤ MR:原型聚类(🔥)+ 投影头 H(🔥)→ Lreg            │
│ ⑥ 原型增强:Fp = Conv(Concat(Fin, θ·P))(🔥)        │
└──────────────────────────────────────────────────┘
   ↓(推理:Dual-CoT 和辅助损失【全部关闭】)
Backbone 2~4 层 → 检测头(🔥)
   ↓
预测框 + 类别(只用 Fp,标准单次前向)冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| Backbone | ❄️ 冻结 | CLIP 权重初始化(论文未明确分层,与 SE-COT 类似冻结为主) |
| CLIP 文本编码器 | ❄️ 冻结 | 预训练文本编码 |
| 解耦编码器 Es / Ec(DFE) | 🔥 训练 | 风格/内容解耦 |
| 文本投影头(预测 μt,σt) | 🔥 阶段 A / ❄️ 阶段 B | 独立训练阶段训出,检测训练时固定 |
| 高斯模糊核 G(σ) | 🔇 固定 | 高斯核函数,无参数 |
| 动态调度 MLP g / 去模糊 U-Net D | 🔥 训练 | 视觉链(造离流形样本) |
| 原型聚类(软分配 Conv、中心 S、投影 W_p) | 🔥 训练 | 流形锚点 |
| 投影算子 H | 🔥 训练 | 流形回归(只在训练损失里) |
| 原型增强 Conv(Fp) | 🔥 训练 | 推理时也用 |
| RPN + 检测头 | 🔥 训练 | 标准检测组件 |
关键设计解读:
- 训练/推理不对称:Dual-CoT(文本链投影头、视觉链 U-Net)只存在于训练期——推理时全部关闭,只走“Fin → 原型增强 Fp → backbone 2~4 层 → 检测头”;
- 冻结 backbone + CLIP:和 SE-COT 一致,解耦/回归模块架在冻结主干上,保护通用表示;
- 投影算子 H 是训练期专属:它的纠错本领通过梯度内化进权重,推理时不显式调用(详见“训练 vs 推理”小节)。
总损失与训练/推理
| 阶段 | 行为 |
|---|---|
| 训练 | 端到端联合优化;Dual-CoT 激活生成 ;检测头在双流输入(原型增强源特征 + 离流形特征 )上训练;原型作为流形锚点参与回归 |
| 推理 | 关闭 Dual-CoT 和所有辅助损失,单次标准前向,只用 预测 → 泛化能力训练时练出,推理零额外开销 |
整体数据流(五框架通用,训练时)
注意:Faster R-CNN / YOLOv10 / DiffusionDet / GLIP-T / DINO 是完整检测框架(backbone + 检测头),括号里(Res101 / CSPNet / Swin-T / DINOv2)才是 backbone。MR-DCoT 的三个模块是框架无关的训练期插件,插在“backbone 第 1 层特征 → 检测头”之间。
输入图像
   ↓
① 框架自带 Backbone(Res101 / CSPNet / Swin-T / DINOv2)→ 第 1 层特征 Fin
   ↓
② MR-DCoT 插件(训练时激活):
   DFE 解耦 Fin → Fs/Fc
   Dual-CoT 在 Fs/Fc 上造离流形样本 Fe(AdaIN + 扩散)
   MR:原型聚类 + 投影算子 H(在实例特征上回归)
   ↓
   Fp = 原型增强特征(公式 19)
   ↓
③ 送回框架自带 Backbone 第 2~4 层 → 继续前向
   ↓
④ 框架自带检测头(RPN / YOLO 头 / 扩散头 / 语言引导头 / DETR 解码器)
   ↓
预测框 + 类别
训练 vs 推理的区别
| 组件 | 训练时 | 推理时 |
|---|---|---|
| Dual-CoT(文本链 + 视觉链) | ✅ 激活:造离流形样本 | ❌ 关闭:不再生成,CLIP/扩散/U-Net 全不跑 |
| 辅助损失() | ✅ 参与梯度 | ❌ 关闭 |
| 投影算子 H | ✅ 在 loss 里学“脏特征→语义流形”纠错 | ❌ 不参与前向(纠错本领已内化进权重) |
| 风格分支 Es + AdaIN | ✅ 做风格迁移 | ❌ 不需要 |
| 内容分支 Ec → 软分配 θ | ✅ | ✅ 开着(算原型投票用) |
| 原型 P + 增强 | ✅ 作为一路输入喂检测头 | ✅ 推理时唯一多出来的东西(公式 19) |
| 检测头输入 | 双流: + | 单流:只用 |
| 计算开销 | 重(扩散、多损失) | 标准单次前向,零额外开销 |
核心洞察:H 的纠错能力在训练时被“练进”网络权重,推理时模型表现为天然免疫——不需要显式去扰动、不需要测试时自适应(对比 LTFE 推理还要 2 步特征演化)。 是训练遗产在推理时的唯一显式出口。
创新点总结(与 SE-COT 对照)
| 维度 | SE-COT (CVPR25) | MR-DCoT (TPAMI26) | 创新级别 |
|---|---|---|---|
| 范式 | Simulation-Driven(模拟覆盖) | Simulation→Regression 闭环(模拟造偏离 + 回归纠错) | 🏆 范式级 |
| 生成机制 | 纯文本 CoT | 视觉-文本双链(文本 CoT + 扩散式高斯模糊/去模糊) | 模块级 |
| 优化目标 | 扩展空间中语义对齐 | 原型锚定流形回归(投影算子 H + 分层损失) | 模块级 |
| 风格参数 | 静态学一组 | 文本投影头动态预测 | 改进级 |
实验
设置
| 基准 | 内容 | 指标 |
|---|---|---|
| Diverse Weather | 只训 Day Clear,测 Night Sunny / Dusk Rainy / Night Rainy / Day Foggy | mAP@0.5 |
| Reality-to-Art | VOC2007+2012 → Clipart / Watercolor / Comic | mAP@0.5 |
| 零样本域自适应分割(ZSDA) | Cityscapes → ACDC / GTA5(+ GTA5 → Cityscapes) | mIoU |
主结果(Table 1,Faster R-CNN 框架,mAP%)
| 方法 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| Faster R-CNN | 48.1 | 34.4 | 26.0 | 12.4 | 32.0 |
| S-DGOD | 56.1 | 36.6 | 28.2 | 16.6 | 33.5 |
| UFR | 58.6 | 40.8 | 33.2 | 19.2 | 39.6 |
| DIV | 52.8 | 42.5 | 38.1 | 24.1 | 37.2 |
| SE-COT | 55.4 | 42.0 | 39.2 | 24.5 | 40.6 |
| MR-DCoT (Res101) | 56.2 | 47.4 | 42.2 | 28.1 | 42.8 |
| MR-DCoT (Swin-T) | 65.1 | 54.6 | 53.2 | 36.4 | 48.3 |
五框架通用性:Faster R-CNN(Res101)、YOLOv10-L(CSPNet)、DiffusionDet(Swin-T)、GLIP-T(Swin-T)、DINO(DINOv2)全部涨点——方法不依赖特定检测头,加的是训练期的模拟+纠错机制。
消融关键发现
Table XI(模块消融):
- 单独用 Dual-CoT 或 MR(不解耦):提升有限——风格内容纠缠限制了模拟和回归的发挥
- DFE + Dual-CoT:Night Sunny 相比 baseline +9.7%——解耦后双链能造出更有效的离流形难样本
- 完整模型(DFE + Dual-CoT + MR):所有场景最优,目标域平均 +10.3%——双链造难样本 + 回归拉回流形,协同最大化
Table XII(双链内部消融):
| 配置 | Night Sunny | Day Foggy | Dusk Rainy |
|---|---|---|---|
| 文本链 alone | 52.7 | 44.9 | — |
| 视觉链 alone | — | 45.3(略超文本链) | — |
| Full Dual-CoT | — | — | 53.2(关键) |
文本链擅长全局光照域(Night Sunny);视觉链靠模糊天然模拟雾(Day Foggy 反超);复合域(Dusk Rainy)必须双链配合——这就是“语言定方向、视觉补细节”的实证。
超参分析:
| 超参 | 最优 | 现象 |
|---|---|---|
| 文本链层级 | Level 3(句子级) | 峰值 NR 36.4 / NS 54.6;L4-L5 饱和/微降(描述过复杂引入语义噪声) |
| 扩散步数 T | T=8 | T 增大精度提升;T=10 退化(过度扩散不可逆破坏语义,回归拉不回来) |
| 扰动注入层 | Layer 1 | Layer 1 最优(浅层=低层统计=风格);Layer 4 掉到 NR 30.2(深层=语义,扰动破坏类别身份) |
效率(Table XIII):Dual-CoT 仅训练期启用,推理零额外开销;MR 只有原型增强的小幅成本,整体效率优于同类方法。
总结
MR-DCoT 把 Single-DGOD 重新定义为流形回归问题:用视觉-文本双链 CoT 制造“既全局偏移又局部损坏”的离流形难样本,再用类特定原型锚定的投影算子 H 把它们拉回源域语义流形——Simulate-to-Deviate, Regress-to-Rectify 闭环,此时模型训练就可以学到去扰动的能力,让模型从“见过更多”进化到“能纠错”。
相关资料
- 论文 arXiv:arXiv:2607.07192
延伸阅读
- AdaIN 风格迁移(文本链 AdaIN 注入)
- 对比学习(L_global 原型对比损失)
- 推理模型深度思考原理笔记(Dual-CoT 双链)