存储所读论文的精简内容(一句话核心 + 方法要点 + 关键结果),便于快速回顾。
1. CDSD / S-DGOD(CVPR 2022)
📄 完整笔记
基本信息:Single-Domain Generalized Object Detection in Urban Scene via Cyclic-Disentangled Self-Distillation|Wu & Deng(西安电子科技大学)
一句话核心:首次提出 Single-DGOD 任务;用循环解耦在无域标签下拆出域不变特征(DIR),再用自蒸馏把 DIR 灌回骨干中间层,提升未知域泛化。
任务:只用白天晴天一个源域训练检测器,泛化到夜晚/雨/雾等未见目标域(Diverse-Weather,7 类)。
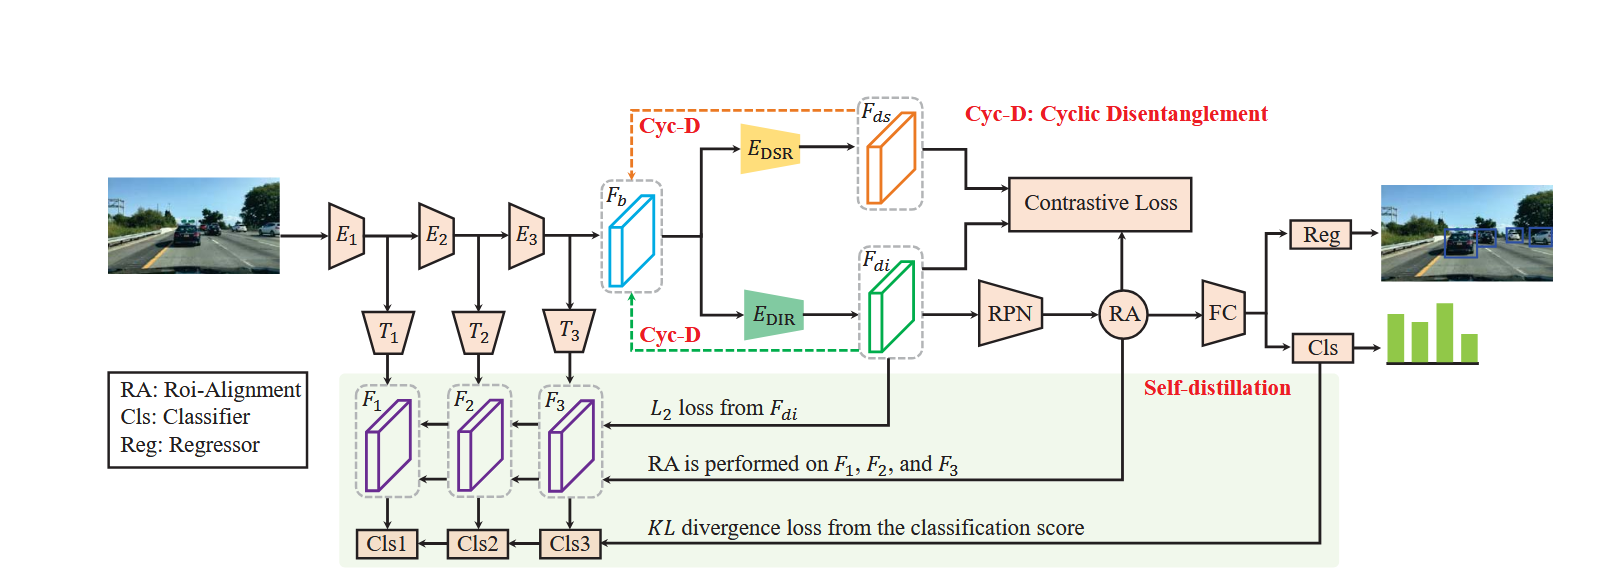
方法要点:
- 循环解耦:骨干特征 Fb 经 EDIR/EDSR 拆成域不变 Fdi + 域特有 Fds;再反向解耦一次(Fdi→Fi2i/Fi2s,Fds→Fs2i/Fs2s),用对比损失(全局 Lgc + 实例 Lic)逼两个提取器分干净——不需要域标签;
- DIR 自蒸馏:Fdi 当老师,蒸馏到骨干中间层 F1/F2/F3——特征级 Lfc(L2 距离)+ 分类级 Lcc(KL 散度),让中间层也富含域不变信息;
- 推理:只用 Fdi 分支做检测(丢弃 Fds)。
关键公式:
(Lcd = Lgc + Lic 循环解耦;Lsd = Lfc + Lcc 自蒸馏)
结果(mAP%):
| 测试域 | Faster R-CNN | CDSD | 提升 |
|---|---|---|---|
| Night-sunny | 33.5 | 36.6 | +3.1 |
| Dusk-rainy | 26.6 | 28.2 | +1.6 |
| Night-rainy | 14.5 | 16.6 | +2.1 |
| Daytime-foggy | 31.9 | 33.5 | +1.6 |
贡献:① 定义 Single-DGOD 任务与 Diverse-Weather 基准;② 无域标签的循环解耦;③ 基于 DIR 的自蒸馏。
与后续工作的关系:武老师组“模拟派”起点——SE-COT/MR-DCoT/LTFE 都在它定义的基准上对比;消融显示自蒸馏是主要增益来源(Daytime-sunny 48.7→56.1)。
链接:
2. SE-COT(CVPR 2025)
📄 完整笔记
基本信息:Style Evolving along Chain-of-Thought for Unknown-Domain Object Detection|Zihao Zhang、Aming Wu、Yahong Han(天津大学/西电)|arXiv:2503.09968
一句话核心:用文本 CoT(词→短语→句子)生成逐步丰富的风格描述,经 CLIP 编码 + AdaIN 注入源域特征模拟未知域风格;配合风格/内容解耦和类原型保持语义。
任务:Single-DGOD(同 CDSD 基准)——只训白天晴天,泛化到夜晚/雨/雾等未知域。
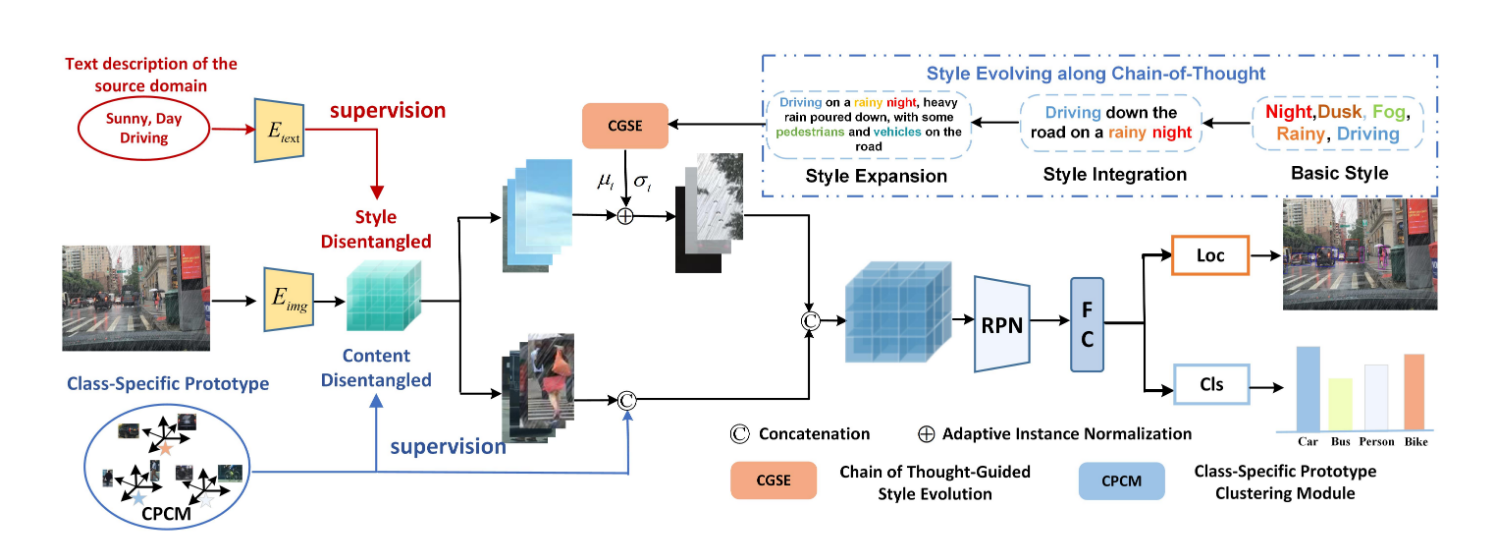
方法要点:
- CoT 风格演化(3.1):文本三级演化 词→短语→句子,CLIP 逐级累加文本特征 Ft1/Ft2/Ft3;AdaIN 注入(μt,σt 由文本学出),造“雨夜”等风格样本;
- 风格/内容解耦(3.2):EStyle/EContent 拆 Fs/Fc;Ld 对比损失(拉近 F1↔Fs、推远 F1↔Fc)+ Lsc 风格一致(对齐源域文本)+ Lgc 内容一致(对齐类原型);
- 类特定原型(3.3):软分配+残差聚类出每类原型,增强内容特征并监督解耦。
关键公式:
结果(mAP%,Res101):
| 域 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| SE-COT | 55.4 | 42.0 | 39.2 | 24.5 | 40.6 |
| (SE-COT Swin-T) | 64.4 | 52.7 | 49.5 | 33.7 | 44.9 |
贡献:① 首次把 CoT 引入风格演化(文本逐级丰富);② 风格/内容解耦三损失;③ 类特定原型增强+监督。
与后续工作的关系:MR-DCoT(TPAMI 2026)是它的期刊扩展版(Simulation→Regression 闭环、视觉-文本双链);LTFE 批评其“依赖目标域文本先验”。
链接:
3. MR-DCoT(TPAMI 2026)
📄 完整笔记
基本信息:Prototype-Anchored Generalized Manifold Regression for Unknown-Domain Object Detection|Zihao Zhang、Aming Wu、Yang Li、Yahong Han(天津大学/合工大)|arXiv:2607.07192
一句话核心:把 Single-DGOD 重新定义为流形回归问题——视觉-文本双链 CoT 造“离流形难样本”,再用类特定原型锚定的投影算子 H 把它们拉回源域语义流形(Simulation→Regression 闭环)。
任务:Single-DGOD(Diverse-Weather + Real-to-Art + 零样本域自适应分割)。
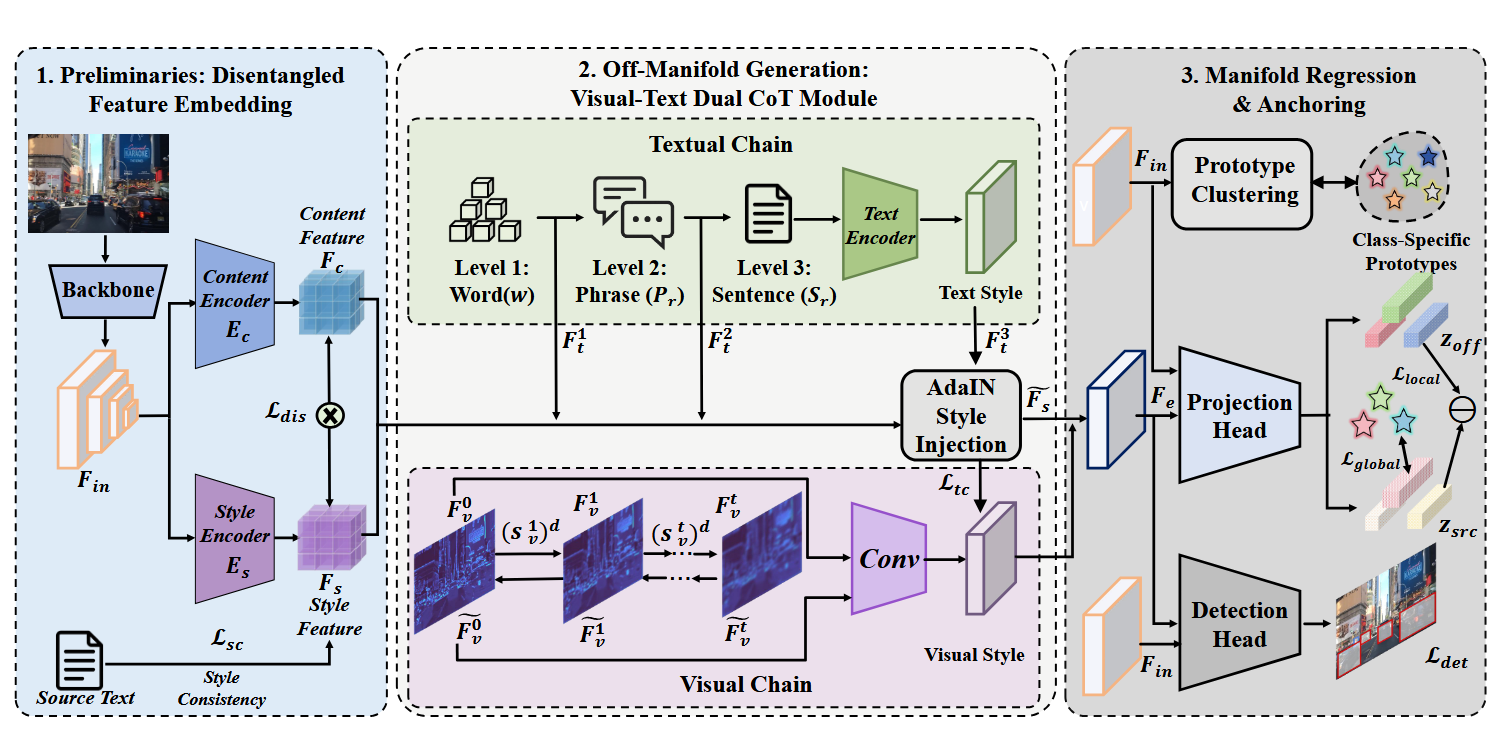
方法要点:
- DFE 解耦(模块①):Es/Ec 拆 Fs/Fc + 正交约束 L_dis + 风格一致性 L_sc;
- Dual-CoT 造难样本(模块②):文本链(CoT 三级 + AdaIN 注入)+ 视觉链(高斯模糊扩散前向 + 文本引导 U-Net 去模糊),融合成离流形特征 Fe;
- 流形回归 MR(模块③):软分配+残差聚合出类原型 P_k(流形锚点);投影算子 H 把离流形特征拉回原型邻域(L_global 对比 + L_local 残差)。
关键公式:
结果(mAP%,Res101):
| 域 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| MR-DCoT | 56.2 | 47.4 | 42.2 | 28.1 | 42.8 |
| (MR-DCoT Swin-T) | 65.1 | 54.6 | 53.2 | 36.4 | 48.3 |
贡献:① 范式升级:Simulation→Regression 闭环;② 视觉-文本双链 CoT(补结构退化模拟);③ 原型锚定流形回归(学纠错而非穷举扰动)。
与后续工作的关系:SE-COT 的 TPAMI 期刊扩展版(更全面);五框架(Faster R-CNN/YOLO/DiffusionDet/GLIP-T/DINO)通用。
链接:
4. LTFE(AAAI 2026)
📄 完整笔记
基本信息:Simulating Distribution Dynamics: Liquid Temporal Feature Evolution for Single-Domain Generalized Object Detection|Zihao Zhang、Yang Li、Aming Wu、Yahong Han(天津大学/合工大)|arXiv:2511.09909
一句话核心:把域偏移建模成连续时序特征演化——渐进模糊+噪声造演化轨迹(PTFE)、LSTM 记时序依赖(TDM)、Neural ODE/LNN 动态生成卷积核(LPE)、TFAM 保语义;推理时 2 步演化做测试时特征自适应。
任务:Single-DGOD(Diverse-Weather + Real-to-Art),纯视觉时序(不用文本/VLM)。
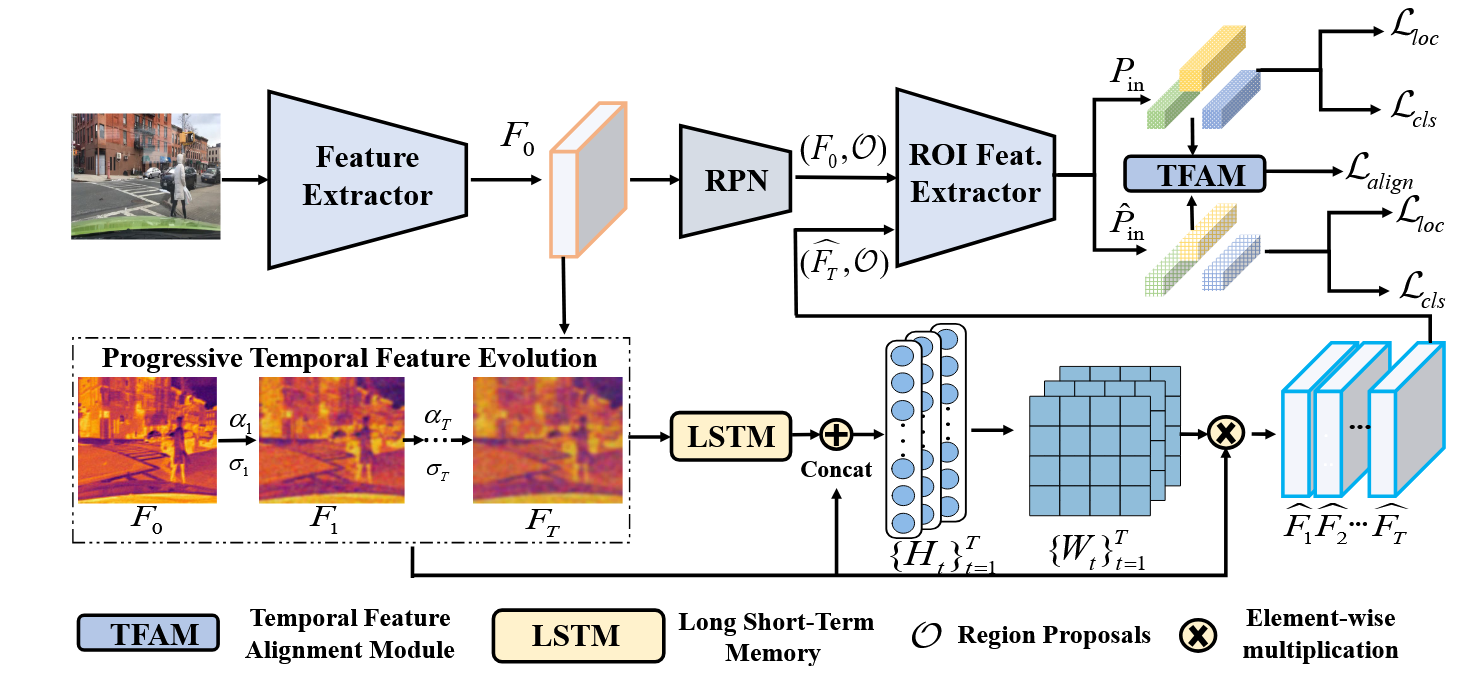
方法要点:
- PTFE 渐进时序演化:——模糊指数增长(λ=1.2)+ 噪声指数衰减(κ=0.2),模拟“从精细到粗糙”的连续退化;
- TDM 时序依赖:LSTM 建模特征序列,捕捉演化轨迹长程依赖;
- LPE 液态参数演化(核心):Neural ODE/LNN 动态生成卷积核 ——域偏移越大演化越久;(残差保语义);
- TFAM 对齐:类内一致性 + 类间可分性,保证演化不丢语义。
关键公式:
结果(mAP%,Res101):
| 域 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| LTFE | 58.4 | 43.1 | 39.7 | 24.3 | 41.2 |
| (LTFE Swin-T) | 64.2 | 53.1 | 46.5 | 33.4 | 46.4 |
贡献:① 连续时序演化(PTFE)模拟真实渐变退化;② 液态参数演化(LPE,Neural ODE/LNN 动态核);③ 推理 2 步演化(测试时特征自适应)。
与后续工作的关系:武老师组“模拟派”最新一支——甩开文本,纯视觉时序;推理有前向成本(6.4 FPS),与 MR-DCoT“零开销”形成取舍。
链接:
5. Cauvis(NeurIPS 2025)
📄 完整笔记
基本信息:Towards Single-Source Domain Generalized Object Detection via Causal Visual Prompts|Chen Li、Huiying Xu、Changxin Gao、Zeyu Wang、Yun Liu、Xinzhong Zhu(华科/浙师大/西工大/南开)⚠️非武老师组|arXiv:2510.19487
一句话核心:冻结 DINOv2 + 视觉提示(交叉注意力,理论等价 Pearl 后门调整)+ 傅里叶双分支适配器,抑制伪相关、不造任何合成数据(因果干预派)。
任务:Single-DGOD(Diverse-Weather)+ Cityscapes-C 损坏鲁棒性(mPC)。
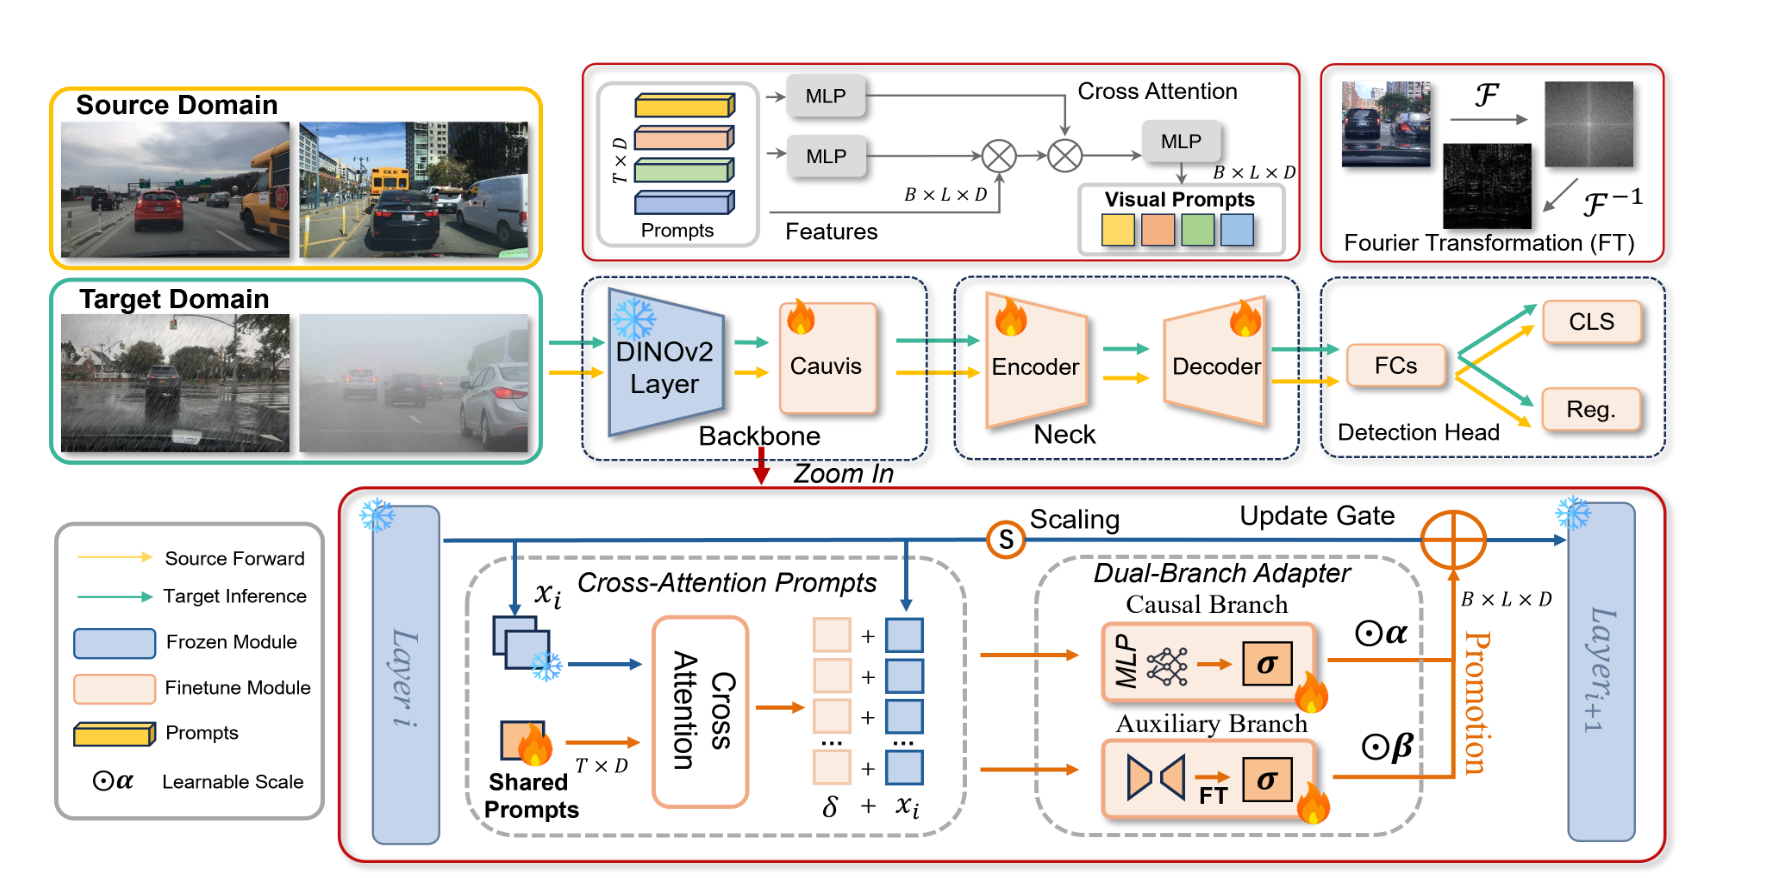
方法要点:
- Cross-Attention Prompts(4.1):提示=独立于图像域的“伪模态”信号,交叉注意力与图像融合;SVD 把注意力分解为因果子空间(top-k 奇异方向)与伪相关(小奇异值),软阈值过滤——等价后门调整 ;
- Dual-Branch Adapter(4.2):因果分支(MLP 映射提示激活→因果特征 )+ 傅里叶分支(FFT 高通/相位滤波提取域不变高频);
- 训练极省:只用标准交叉熵损失,不加显式解耦/对抗损失;冻结 DINOv2 只调 ~1% 参数。
关键公式:
结果(mAP%,DINOv2+DINO):
| 域 | Day Clear | Night Sunny | Dusk Rainy | Night Rainy | Day Foggy |
|---|---|---|---|---|---|
| Cauvis | 73.7 | 61.2 | 64.6 | 47.6 | 56.5 |
贡献:① 首次把 DINOv2 当 SDGOD backbone;② 因果视角建立伪相关→泛化下降的理论框架;③ 交叉注意力提示等价后门调整 + 双分支适配器。
与后续工作的关系:因果干预派(不造数据)vs 武老师组模拟派;⚠️ 高分含 DINOv2 红利(消融:去掉后 Avg 60.7→34.2),和 Res101 系比数字需谨慎。
链接:
6. DSD / LMPNet(ICML 2026)
📄 完整笔记
基本信息:Beyond Point Predictions: Manifold Expansion and Dual Alignment for Robust Time Series Distillation|Junyao Hong、Zesheng Lai、Xinyi Xiao、Suyang Zhou、Aodong Shen、Youyong Kong(东南大学)|ICML 官方页面
一句话核心:时间序列结构蒸馏——蒸馏该传“结构关系”而非“逐点数值”;LMP-Net(流形扩展)做轻量学生 + 双流形对齐(SPKD 拓扑 + OT 几何)+ RAAD 防负迁移。
任务:长时序预测(LTSF)蒸馏——轻量学生追赶 Transformer 教师(8 数据集:ETT 家族/Electricity/Traffic/Weather/Exchange)。
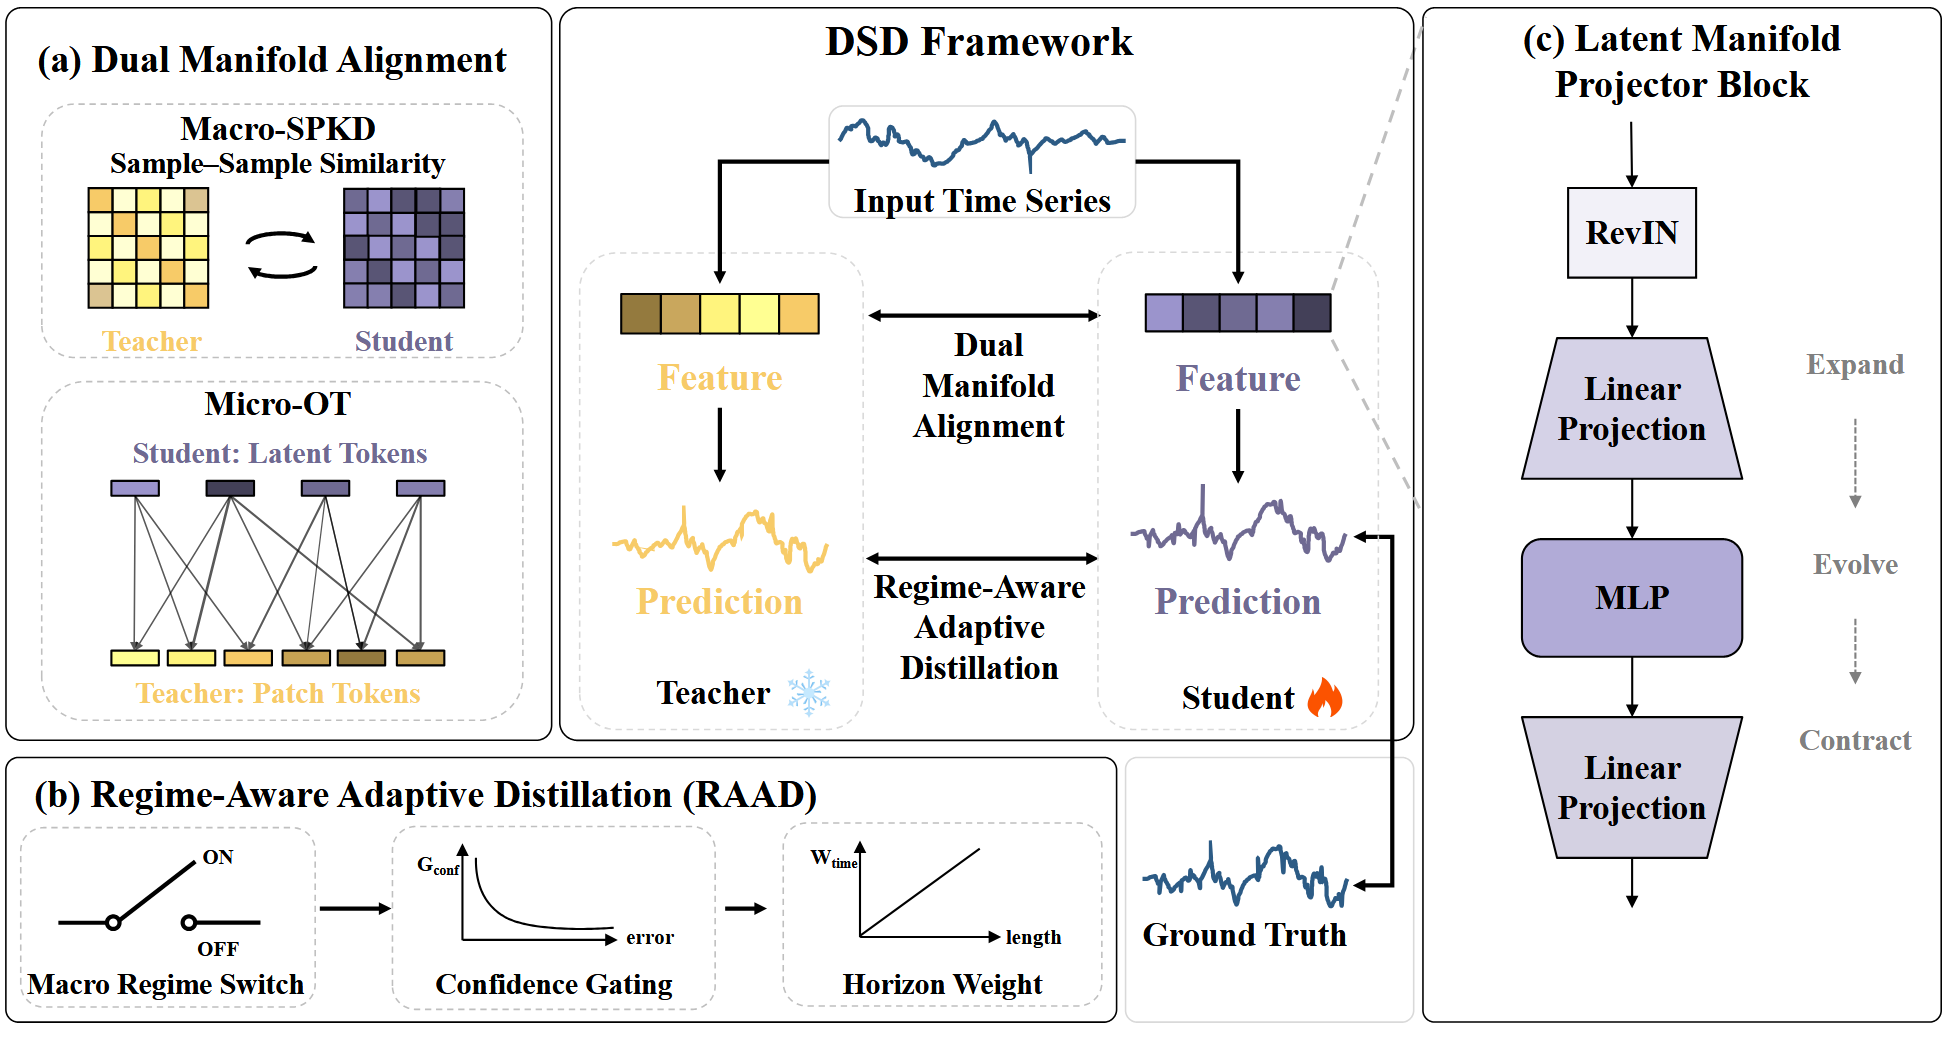
方法要点:
- LMP-Net(模块①,学生):Expand-Evolve-Contract(升维→演化→收缩),Cover 定理——高维空间易建模非线性,0.18M 参数保持近线性;
- Dual Manifold Alignment(模块②):Macro-SPKD(样本间关系/拓扑对齐,Gram 矩阵)+ Micro-OT(token 细节/几何对齐,Sinkhorn 软匹配)——解决教师 token 与学生 point 粒度不匹配;
- RAAD(模块③):regime 先验(验证集选 κ)+ 置信度门控(g=exp(−ηe))——教师预测不可靠时“敢关掉预测蒸馏”,防负迁移。
关键公式:
结果(MSE,越低越好):DSD 稳定提升学生:ETTh1 0.452→0.430(-4.87%)、Weather 0.254→0.246;0.18M 学生超 13.89M 教师(ETTh1 0.472 vs 0.488,快 15 倍)。
贡献:① 结构蒸馏 > 逐点匹配(负迁移分析);② 双流形对齐(拓扑 + 几何);③ RAAD 防负迁移(regime + 置信度双层过滤)。
与课题的关系:蒸馏方法论教材(“怎么蒸得稳”)——检测蒸馏可借鉴:结构对齐代替简单特征对齐、教师不可靠时按域/样本关蒸馏(CD-FKD 的弱点)。
链接:
- 对比学习(SPKD 关系对齐思想相通)
- 知识蒸馏(结构蒸馏方法论)
- 论文链接|OpenReview
7. TimeDistill(KDD 2026)
📄 完整笔记
基本信息:TimeDistill: Efficient Long-Term Time Series Forecasting with MLP via Cross-Architecture Distillation|Juntong Ni、Zewen Liu、Shiyu Wang、Ming Jin、Wei Jin(Emory/Griffith)|ACM DOI
一句话核心:跨架构蒸馏——Transformer/CNN 教师 → 纯 MLP 学生;用多尺度(时域下采样)+ 多周期(频域 FFT)双视角,在预测级+特征级双层面对齐;理论:KD ≈ mixup 增广。
任务:长时序预测(LTSF)——8 数据集(ECL/ETT×4/Solar/Traffic/Weather),轻量 MLP 追赶 Transformer 精度。
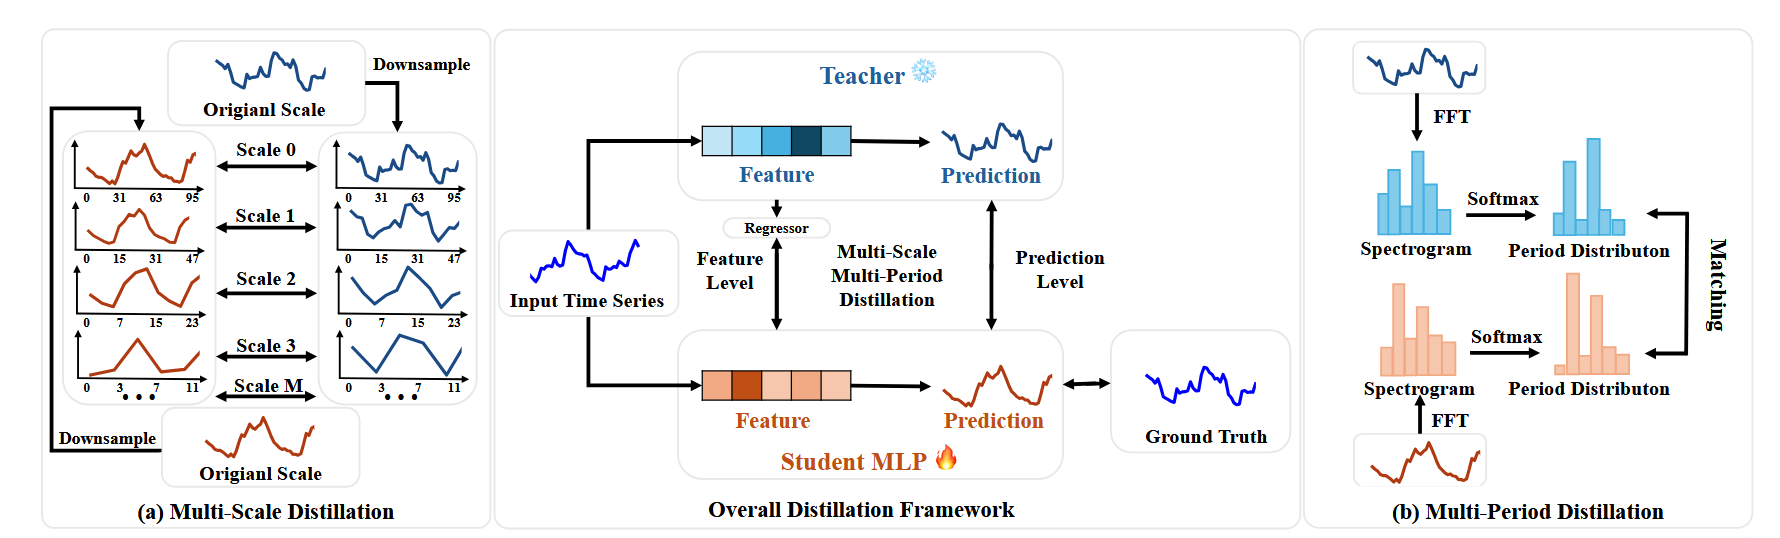
方法要点:
- 多尺度蒸馏(时域):预测/特征逐级下采样(stride=2 Conv)多级 MSE 对齐——学生学“粗看细看都像教师”;
- 多周期蒸馏(频域):FFT → 振幅 → 冷温度 softmax → 周期分布,KL 散度对齐——学生学“哪些周期占主导”;
- 理论(Theorem 4.1/4.2):监督+蒸馏 ≈ mixup 增广上界——目标软化带来泛化/稳定收益。
关键公式:
结果:7/8 数据集 MSE 最优、全部 MAE 最优;超教师最多 +5.37%、超无蒸馏 MLP 最多 +13.87%;7× 推理加速、130× 少参数(vs Autoformer 196×)。
贡献:① 首个跨架构 KD 的时序蒸馏框架;② 多尺度+多周期(时频双域);③ KD≈mixup 理论分析。
与课题的关系:跨架构蒸馏方法论(“怎么蒸得全”)——检测迁移点:FPN 多尺度对齐(对应多尺度蒸馏)、频域蒸馏(对应多周期)、大检测器→轻量检测器(对应跨架构)。
链接:
8. SARD(CVPR 2026)
📄 完整笔记
基本信息:Structure-Aware Representation Distillation for Tiny-Dense Object Segmentation|Liu 等|代码
一句话核心:微型密集目标分割的结构感知蒸馏——不走“模仿 mask”,从教师特征算一张“哪里重要”的结构图(边界显著性 + 几何复杂度 + 空间密度),再按重要性加权做“点对点特征一致 + 去噪分数匹配分布对齐”,让学生把容量花在几何关键位置。
任务:微型密集目标分割(岩石碎片/细胞/烟羽——每图数千个小而互相接触的物体),Cityscapes + ADE20K + RockFrag(极端密集挑战基准)。
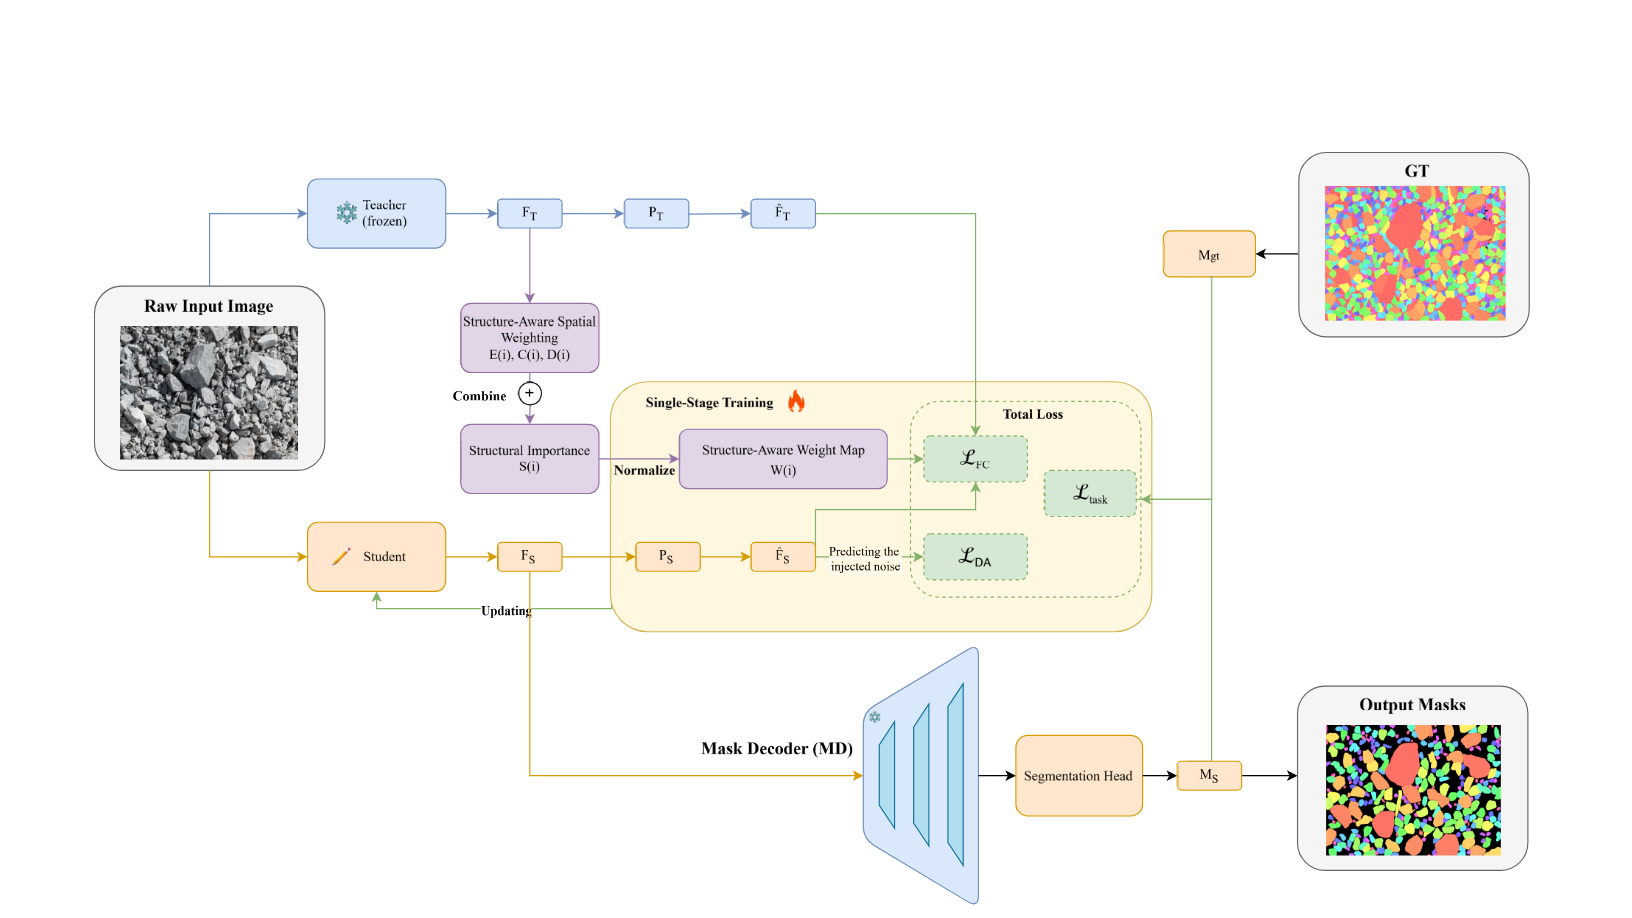
方法要点:
- 结构重要性图 S(i)(核心,式 5-9):对教师特征 FT 做 Sobel 梯度 → 结构张量 (特征值 )→ 三分量 (边界显著性)、(交点/角点)、(局部特征离散度,密度代理)→ → 归一化 ——不需要实例标注,兼容半监督;
- L_FC 特征一致性(式 11):师生特征各经 1×1 卷积投影到共享空间,按 W 加权的点对点 L2——W(i) 大的边界/密集区误差被放大(梯度大),背景区域学习信号被稀释;
- L_DA 分布对齐(式 12-13):教师特征加噪 ,轻量去噪头 g(两层卷积)用学生特征预测噪声——去噪分数匹配 ≈ 逼近教师特征的 log-密度梯度,学点值之外的“局部分布形状”;
- 任务监督(式 14):学生解码器 , 对真值(无 GT 的图只算 L_repr)。
关键公式:
结果(mIoU/bIoU%):Cityscapes 80.3/76.1、ADE20K 46.9/40.8、RockFrag 60.2/47.3(vs CWD +4.3/+6.7,越密集增益越大);架构通用(Swin-L→Swin-T、SAM-H→EfficientSAM-Ti、Mask2Former-L→R50 均 +1.51.8 mIoU/+2.32.7 bIoU);消融:均匀加权 → 结构加权 +4.8 mIoU,E/C/D 全组合最优;ViT-T(5.7M)反超 SegFormer-B1;ResNet-50 蒸馏后 7.7× 参数减少、9× 吞吐。
贡献:① 结构重要性图空间加权蒸馏(E/C/D 互补,别均匀对齐);② 去噪分数匹配做分布级特征对齐(学“分布”不止“点值”);③ 微型密集分割新基准 RockFrag;④ 教师只出特征、任意分割大模型通用、推理零额外开销(5~25M 学生)。
与课题的关系:检测蒸馏可直接借鉴——“哪里重要就加权哪里”:小目标/密集交通/物体边界应加权(CD-FKD 等均匀对齐的弱点);分布对齐呼应 DSD“结构 > 数值”但实现不同;教师无关(SAM/Mask2Former 也可当异构特征老师)。
链接:
- 知识蒸馏(SARD 结构加权蒸馏原理)
- 论文阅读:DSD(ICML 2026)(同样主张“结构/关系优于点值对齐”)
- 代码
9. UCOD-MKD(CVPR 2026)
📄 完整笔记
基本信息:Beyond Weak Supervision: MLLMs-Guided Graded Knowledge Distillation for Unsupervised Camouflaged Object Detection|Huafeng Chen、Chenguang Zhu、Yueming Lyu、Caifeng Shan(南京大学/西工大)|代码
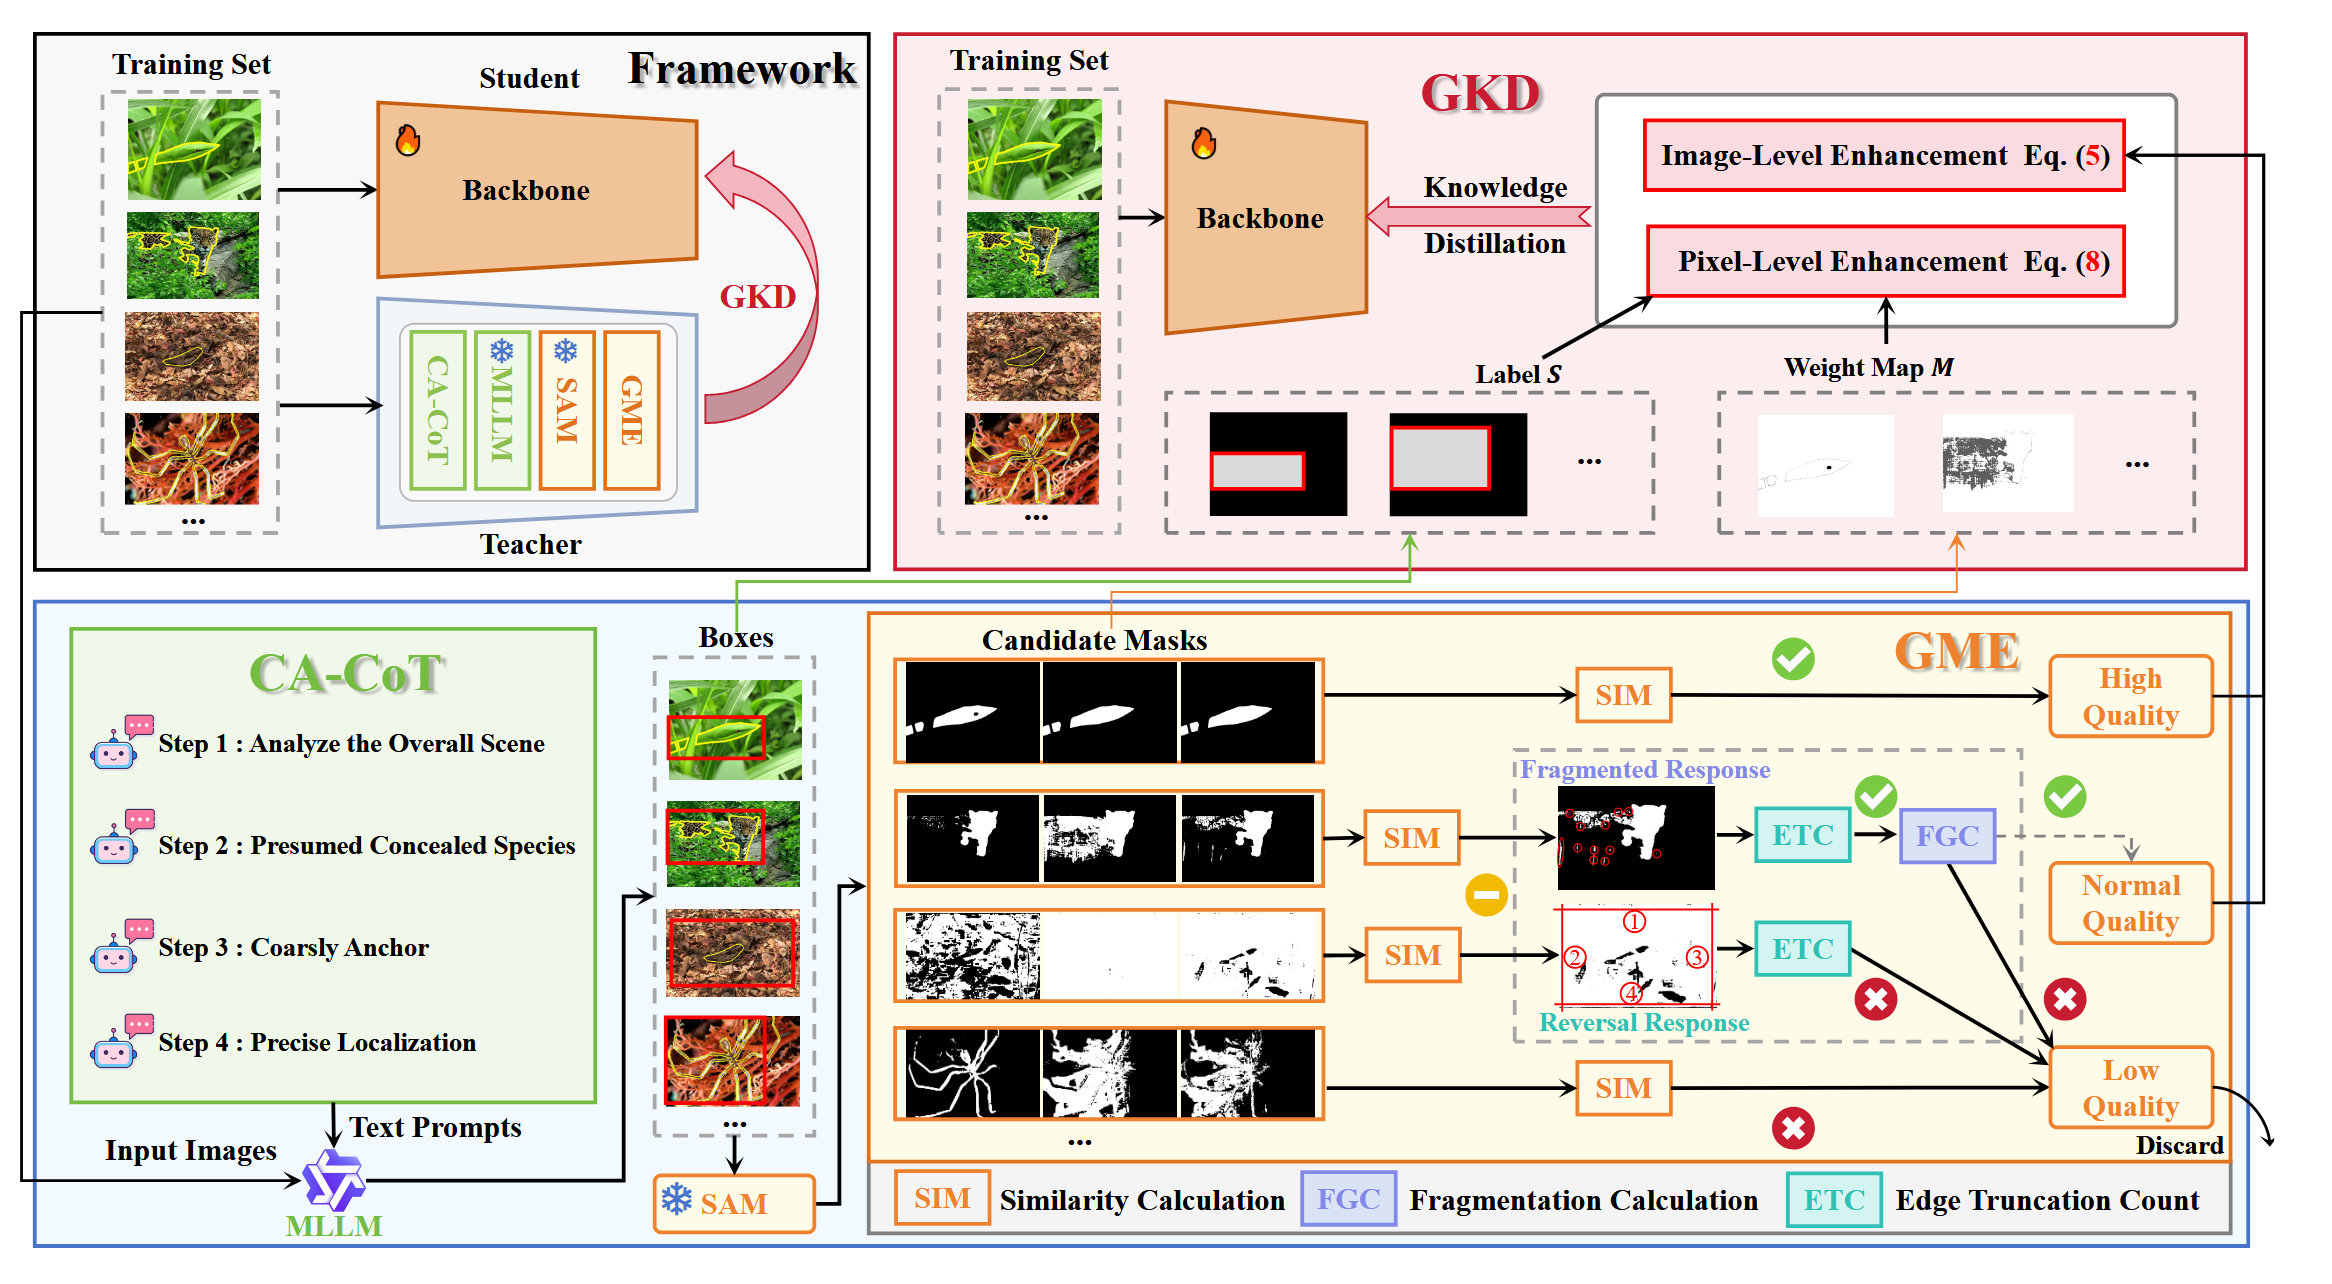
一句话核心:无监督伪装目标检测(UCOD)——用冻结的 MLLM(CA-CoT 分步推理出框)+ SAM(出候选掩码)当“免费教师”,GME 按候选掩码一致性把伪标签分成高/正常/低三档(丢弃低质量),GKD 再按质量做图像级与像素级差异化蒸馏轻量学生——全程零人工标注。
任务:无监督伪装目标检测(COD:岩石上的蛇、叶子里的昆虫等融入环境的物体),完全不用像素级/人工标注;CAMO + COD10K + NC4K。
方法要点:
- CA-CoT(模块①):纯文本 5 步思维链引导 MLLM(Qwen2.5-VL 3B)找伪装物——全局场景 → 推断伪装类型 → 粗锚定 → 几何精确定位 → 返回 bbox(缓解 MLLM 幻觉/抖动,几乎零额外成本);
- GME(模块②,无参数):SAM 对同一 box 出 3 个候选掩码,用两两 IoU+SSIM 相似度 评估质量 ,分三档 ( 丢弃)——候选掩码越一致 = SAM 分割越稳定 = 质量越高;
- GKD 图像级(式 5):低质量 用 Self-KD(,图像内容还有价值);正常 用 CE 监督;高质量 用 CE+L1+MSE 三重强监督;
- GKD 像素级(式 6-8):候选掩码平均置信度 → 熵 → 权重 (边界等摇摆像素降权);另把框外像素当可靠背景先验单独监督(MLLM 失败主要是过度定位,框外几乎一定是背景)。
关键公式:
结果(无监督方法,CAMO:MAE↓/Sm↑/Em↑/Fw↑):FOUND 0.127/0.701/0.784/0.606、UCOS-DA 0.129/0.685/0.782/0.584、UCOD-DPL 0.085/0.764/0.833/0.701 → UCOD-MKD 0.071/0.809/0.875/0.753(MAE 比 UCOD-DPL 降 16%+),零样本设置也有效。
贡献:① 首个用“MLLM + SAM 免费大模型知识”做 UCOD 的教师-学生框架;② CA-CoT 任务定制推理链缓解 MLLM 幻觉;③ GME 无参数分级(quality over quantity,候选一致性 ≈ 质量);④ GKD 图像级/像素级按质量差异化蒸馏;⑤ 推理纯轻量学生,教师零额外开销。
与课题的关系:蒸馏方法论新弹药——“教师不一定要同构大网络”(MLLM/SAM 可当异构知识源);按质量分级学呼应 DSD 的 RAAD“教师不可靠就少学”(强信号强学、弱信号弱学/自蒸馏兜底);过滤低质量伪标签对应负迁移防护。
链接:
- 知识蒸馏(GKD 属 KD 家族;低质量样本用 Self-KD)
- 推理模型深度思考原理笔记(CA-CoT 思维链)
- 论文链接|代码
10. UniRain(CVPR 2026)
📄 完整笔记
基本信息:UniRain: Unified Image Deraining with RAG-based Dataset Distillation and Multi-objective Reweighted Optimization|Qianfeng Yang、Qiyuan Guan、Xiang Chen 等(大连工业大学/南京理工)|arXiv:2603.03967|代码
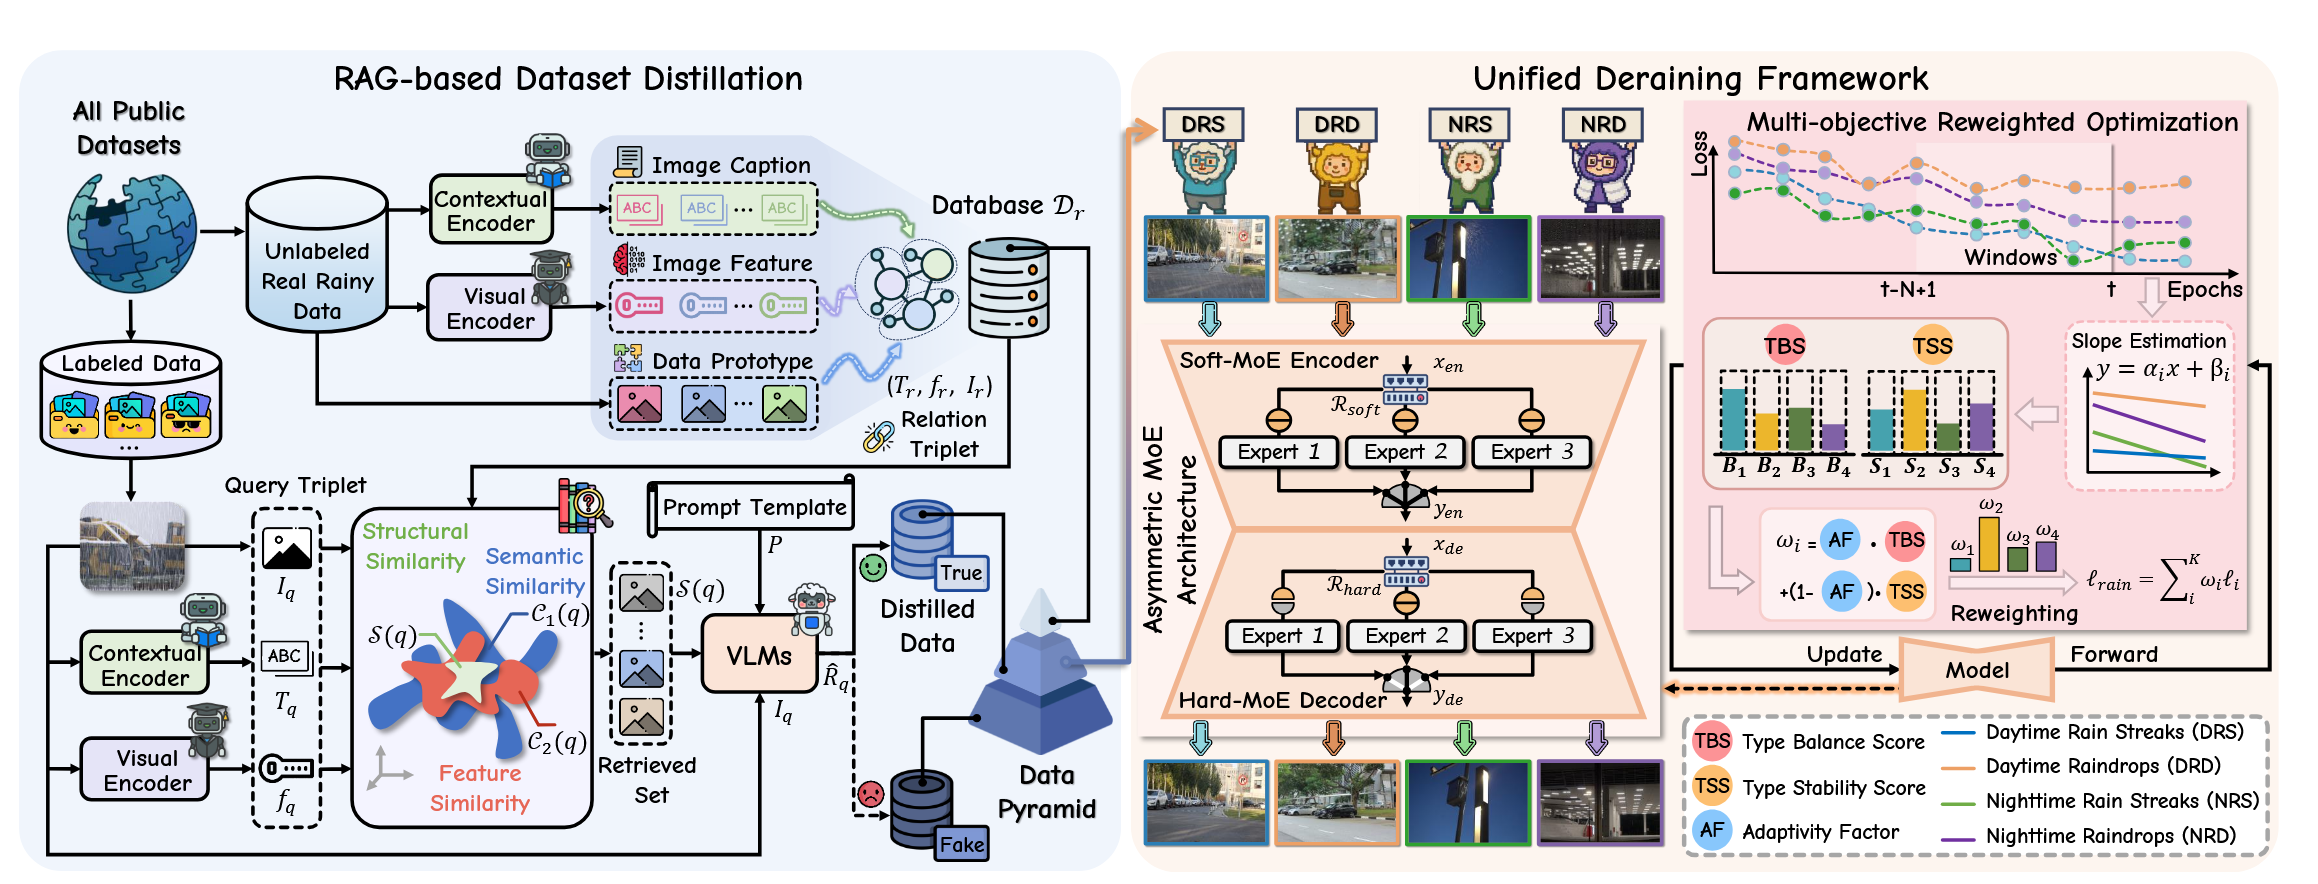
一句话核心:统一图像去雨(一个模型同时处理白天/夜间 × 雨线/雨滴四类退化)——发现”200 万+ 对公开雨图直接混合训练反而更差”,于是 ① 用 RAG+VLM 离线”蒸馏”出 2.6% 高质量样本(RainRAG);② asymmetric MoE(soft 编码 + hard 解码)建模多样退化;③ 训练按各退化类型损失收敛斜率动态重加权,让四类同步收敛。
任务:统一图像去雨(DRS/DRD/NRS/NRD 四类)+ 扩展到雨雪雾 all-in-one;真实基准 RealRain-1k、RainDS-real-RD、WeatherBench。
方法要点:
- RAG 数据蒸馏(核心,注意非综述里”合成数据集”那类蒸馏):真实雨图(无 GT)当”质量标准”建库 → 查询图经三级分层检索(CLIP 文本 L2 → CLIP 视觉余弦 → SSIM)收紧参考集 → 3 个 VLM(InternVL2.5-8B/LLaVA-NeXT-7B/MobileVLM-3B)多数投票判合成样本是否”接近真实分布”——>200 万对筛到 2.6%(52,869 对)RainRAG;
- Asymmetric MoE:Encoder 用 soft-MoE(连续路由,全局池化+高斯噪声负载均衡)穷尽探索多样化退化线索;Decoder 用 hard-MoE(Top-k 硬路由)聚焦结构与细纹理重建——消融 27.54→28.93 PSNR,soft+soft 反而不如;
- Multi-objective Reweighted:四类退化当四个目标,滑动窗口 N=10 内对归一化 loss 做最小二乘回归估计收敛斜率 λ_i → TBS(收敛快的降权/慢的升权,拉齐收敛)+ TSS(发散/震荡类型降权)+ AF(早期 TBS 主导、后期 TSS 介入)→ 只动标量权重、可移植(PromptIR +0.97 dB)。
关键公式:
结果:RainRAG 四类平均 PSNR 28.93(URIR 27.91 / NeRD-Rain 27.65 / Restormer 27.89,DRD 上 +1.35dB);真实基准 RealRain-1k 36.51;FLOPs 126.5G / Params 24.4M(低于 Restormer/DRSformer);all-in-one WeatherBench 26.01(TransWeather 24.70)。
贡献:① 首个 RAG+VLM 数据级”蒸馏”(真实图当质量标准筛合成数据);② asymmetric MoE(soft 编码穷尽探索 + hard 解码聚焦重建);③ 多目标收敛斜率重加权(TBS/TSS/AF,仅标量权重);④ 统一四类雨况 + 雨雪雾扩展。
与课题的关系:有 GT 场景下”质量分级放哪”的另一种答案——训练前离线筛数据(2.6% 高质量子集)而不是 UCOD 式在损失层分级;对 SDGOD 的启发:风格化/扩散合成样本可做离线保真筛选;多目标按子集损失收敛斜率动态调权可平衡各模拟域训练(现有 SE-COT/MR-DCoT/LTFE 都是等权混合,无人做);⚠️ RAG 依赖真实参考库,Single-DGOD 目标域未知时只能借鉴思想不能照搬。
链接:
- 论文阅读:UCOD-MKD(CVPR 2026)(“大模型当质量裁判”跨任务通用:GME 一致性 vs VLM 投票)
- 论文链接|代码