论文:Beyond Weak Supervision: MLLMs-Guided Graded Knowledge Distillation for Unsupervised Camouflaged Object Detection(CVPR 2026) 作者:Huafeng Chen、Chenguang Zhu、Yueming Lyu、Caifeng Shan(南京大学/西工大) 定位:无监督伪装目标检测(UCOD)——用 MLLM+SAM 当教师生成分级伪标签,按质量做差异化蒸馏(方法名 UCOD-MKD)
背景:无监督 COD 的两个顽疾
任务:伪装目标检测(COD)——识别融入环境的物体(保护色动物等)。全监督 COD 需要昂贵的像素级标注;弱监督也要逐图人工标注;UCOD 完全不要标注。
现有 UCOD 方法的两大问题(论文批判):
① 监督信号不足:只能依赖自监督 backbone(DINO),模型灵活性差
② 伪标签利用低效:和全监督差距大,限制实际应用动机:能不能用”免费的大模型知识”(MLLM + SAM)造出高质量伪标签,再按质量分级蒸馏给学生?
核心思想:教师-学生框架(MLLM + SAM → 分级伪标签 → GKD)
教师(全冻结):
  MLLM(Qwen2.5-VL 3B)--CA-CoT--> 定位框 Box
    ↓ Box 当 prompt
  SAM → 多个候选掩码 {V1,V2,V3}
    ↓ GME 质量评估分级
  高质量 Qj=2 / 正常 Qj=1 / 低质量 Qj=0(丢弃)
    ↓ 分级伪标签
学生(可训练 backbone):GKD 按质量差异化蒸馏三大组件:CA-CoT(让 MLLM 会找伪装物)→ GME(评估掩码质量)→ GKD(按质量蒸馏)。
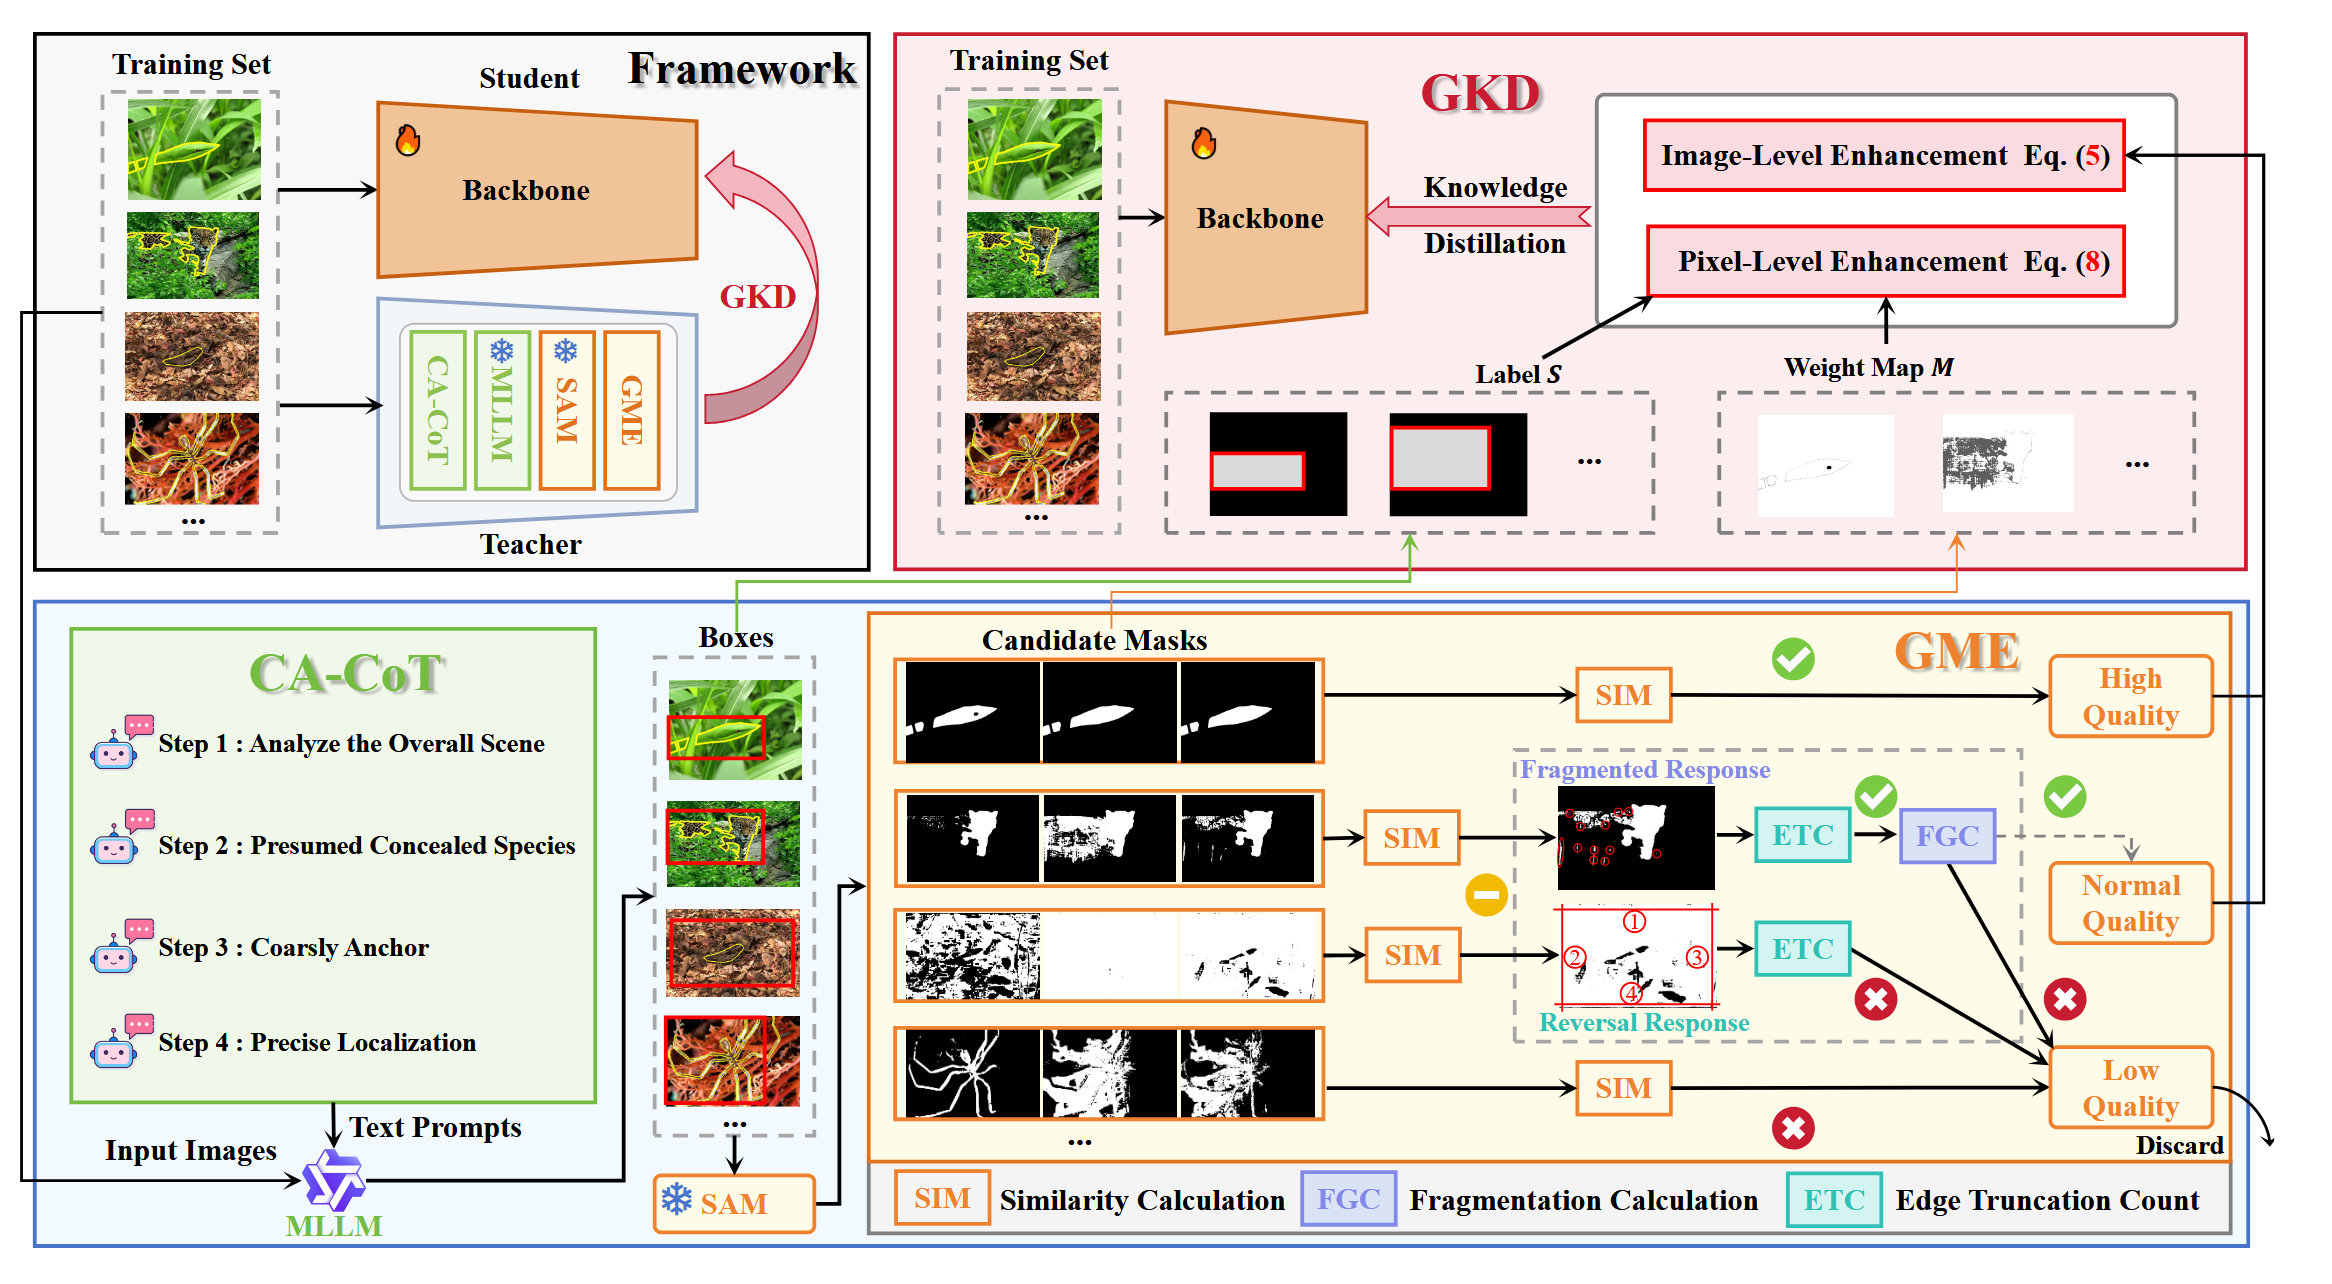
网络架构(冻结/未冻结标注)
                       输入图像(无标注)
                               │
        ┌──────────────────────┴──────────────────────┐
        ▼                                             ▼
  ┌──────────────────────────┐              ┌────────────────────┐
  │ 教师支路(❄️全冻结)        │              │ 学生支路 S(🔥训练)  │
  │                          │              │ 可训练 backbone      │
  │ ① MLLM(Qwen2.5-VL 3B)   │              │ (ResNet50 / PVT V2) │
  │   CA-CoT 提示 → 定位框     │              │ → 特征               │
  │ ② SAM(框作 prompt)       │              │ → 分割头 → 预测掩码   │
  │   → 候选掩码 {V1,V2,V3}   │              └──────────┬─────────┘
  │ ③ GME(质量评估,无参数)   │                         │
  │   SIM(IoU+SSIM) → Sj      │                         │
  │   Qj = 0/1/2(丢弃 0)     │                         │
  └──────────┬───────────────┘                         │
             │ 分级伪标签(图像级 Qj + 像素级权重图)        │
             └─────────── GKD 蒸馏 ────────────────────┘
              (图像级:低质量→SKD / 正常→CE / 高质量→强监督
               像素级:可信像素加权)
             │
             ▼
推理:只用学生 backbone(教师 MLLM+SAM 全退场)冻结状态一览表:
| 组件 | 状态 | 说明 |
|---|---|---|
| MLLM(Qwen2.5-VL 3B) | ❄️ 冻结 | 只做 CA-CoT 推理生成框 |
| SAM | ❄️ 冻结 | 框 → 候选掩码 |
| GME 质量评估 | 🔇 无参数 | SIM/IoU/SSIM 计算,无学习参数 |
| 学生 backbone | 🔥 训练 | ResNet50 / PVT V2,蒸馏对象 |
| 学生分割头 | 🔥 训练 | 输出预测掩码 |
关键设计解读:
- 教师是”基础大模型组合”(MLLM + SAM)——不是同构大网络,而是两个冻结的通用模型拼成”伪标签工厂”;
- GME 无参数:质量评估纯靠候选掩码一致性(IoU+SSIM),不需要训练评估器;
- 推理 = 纯学生 backbone:MLLM/SAM/GME 全部退场,零额外开销(对比需多次推理的 SEE 等);
- 无监督闭环:全程不需要任何人工标注——这是它相对全/弱监督的根本优势。
学生网络结构详解(代码确认,论文未细讲)
论文只写学生是 “trainable backbone network”,实际结构来自官方代码 github.com/2231122/UCOD-MKD(
third_party/ucod_mkd_student/net.py):PVT-V2 backbone(4 个金字塔 stage)+ 轻量 FPN 式解码头。
PVT-V2 的 4 个 stage(backbone 自带的多尺度金字塔):
输入 512×512
  → stage1:1/4 分辨率,64 通道
  → stage2:1/8 分辨率,128 通道
  → stage3:1/16 分辨率,320 通道
  → stage4:1/32 分辨率,512 通道
(代码变量名 bk_stage2~5 是作者计数习惯;extra 的 64/128/320/512 正好对上)
解码路径(backbone 之后特征流向):
4 个 stage 特征(64/128/320/512 通道)
  → extra:4× 3×3 conv,各压到 64 通道(F1~F4)
  → F2/F3/F4 双线性上采样到 F1 分辨率(FPN 风格对齐)
  → 通道拼接 → 256 通道融合特征(feature_map)
  → head:3×3 conv(256 → 1)→ 单通道 logits
→ 上采样回 512×512 → sigmoid → 伪装概率图代码关键段(net.py):
# 解码:4 stage 压到 64 通道
self.extra = nn.ModuleList([conv3x3(64,64), conv3x3(128,64),
                            conv3x3(320,64), conv3x3(512,64)])
# 分割头:256 → 1
self.head = nn.ModuleList([conv3x3(64*4, 1)])

# forward:backbone 出 4 金字塔特征 → 压缩 → 上采样对齐 → 拼接 → 单通道 head
bk_s5, bk_s4, bk_s3, bk_s2 = self.bkbone(x)
F1..F4 = [self.extra[i](bk_sX) for ...]   # 各压到 64 通道
feature_map = cat([f1, f2, f3, f4], dim=1)  # 256 通道
out = F.interpolate(self.head[0](feature_map), size=shape, ...) # → 512 尺寸要点:
- 4 个 stage 是 PVT-V2 自带的(和 ResNet/Swin 的 4 阶段同理),不是论文/代码新设计的;
- 解码器很轻:只有 4 个 3×3 conv + 1 个 3×3 head,无注意力/重模块——参数量 60.3M 几乎全在 PVT-V2;
- 论文中没细讲的部分(学生结构、分割头)由代码补全。
SAM 的角色:为什么 MLLM 出了框还要 SAM?
SAM = Segment Anything Model(分割一切模型,Meta 2023)——输入图像 + 提示(点/框/掩码),输出提示指向物体的像素级分割掩码。
关键区别:框 ≠ 像素掩码:
MLLM 输出(CA-CoT 第 5 步):bbox_snake = [10, 200, 350, 450]
  ↑ 只是【矩形坐标】——伪装物大致在这片区域
  ↑ 语言模型不擅长像素级分割

但 UCOD 训练学生【分割网络】需要的是【像素级掩码】:
  每个像素标记"是/不是伪装物"
  ↑ 只有掩码才能当分割训练的真值
分工:MLLM 是”向导”,SAM 是”雕刻师”:
| MLLM | SAM | |
|---|---|---|
| 强项 | 看懂场景、推理”哪里有伪装物” | 像素级分割(抠轮廓) |
| 输出 | 框坐标(粗糙) | 精确掩码(像素级) |
| 短板 | 不会做像素分割 | 不知道”该分割什么”(要 prompt) |
单靠任何一个都不行:MLLM 会找但不会分割;SAM 会分割但不会自己”发现”伪装物。
那为什么还要 CA-CoT + GME?——SAM 在伪装场景对 prompt(框)很敏感:框不准 → SAM 分割不稳定(犹豫要不要把背景分进去)。所以 CA-CoT 先把 MLLM 的框变准,GME 再把 SAM 出的差掩码滤掉,剩下的高质量掩码才用来蒸馏学生。
模块①:CA-CoT——Camouflage-Aware Chain-of-Thought(让 MLLM 会找伪装物)
动机:MLLM 视觉定位有幻觉和抖动,伪装场景下更严重。论文设计纯文本提示的 CoT,模拟人类感知过程,几乎不增加计算开销。
5 步推理(模拟人类”全局→局部、粗→精”的感知):
阶段一:全局场景 → 局部物体(推理)
  STEP 1:分析整体布局,推断场景(森林/沙漠)→ "Tropical or forested; reptiles..."
  STEP 2:基于场景推断可能的伪装物类型 → "蛇会融入环境"
阶段二:粗定位 → 精定位(感知)
  STEP 3:利用颜色/纹理与背景的相似性【粗锚定】潜在物体 → "蛇斜藏在叶子间"
  STEP 4:聚焦几何特征(边界/形状/大小)确定完整范围 → "蛇细长,身体融入叶子"
  STEP 5:返回 bbox 坐标 → "bbox_snake = [10, 200, 350, 450]"
与 CVP 的 CoVP 区别:CoVP 只强化提示里的伪装概念,没有逐步推理;CA-CoT 是真正的分步思维链(纯文本,几乎零额外成本)。
模块②:GME——Graded Mask Evaluator(评估 + 分级掩码)
动机:CA-CoT 仍有不准的框 → 级联错误 → SAM 生成极低质量掩码。COD 蒸馏遵循 quality over quantity——极低质量掩码严重拉低蒸馏效果,要滤掉。
关键观察:不准确的框会让 SAM 分段不稳定(候选掩码之间相似度低)——候选掩码相似度 ↔ 掩码质量强相关(Fig. 5 验证)。
质量评估(式 2-3)——用 IoU + SSIM 衡量候选掩码两两相似度:
三档分级(式 4):
三个候选掩码来自同一张图(SAM 对同一 box 的不同输出)——相似度高 = SAM 分割稳定 = 质量高。有点类似一致性检验,投票。
模块③:GKD——Graded Knowledge Distillation(按质量分级蒸馏)
动机:传统 KD 对所有样本/像素一视同仁 → 伪标签利用不足。GKD 从教师提取先验,在图像级 + 像素级做差异化增强。
图像级增强(按样本质量分级,式 5)
从 GME 拿质量档 Qj,对不同样本用不同损失策略:
| 质量档 | 损失 | 大白话 |
|---|---|---|
| 低质量 Qj=0 | Self-KD:(P_j 学生预测,P’_j 图像增强后预测) | 伪标签不可信,但图像内容有价值——用自蒸馏逼学生对”原图”和”增强图”预测一致,保住图像信息 |
| 正常 Qj=1 | CE: | 常规监督(对 SAM 掩码) |
| 高质量 Qj=2 | CE + L1 + MSE 三重损失 | 质量高就放心给强监督——三种损失从不同角度(分类/边界/像素值)压学生 |
像素级增强(式 6-8)
观察:MLLM 的失败主要是过度定位(over-localization)——框画大了没关系,框外像素几乎一定是背景(很可靠)。于是构建框外背景监督 + 像素级可信度加权:
① 框外背景先验 S:只把框外的背景像素标为”背景”,作为额外监督——框内可能错,框外几乎不会错。
② 像素级熵图权重 M:候选掩码里不同像素可信度不同,用熵度量不确定性:
- 三个候选掩码平均 → 每像素的平均置信 V̄
- 熵 Ei 高 = 像素在三候选间摇摆(不确定,如边界)→ 权重低
- 熵低 = 稳定像素(确定是前景/背景)→ 权重高——稳定像素更可靠
最终像素级损失(式 8):
- 第一项:候选掩码监督 × 像素权重图 M(可信像素多学、边界少学)
- 第二项:框外背景先验 S 的监督(额外可靠信号)
核心原则:“质量优先于数量”——不是所有伪标签都值得蒸馏:极低质量的整个样本降级(SKD 兜底);边界等不可信像素降权(M 加权);框外可靠背景单独当监督(S)。
训练/推理
训练(无任何人工标注):
① 教师离线/在线生成:MLLM(CA-CoT) → 框 → SAM → 候选掩码
② GME 评估分级:Qj = 0/1/2(丢弃 Qj=0 的掩码)
③ GKD 蒸馏:图像级(SKD/CE/强监督)+ 像素级(权重图)→ 更新学生 backbone

推理:只用学生 backbone(轻量)——教师(MLLM+SAM)不参与教师:Qwen2.5-VL 3B(MLLM)+ SAM(全冻结);学生:可训练 backbone(ResNet50 / PVT V2)。
实验要点
数据集:CAMO、COD10K、NC4K 等(UCOD 评估),指标 MAE/Sm/Em/Fw。
主结果(无监督方法对比,CAMO):
| 方法 | MAE | Sm | Em | Fw |
|---|---|---|---|---|
| FOUND | 0.127 | 0.701 | 0.784 | 0.606 |
| UCOS-DA | 0.129 | 0.685 | 0.782 | 0.584 |
| UCOD-DPL | 0.085 | 0.764 | 0.833 | 0.701 |
| UCOD-MKD(Ours) | 0.071 | 0.809 | 0.875 | 0.753 |
大幅超现有无监督方法(比 UCOD-DPL 的 MAE 降 16%+);零样本设置下也表现好。
与”蒸馏 + Single-DGOD”课题的联系
| UCOD-MKD 的方法 | 迁移到检测/单域泛化的机会 |
|---|---|
| 教师 = MLLM + SAM(基础大模型) | 蒸馏教师不必同构——大模型教师(VLM/分割模型)可作为 SDGOD 的知识源 |
| 质量分级蒸馏(GKD) | 对应 DSD 的 RAAD”教师不可靠就少学”——伪标签/教师输出按质量分级,强信号强学、弱信号弱学/自蒸馏 |
| quality over quantity | 蒸馏不是越多越好——过滤不可靠监督信号(呼应负迁移防护) |
| CA-CoT(任务定制推理链) | CoT 思想可定制到检测任务(SE-COT 的风格 CoT 是另一个例子) |
一句话总结
UCOD-MKD 用 MLLM(CA-CoT 分步推理找伪装物)→ SAM(出候选掩码)→ GME(按候选一致性分级,丢弃低质量)→ GKD(图像级/像素级按质量差异化蒸馏),把”免费的大模型知识”变成可靠的分级伪标签,训练轻量学生做无监督伪装目标检测——大幅超 UCOD SOTA,且零样本也有效。
相关资料
- 论文(CVPR 2026 OpenAccess):Chen_Beyond_Weak_Supervision_…
- 官方代码:github.com/2231122/UCOD-MKD(Stage_1 Qwen 出框 → Stage_2 SAM 单/多掩码 → Stage_3 GME 分级 → Stage_4 监督包 + BeKD 训练;学生网络在
third_party/ucod_mkd_student/net.py,PVT-V2 实现)
延伸阅读
- 知识蒸馏(GKD 属 KD 家族;低质量样本用 Self-KD 对应博客”Self-Distillation”一节)
- 推理模型深度思考原理笔记(CA-CoT 的思维链推理)
- 学习笔记解析大型语言模型(MLLM 教师)