论文:UniRain: Unified Image Deraining with RAG-based Dataset Distillation and Multi-objective Reweighted Optimization(arXiv 2603.03967,2026-03) 作者:Qianfeng Yang、Qiyuan Guan、Xiang Chen、Jiyu Jin、Guiyue Jin、Jiangxin Dong(大连工业大学 / 南京理工) 定位:统一图像去雨(unified image deraining)——一个模型同时处理”白天雨线/雨滴 + 夜间雨线/雨滴”四类退化。用 RAG(检索增强生成)+ VLM 做数据集蒸馏(筛数据)解决混合数据质量参差,用多目标重加权优化解决多退化类型训练不平衡。
一句话总结
UniRain 发现”把 >200 万对公开雨图直接混合训练反而更差”(质量参差 + 类型不平衡),于是:① 用 RAG+VLM 从海量混合数据中离线”蒸馏”出 2.6% 高质量样本(RainRAG 数据集)→ ② 用 asymmetric MoE(soft 编码 + hard 解码)建模多样退化 → ③ 训练时按退化类型的收敛斜率动态重加权,让四类退化同步收敛,最终统一去雨 + 扩展到雨雪雾 all-in-one。
背景与动机(两个”统一”难题)
难题一:数据。 去雨数据集(合成 + 真实)超过 200 万对,但质量参差:
直接合并所有 public 数据集训练 → 数据量 ↑ 但质量参差
  → 低质样本给出不准的监督 → 干扰收敛、弱化跨雨况泛化(Fig.1b PSNR 反而下降)
难题二:模型/优化。 四类退化(DRS 白天雨线 / DRD 白天雨滴 / NRS 夜间雨线 / NRD 夜间雨滴)难度与收敛速度不同:
同一优化目标训练 → 模型偏向简单类型(夜间雨线收敛快)
  → 复杂类型(白天雨滴)欠优化 → 各类恢复质量不均(Fig.1c,d)
大白话:堆数据不行(脏数据多),一刀切训练不行(类型不平衡)。所以要”筛出干净数据” + “按类型动态平衡训练”。
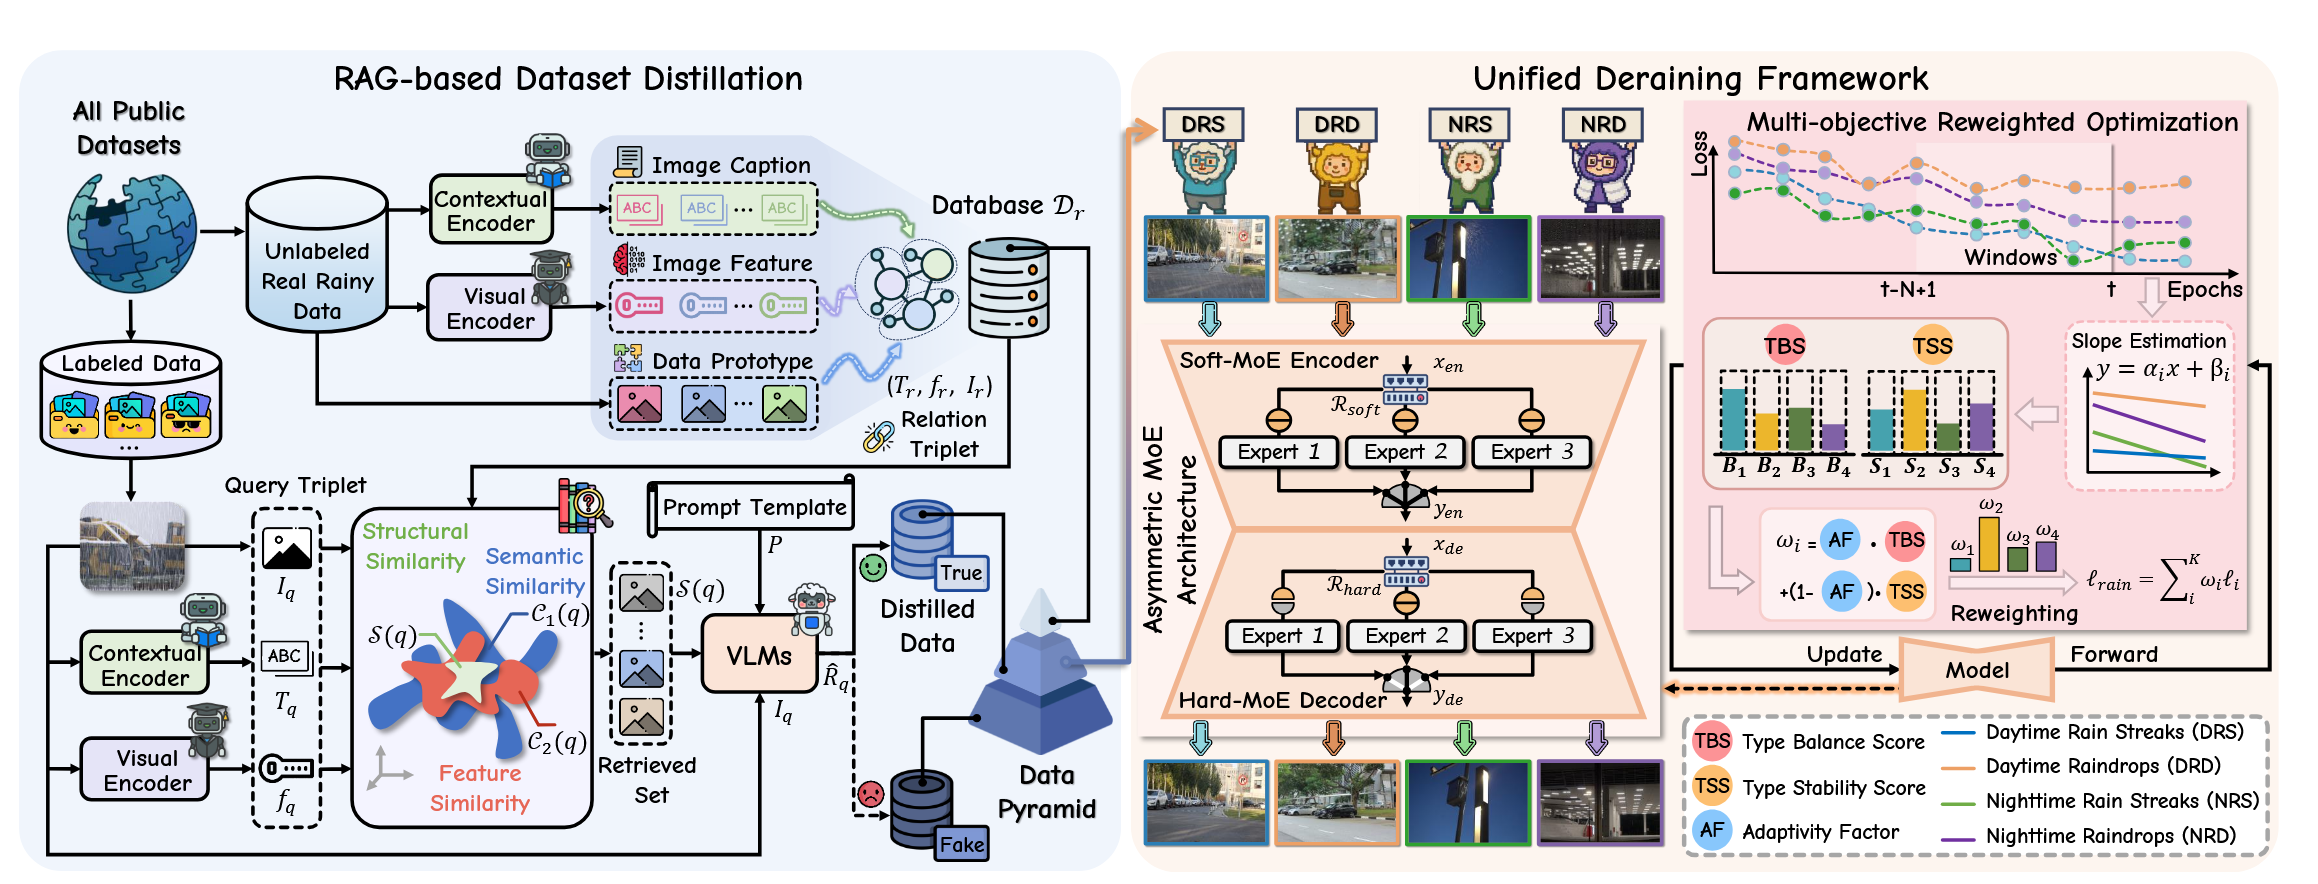
组件①:RAG-based Dataset Distillation(数据蒸馏管线,核心创新)
该阶段的目的是真实图没有GT,合成图有GT,但是合成图可能质量太差,所以我们用真实图去选择高质量合成图
术语提醒:这里的 “Dataset Distillation” 不是 dataset-distillation 综述里”用合成小数据集压缩学习信号”那类方法,而是 “从海量公开数据中检索 + VLM 评估 + 筛选高质量训练子集”(更接近 data selection / data refinement)。共两个阶段:
检索阶段(Retrieval)——用真实雨图当”质量标准”
建库:真实世界雨图(无 GT)I_r
  → BLIP 上下文编码器生成文本描述 T_r
  → CLIP 视觉编码器提取特征 f_r
  → 存关系三元组 (T_r, f_r, I_r) → 数据库 D_r

查询:查询图 I_q 同样生成三元组 (T_q, f_q, I_q)
  → 三级分层检索,逐步收紧:
    ① 语义相似  s_txt(q,r) = ‖ψ(T_q) − ψ(T_r)‖₂     (CLIP 文本 L2)   → top-K1 → C1
    ② 视觉相似  s_vis(q,r) = cos(f_q, f_r)            (CLIP 特征余弦)   → top-K2 → C2
    ③ 结构相似  s_perc(q,r) = SSIM(I_q, I_r)          (像素结构 SSIM)   → top-K3 → S(q)
三级从”语义/场景”→“外观/类别”→“像素结构”逐层逼近,保证检索到的真实参考与查询雨况一致。最后只把K3条喂给VLM
生成/评估阶段(Generation)——VLM 投票判质量
输入:查询图 I_q + 检索集 S(q) + prompt 模板 P → VLM
VLM 输出二元判断(该合成样本是否"可靠/接近真实分布")
集成:3 个 VLM 多数投票(InternVL2.5-8B / LLaVA-NeXT-7B / MobileVLM-3B)
R̂_q = 1 当且仅当 ≥2 个模型判定可靠 (式 5)数据质量金字塔(分层递进):
顶层:真实雨图(最可信,直接当参考)
中层:被 VLM 判定为"高质量、接近真实分布"的合成样本 → 留下训练
底层:低保真合成样本 → 丢弃结果:>200 万对 → 保留约 2.6%(52,869 对),按 DRS/DRD/NRS/NRD 四个子集组织成 RainRAG 训练集;测试集 400 对按同流程筛选均分四类。
关键洞察:真实数据没有 GT 不能直接训练,但能当”质量标准”——用真实雨图做检索参考 + VLM 评判合成样本与真实的接近度,把”合成→真实”的鸿沟转成可操作的数据筛选。
组件②:Asymmetric MoE(非对称混合专家架构)
| 位置 | 路由方式 | 作用 |
|---|---|---|
| Encoder | soft-MoE:连续路由权重(全局池化 + 高斯噪声做负载均衡 + softmax,式 11-12) | 所有专家加权融合 → 穷尽探索多样的退化线索 |
| Decoder | hard-MoE:Top-k 硬路由(式 13-14) | 只激活最相关专家 → 高效聚焦结构与细纹理重建 |
消融(Table 6):无 MoE 27.54 PSNR → 全量 28.93;soft+soft 反而不如 hard+soft(soft 编码器全面探索 + hard 解码器选择性重建 = 互补)。
组件③:Multi-objective Reweighted Optimization(多目标动态重加权)
把”四类退化”当四个目标,训练中按收敛速度动态调权,让四类同步收敛:
1) 收敛斜率估计:滑动窗口 N=10 内对归一化 loss 做最小二乘线性回归 → 斜率 λ_i(t)
   λ<0 收敛中;λ>0 发散;|λ| 大 = 变化快

2) 三个指标:
   TBS(类型平衡分)= softmax(λ_i / Σ|λ_i|) 沿类型维
      → 收敛快的类型权重小、收敛慢的类型权重大 → 拉齐收敛
   TSS(类型稳定分)= softmax(−Σ|λ_i|) 沿类型维
      → 发散/震荡的类型降权 → 防止"快但发散的坏类型"拿高分
   AF(自适应因子)≈ 全局发散程度的 softmax
      → 训练早期全局都收敛 → AF 大 → TBS 主导;
        后期部分类型发散 → AF 小 → TSS 介入

3) 最终类型权重:ω_i(t) = AF(t)·TBS_i(t) + (1−AF(t))·TSS_i(t)
与”多任务梯度操作(PCGrad 等)/课程学习”同类家族,但简单在只动标量权重、只依赖 loss 斜率。消融:固定 AF=0.5 或去掉 TBS/TSS 均掉点(Fig.7);该策略可移植到 PromptIR 上 +0.97 dB,优于 continual learning(PIGWM)设定。
实验要点
| 项 | 结果 |
|---|---|
| RainRAG 四类平均 | PSNR 28.93(URIR 27.91 / NeRD-Rain 27.65 / Restormer 27.89),DRD 上比 Restormer +1.35dB |
| 真实基准 | RealRain-1k 36.51、RainDS-real-RD 33.74、WeatherBench 上领先 |
| 复杂度 | FLOPs 126.5G、Params 24.4M(低于 Restormer/DRSformer/NeRD-Rain) |
| RAG 消融 | only VLM 27.73 / w/o 检索 28.39 / w/o 生成 28.36 / full 28.93 |
| 泛化场景 | 驾驶 / UAV / 海上场景视觉质量领先 |
| 扩展 | all-in-one weather(雨+雪+雾)WeatherBench PSNR 26.01(TransWeather 24.70 / Histoformer 24.59) |
与我们课题(蒸馏 + 单域泛化目标检测)的关系
这篇任务不同(低层恢复 vs 高层检测),但它恰好回答了我们之前撞的墙——“有明确 GT 时,质量分级该放哪?”:
1. 它的答案:把质量控制放到”离线数据构建层”,而不是”训练损失分级层”。 去雨的合成对有 GT(干净图),仍会因”合成真实度参差”拖累训练——和你们”源域有 GT、但风格化合成样本保真度参差”同构。UniRain 没有在 loss 层做三档路由,而是训练前用 RAG+VLM 一次性筛掉不可靠样本(2.6% 留下)。这给了 SDGOD 一个有 GT 时更自然的移植:对风格化/扩散合成样本做离线保真筛选(用固定代理打分,不随训练动态耦合),而不是 UCOD 式在损失上分级。
2. 多目标重加权视角(可能对 SDGOD 是新的):把”多种风格/域的合成子集”当多个训练目标,按各子集损失收敛斜率动态调权——解决”模型偏向简单的模拟域、复杂模拟域欠拟合”。你们现有方法(SE-COT/MR-DCoT/LTFE)都是等权混合模拟域训练,没人按收敛速度平衡各模拟域——这个机制(TBS/TSS/AF,仅标量权重、易实现)是可迁移的空白点。
3. 检索真实参考不可直接迁移 ⚠️:RAG 依赖”与目标分布一致的真实数据”建库;Single-DGOD 假设目标域未知、无真实数据可用——除非把”真实库”换成源域数据/通用语料(性质变弱)。此部分只能借鉴”参考引导评估”思想,不能照搬。
4. 与蒸馏主线的关系:UniRain 的”数据蒸馏”不是网络蒸馏;但它证明了 VLM 可当数据质量裁判(多模型投票)——呼应 UCOD-MKD 的 GME(模型一致性当质量代理),说明”大模型当质量裁判”是跨任务通用的趋势。
局限/批判
- 测试集自筛风险:RainRAG 测试集 400 对用”同一套过滤流程”选出——与训练筛选同源,存在选择性偏差(自证式评估);好在还报了 3 个公开真实基准兜底。
- VLM 判断是黑箱:“可靠”标签由 3 个 VLM 多数投票给出,prompt 主观、无标注可校验;若 VLM 系统性地偏爱某种雨况,筛出的数据会偏。
- 成本:>200 万图 ×(BLIP/CLIP 编码 + 检索 + 3×VLM 推理),一次性成本可观(论文未报)。
- 符号/venue 混乱:PDF 标 CVPR2026、正文表标 AAAI 2025、arXiv 编号 2603.03967,引用时需核实最终出处。
- 对 SDGOD 的适用性边界:低层恢复的”质量”可由像素 GT 定义,检测的”域外样本保真”更复杂(要判语义保持);且其 VLM/文本依赖会撞上 LTFE 对”未知域文本先验”的批评。
相关资料
- arXiv: 2603.03967(文件标注 CVPR 2026)
- GitHub: github.com/QianfengY/UniRain
- 作者主页: https://lowlevelcv.com/