本文主要整理自 B 站视频《【大白话 03】一文理清强化学习 RL 基本原理 | 原理图解+公式推导》,并在原视频基础上补充了一些例子和公式解释,方便之后继续学习 DQN、Policy Gradient、PPO、GRPO 等算法。(哔哩哔哩)
下一篇 《从 PPO 到 DPO、GRPO:大模型强化学习到底在优化什么?》 会在这个基础上继续:PPO 的 Clip 与 GAE、DPO 的直接偏好优化,以及 GRPO 如何用组内相对 Advantage 省掉 Critic。
一、强化学习是什么:试错、奖励与长期规划
强化学习(Reinforcement Learning,RL)研究的是这样一个问题:
一个智能体应该如何不断和环境交互,从而学会一套能够获得最大长期收益的行为策略?
它和传统监督学习最大的区别是:监督学习直接告诉模型「正确答案是什么」——比如「这是一张猫的图片 → 标签:猫」,模型只需要学习 的映射。而强化学习不会直接告诉你「当前状态必须执行动作 A」,它只会在你做完之后给出反馈:
你刚才干得不错:+10 分
你刚才干得很差:-10 分
所以强化学习实际上更像:
试错 + 奖励反馈 + 长期规划。
比如训练一个 AI 玩《原神》:AI 当前看到「前方有怪物、左边有宝箱、右边可以逃跑」,它可能选择攻击、捡宝箱或逃跑,然后环境给出奖励(击败怪物 +10、死亡 -100、捡到宝箱 +5)。经过大量尝试以后,AI 会慢慢学会:
在什么状态下,执行什么动作,长期来看收益最高。
这就是强化学习最核心的问题。
1.1 交互流程:Agent 与环境
强化学习包含两个核心对象:Agent(智能体)和Environment(环境)。整个过程可以理解成:
        action
Agent -----------> Environment
  ^                    |
  |                    |
  | state + reward     |
  +--------------------+
在第 个时间步:智能体观察到状态 ,根据策略选择动作 ;环境执行动作后给出奖励 ,同时状态变为 。于是一次完整交互可以写成:
然后继续循环。
1.2 Policy:策略到底是什么?
策略 Policy 通常写成 ,表示:
在状态 下,选择动作 的概率。
假设游戏里「角色剩余 10% 血量、敌人还有 80% 血量」,策略可能给出:攻击 0.1、防御 0.2、逃跑 0.7。于是 ,说明当前策略认为在这个状态下逃跑可能是比较好的选择。Policy 不一定是确定的——它可以是 (确定性),也可以是一个概率分布。
1.3 状态转移:环境的规则
除了策略,还有另一个概率 ,表示「在状态 下执行动作 后,环境转移到状态 的概率」。例如原神里「下雨天急刹车」——哦不,这是开车场景——换个例子:原神里「当前在下雨天,角色使用冲刺」,环境可能有 80% 概率保持干燥、20% 概率沾上水元素(这只是为了让「 和 是两个不同的东西」更直观):
- :描述 Agent 怎么做决策
- :描述 环境怎么变化
1.4 MDP:强化学习的数学框架
很多强化学习问题都会被建模成 Markov Decision Process(马尔可夫决策过程),通常写成:
其中 是状态集合(State)、 是动作集合(Action)、 是状态转移概率、 是奖励(Reward)、 是折扣因子(Discount Factor)。MDP 的核心假设是马尔可夫性:当前状态已经包含做决策所需的全部信息,预测下一状态不需要翻出整个历史。
二、为什么不能只看眼前:Return、折扣因子与价值函数
2.1 只看眼前会吃亏
假设有两个动作:动作 A 立即获得 +10 但之后 -100;动作 B 立即获得 0 但之后 +20、+20、+20、+20。如果只看即时奖励,A(+10)比 B(0)好;但看长期收益:A 是 ,B 是 ——B 更好。
所以强化学习真正优化的不是 ,而是未来累计奖励。这一点在原神里也很常见:比如为了拿满深渊满星,前期可能要放弃一些眼前的小收益(不急着开某些宝箱),把资源和角色练度投入到更长期的规划里。
2.2 Return:累计回报与折扣因子
定义从时间 开始的累计回报:
其中 叫做折扣因子。为什么需要 ? 因为现在的奖励比很久以后的奖励更加确定——「今天给你 100 元 vs 十年以后可能给你 100 元」,大部分人都会选今天。所以让越远的奖励权重越低。比如 时,未来各步的权重是:现在 1、下一步 0.9、下下步 0.81、再下一步 0.729……越远影响越小。
2.3 V 和 Q:状态价值与动作价值
State Value(状态价值):
把它逐步展开看: 是关于「策略选出的动作 」和「环境转移出的状态 」的随机变量,所以期望要对这些随机变量同时求:
其中 是从时刻 开始的累计回报(即前面的 ,换了个记号方便推导)。最后一步用到了: 在 条件下的期望就是 。再把这个期望按「动作的概率 + 状态转移的概率 」展开成求和:
其中 是「在状态 执行动作 后奖励的期望」。这个展开式其实就是 Bellman 方程 的显式写法。
意思是:如果现在处于状态 ,以后一直按照策略 行动,最终能得到多少累计奖励。它衡量的是这个状态值不值得待。
Action Value(动作价值):
同样逐步展开:这里动作 已经固定,随机性只来自后续状态和动作:
展开成求和:
即:本步奖励的期望 + 折扣 × 所有可能下一状态 × 策略选择下一动作的价值期望。
意思是:当前位于状态 ,先执行动作 ,之后继续按照策略 行动,最终能获得多少回报。它衡量的是这个动作好不好。
举个例子:站在岔路口,三个动作的 Q 值分别是 、、,那么显然 应该往右走。所以 Value-based 强化学习最核心的思想非常简单:
给每一个动作打分,然后选分数最高的动作。
2.4 V 和 Q 的关系
状态价值 实际上就是「当前状态下,把所有可能动作的 Q 值按照策略概率加权平均」:
例如:
| Action | ||
|---|---|---|
| 左 | 0.2 | 2 |
| 右 | 0.7 | 10 |
| 前 | 0.1 | -1 |
那么 。可以粗略理解成:
V(s):这个状态整体有多好
Q(s,a):在这个状态下执行某个动作有多好
三、Bellman 方程:把「无限长的未来」拆成一步
这是强化学习里最重要的公式之一。
我们刚才定义 ,把后面部分提出来:
而括号里面其实就是 ,所以:
于是价值函数可以写成:
这就是 Bellman 方程背后的核心思想。用一句大白话解释:
当前状态的价值 = 当前能获得的奖励 + 下一状态的未来价值。
它把一个非常困难的问题「从现在开始一直到游戏结束总共能得到多少奖励?」递归地拆成「一个一步问题 + 一个稍小的问题」,很多强化学习算法本质上都在利用这个结构。
举个例子帮助理解:站在「打 BOSS 前」这个状态,它的价值 = 现在打 BOSS 获得的奖励(掉落物)+ 折扣后的「打完 BOSS 后新状态」的价值(比如下一步去领奖励、或者残血状态的价值)。不需要真的把整局游戏全部展开,只要知道下一步状态值多少就行。
四、Monte Carlo:玩完一整局再总结
Monte Carlo(MC)的想法非常符合直觉:
先把整局游戏玩完,再回来看看之前的状态到底值多少。
4.1 怎么估计一个状态的价值
假设经历了一局游戏:
S1 → S2 → S3 → Game Over
奖励:0    0    +10
那么对于 S1:,如果 ,则 。于是可以说「这次从 S1 出发最后获得了 10 分,所以 S1 的价值大概是 10」。多玩几局再取平均:
4.2 一个例子:训练 AI 玩原神深渊
训练一个 AI 打深渊:某一房间从第 1 层一路打到第 3 层,最后胜利 +1。MC 的做法是:等第 3 层下完以后,发现这一局赢了,然后回头告诉前面所有经历过的状态「你们最后带来了胜利」;如果输了(Reward = -1),就把失败的信息传播回去。所以 MC 的特点是:
必须等整个 Episode 结束。
4.3 优缺点
MC 使用的是真实最终回报 ,不需要猜下一状态值多少钱,因此 Bias 较低。但同一个状态的结果可能波动很大(第一局 +100、第二局 -50、第三局 +20、第四局 -100),所以 Variance 较高。可以记成:
Monte Carlo:看完整条轨迹 → 真实回报 → 低 Bias、高 Variance(multi-step)4.4 最大的问题:等不起
想象一个一局需要 5 小时的游戏(比如原神的每日委托:接任务、跑图、找 NPC、对话、打怪、找物品、提交,整个流程 20 分钟)——如果使用 MC,第 1 分钟发生的动作必须等 20 分钟(甚至 5 小时)之后才能知道它到底好不好,训练效率很低。更麻烦的是:有些任务根本没有「结束」,比如机器人长期运行、服务器资源调度、自动驾驶、工业控制,Episode 理论上可以无限持续,MC 很难直接使用。
于是产生了一个非常重要的思想:
为什么一定要等到最后?
这就是 Temporal Difference Learning。
五、TD:走一步学一步
Temporal Difference(TD)与 MC 的区别:
MC:等游戏结束 → 看到真实结果 → 更新价值
TD:走一步 → 观察 reward 和下一状态 → 马上更新
5.1 TD Target 与更新公式
根据 Bellman 方程 ,TD 构造一个目标:
然后更新:
其中中括号里的:
叫做 TD Error,也就是「新的估计 − 旧的估计」。如果 ,说明这个状态实际比之前想象得更好;如果 ,说明没有之前认为的那么好。于是 不断修正价值函数。
5.2 TD 的数字例子
假设 ,当前从 A 执行动作后获得 reward = 2,进入 B,而 、。那么 TD Target:
说明按照最新信息来看,A 的价值应该接近 7.4 而不是原来的 5。假设 :
于是 A 的价值从 5 慢慢向 7.4 移动——没有一步到位,而是慢慢学。
5.3 为什么 TD 不需要等游戏结束
因为它使用 来估计后面的未来。比如 ,到 S2 以后不需要继续走到 S100,因为「我已经知道 S2 大概值 8 分」,那么 。这叫做 Bootstrapping:
利用已有估计去更新新的估计。
在原神里就像:打完一个小怪就立刻根据当前血量和下一段路的经验更新「这个位置值多少钱」,不用等整个委托做完。
5.4 MC vs TD:经典对比
| Monte Carlo | TD | |
|---|---|---|
| 是否等待 Episode 结束 | 是 | 否 |
| 更新时机 | 一局结束 | 每一步 |
| Target | 实际 Return | Reward + 下一状态估值 |
| Bootstrap | 否 | 是 |
| Bias | 较低 | 较高 |
| Variance | 较高 | 较低 |
可以形象地理解:MC 像考试以后「整张卷子做完 → 出最终成绩 → 再总结哪里做得好」;TD 像老师坐你旁边「你做一道题 → 老师马上反馈 → 立即调整」。
5.5 为什么 MC 高方差低偏差、TD 低方差高偏差
MC 使用实际发生的完整轨迹 ,没有用另一个估计值去猜未来,所以 Bias 低;但一条轨迹可能受大量随机因素影响(原神里你的操作完全一样,第一局遇到简单敌人 +100、第二局随机刷出 BOSS -100),所以 波动非常大,Variance 高。
TD 只需要观察一步 ,随机因素少很多,Variance 较低;但问题在于 本身就是估计出来的——如果它估错了, 也可能跟着估错,于是引入 Bias。可以记成:
MC:相信真实结局 → 偏差小 → 波动大
TD:相信自己的估计 → 波动小 → 但可能估错
六、从 V 到 Q:SARSA、Q-Learning 与 DQN
前面的 TD 可以更新 ,但真正做决策的时候,更希望知道 ——因为我们最终要决定「当前状态下到底选哪个 Action」。于是可以写出类似的 TD 更新:
问题变成:Target 应该怎么算? 不同算法对此给出了不同答案,于是产生 SARSA 和 Q-Learning。
6.1 SARSA:按照「我实际上会怎么走」学习
SARSA 的名字来自五个变量:
也就是 State、Action、Reward、State、Action——所以叫 SARSA。它的 Target 为:
于是更新:
SARSA 会问:
按照我现在这套策略,下一步实际上会执行什么动作?
假设到达 ,当前策略因为要探索(10% 随机行动、90% 选择最优行动),这一次实际选择了 ,于是 SARSA 使用 作为未来价值。所以:
SARSA 学习的是「当前策略真实会产生什么结果」,属于 On-policy。
6.2 Q-Learning:按「理论上的最优动作」学习
Q-Learning 的更新公式:
和 SARSA 最大的区别就在 Target:SARSA 用 (实际选的),Q-Learning 用 (最优的)。
6.3 数字例子:理解两者的区别
假设角色来到状态 ,三个动作:左 Q=3、右 Q=10、前 Q=5。但是为了探索,Agent 这次随机选择了「左」。
- SARSA 会使用 ,因为「我实际就是选了左」,于是 。
- Q-Learning 则不管实际选了什么,它会说「如果我以后每次都做最优决策,那么应该选右」,因此 ,。
所以:
- SARSA 学习「当前正在执行的策略」→ On-policy(行为策略 = 目标策略)
- Q-Learning 行为策略可能在探索(偶尔随机行动),但学习目标却是「每次都选择最大 Q 的策略」→ Off-policy(行为策略 ≠ 目标策略)
6.4 经典悬崖例子
假设地图:
Start ---------------- Goal
      Cliff Cliff Cliff
掉进悬崖 ,正常移动 。这就像原神里走峭壁捷径:贴着悬崖边沿走最快(Q-Learning 认为「只要每一步都执行最优动作,沿悬崖边缘走最快」,于是学到贴着悬崖走);但 SARSA 会考虑「我的 -greedy 策略偶尔会随机行动,如果贴着悬崖,随机一步就可能掉下去」,所以它可能学到绕远一点但更安全的路线。
这很好地体现了:
SARSA:考虑当前探索策略真正会发生什么
Q-Learning:学习理想情况下的最优策略
6.5 DQN:用神经网络替代 Q Table
传统 Q-Learning 可以维护一张 Q Table,例如:
| State | Left | Right | Jump |
|---|---|---|---|
| S1 | 1 | 5 | 3 |
| S2 | -1 | 2 | 8 |
| S3 | 4 | 7 | 2 |
但是现实问题中状态空间可能巨大——比如输入一张 的游戏画面,所有可能状态几乎无法枚举,不能再存 Q Table。怎么办?使用神经网络 :输入状态,由神经网络预测每个动作的 Q 值。这就逐渐引出了 Deep Q-Network(DQN)。因此可以把路线理解成:
Bellman Equation → TD → Q-Learning → Neural Network → DQN七、Value-based 的局限与 Policy-based 路线
7.1 为什么需要 Policy-based
Value-based 最大的问题是:它主要解决 ,然后 ——对离散动作非常自然(上、下、左、右、攻击、跳跃)。但如果 Action 是连续的,比如「方向盘角度 -30.217°、油门 0.732、机械臂关节 17.421°」,我们不能简单遍历所有动作计算 ,因为动作无限多。于是另一条路线出现了:
Policy-based Reinforcement Learning。
Value-based 学的是 ,然后通过 得到动作;Policy-based 更直接——神经网络直接输出 ,告诉我们「在状态 下,应该以多大概率执行动作 」。
7.2 Policy Gradient:好动作多做,坏动作少做
假设策略由参数 控制,我们的目标是:
也就是「调整参数 ,让策略产生的轨迹获得更高 Reward」,使用梯度上升 。简单来说:
某个动作带来了高奖励 → 提高这个动作以后出现的概率
某个动作带来了低奖励 → 降低这个动作以后出现的概率
7.3 直觉例子
假设当前策略:左 0.3、右 0.3、前 0.4。这一次选择了「右」,结果 (比如用重击打出了大数字)。那么策略梯度会倾向于增大未来在类似状态下选择「右」的概率,例如逐渐变成:左 0.2、右 0.6、前 0.2。这就是 Policy Gradient 最核心的直觉。
7.4 Value-based 与 Policy-based 对比
| Value-based | Policy-based | |
|---|---|---|
| 学习对象 | ||
| 输出 | 动作价值 | 动作概率 |
| 动作选择 | argmax Q | 从策略采样 |
| 连续动作 | 较麻烦 | 更自然 |
| 代表算法 | Q-Learning、DQN | REINFORCE、PPO |
不过现代强化学习往往不会完全二选一,于是出现 Actor-Critic。
八、Policy-based 方法详解:REINFORCE、Actor-Critic、PPO 与 GRPO
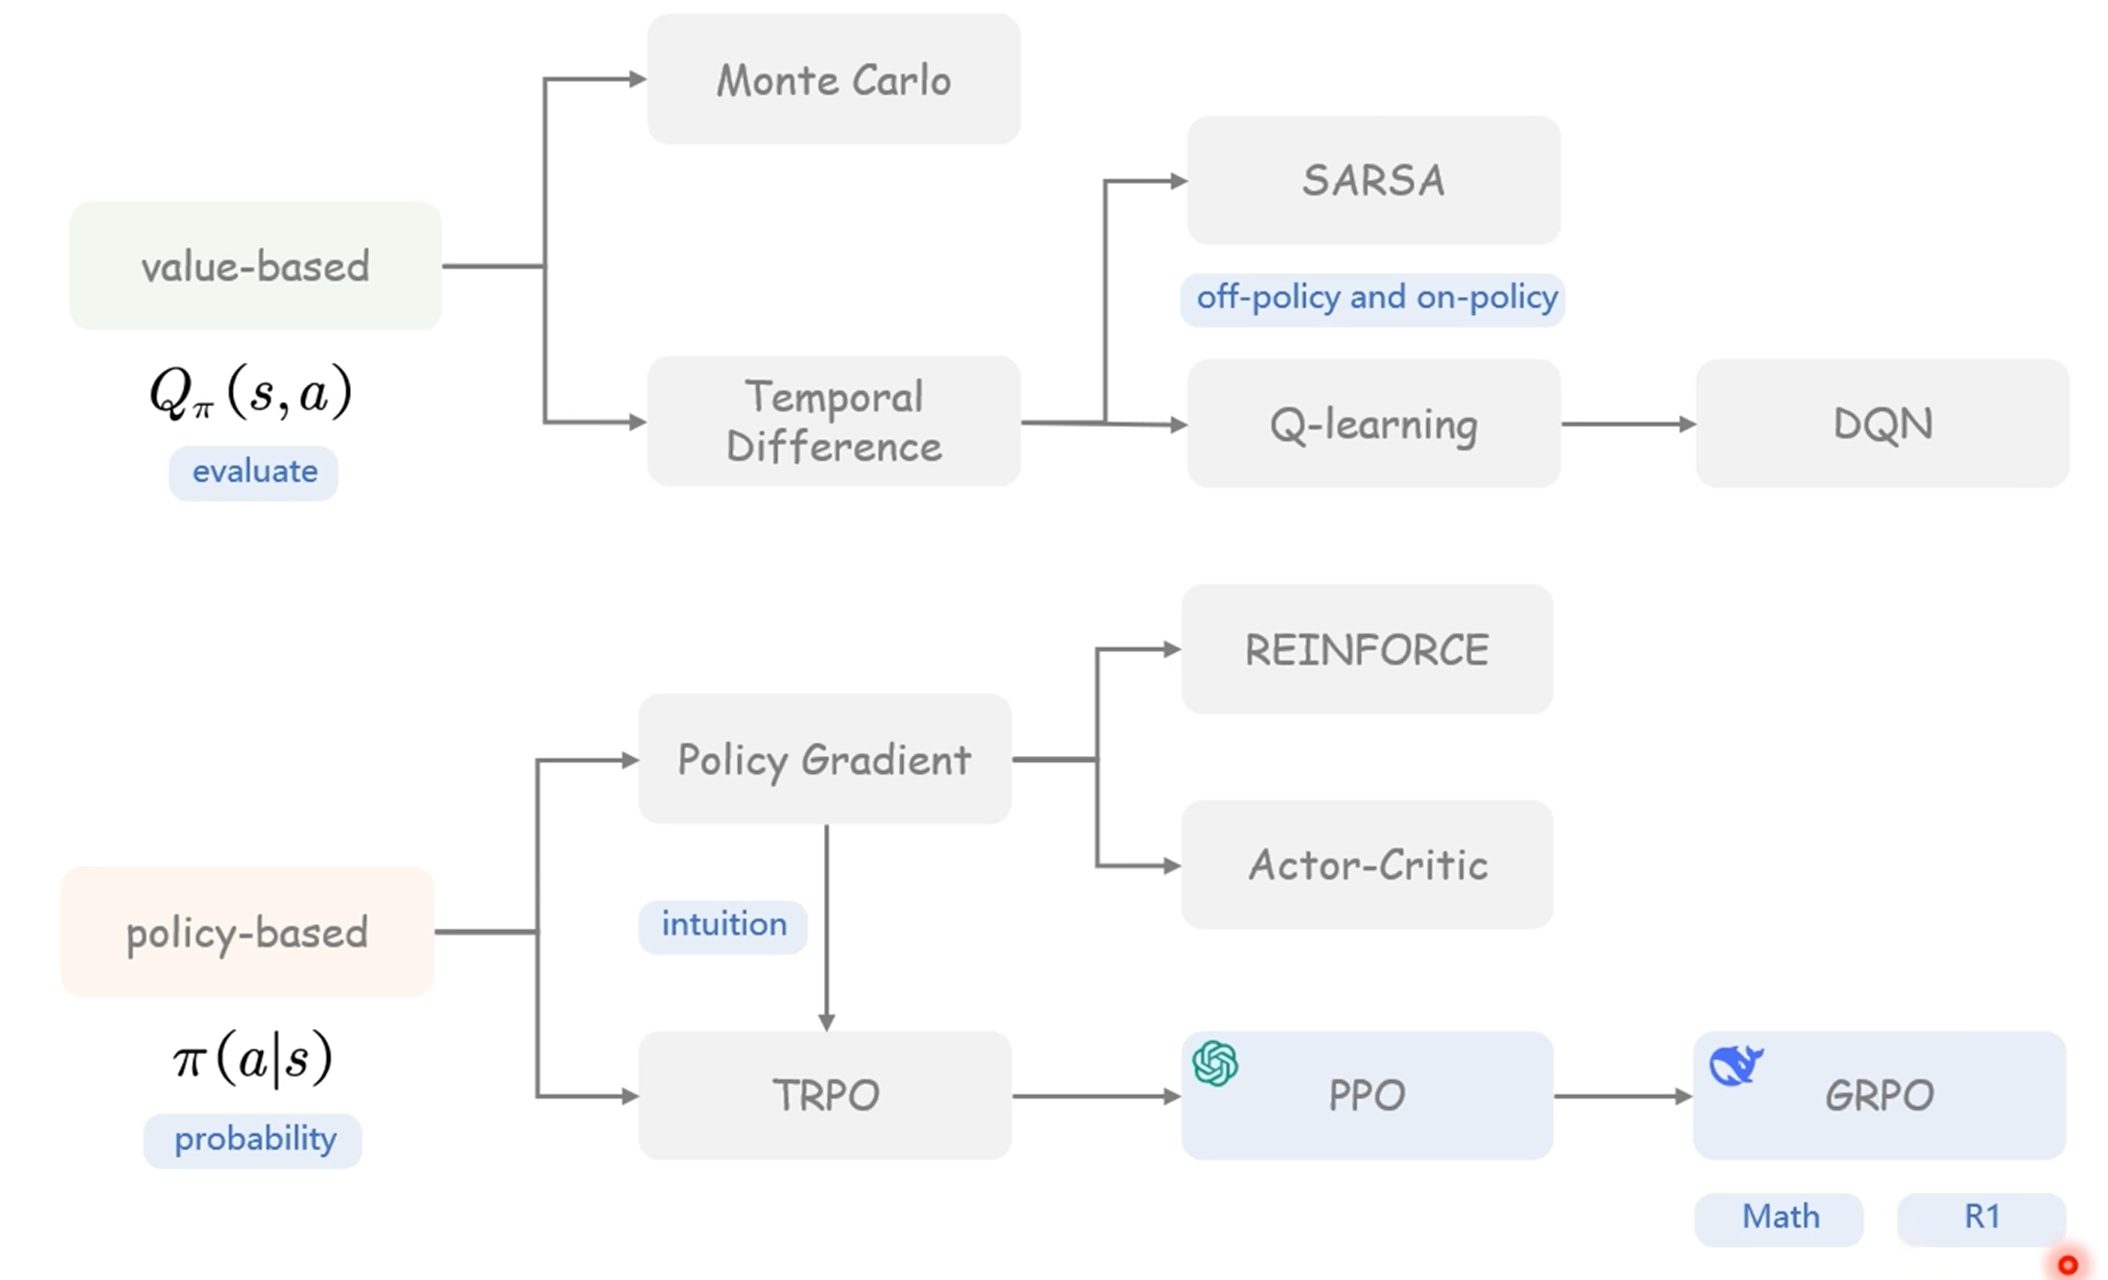
第七章介绍了 Policy-based 的基本思想:直接学习动作概率 。这一章把路线图里 Policy-based 分支上的方法逐个讲一遍:
Policy Gradient
     ↓
REINFORCE(用整局真实回报)
     ↓
Actor-Critic(用价值函数降低方差)
     ↓
PPO(限制单步更新幅度)
     ↓
GRPO(LLM 场景省掉 Critic)
8.1 Policy Gradient 与 REINFORCE
Policy Gradient 的目标是最大化 ,最经典的形式之一:
直觉非常简单:好动作以后多做,坏动作以后少做。
REINFORCE 是 Policy Gradient 最基础的实现——它把 用整局游戏的真实回报 来估计(蒙特卡洛式),更新规则:
例子:假设当前策略「左 0.3、右 0.3、前 0.4」,这一次选择了「右」并打出了大数字(),那么 REINFORCE 会增大未来选择「右」的概率(比如逐渐变成左 0.2、右 0.6、前 0.2);如果「右」导致被秒杀(),就降低它的概率。
REINFORCE 的缺点和 Monte Carlo 一样:必须等整局结束才能拿到 ,而且方差很高(同一状态下结果可能波动很大)。
8.2 Actor-Critic:用 Critic 降低方差
REINFORCE 的方差来自「用一整局的随机结果估计动作好坏」。Actor-Critic 的改进是:让 Critic(价值网络)来估计好坏,而不是等整局结果。
Actor-Critic 可以理解成:
Actor:负责行动(输出动作概率 πθ(a|s))
Critic:负责评价(估计状态价值 V(s) 或 Q(s,a))
整个流程:
Actor:我准备执行这个动作。
  ↓
Environment:这是你的 Reward。
  ↓
Critic:这个动作实际上比预期更好 / 更差。
  ↓
Actor:那我调整以后选择这个动作的概率。
Critic 提供的是 Advantage(优势) ,或用 TD 形式近似:
例子:Actor 选择「重击攻击」,Critic 说「当前局面正常值 6.5 分」,实际打完奖励换算成 ,那么 ——这次攻击比正常水平好很多,Actor 就提高重击的概率。
Actor-Critic 相当于 Policy-based + Value-based 的结合:像 TD 一样走一步学一步(方差低),但代价是引入 Critic 的估计偏差。后面的 A2C、A3C 都是它的变体。
8.3 PPO:更新别太猛
Policy Gradient 有一个很大的问题:策略一次更新太猛,可能直接把模型训崩。比如原来 ,一次梯度更新变成 0.9,变化太大——而 RL 的数据又是当前策略自己采的,策略变化过大会让旧数据失效。
PPO 的核心思想就是:
可以更新,但不要一步走太远。
它引入概率比 ,用 Clip 把它限制在 (通常 ):
数字例子:攻击概率从 20% 更新到 22% 时 ,在范围内,正常受益;但如果一口气从 20% 干到 40% 时 ,超过 1.2 的部分梯度被截断——PPO 会说「你先别激动」。这就是 Proximal(近端)的含义:稳定地改进 Policy,而不是疯狂地改进 Policy。
8.4 GRPO:LLM 场景下省掉 Critic
PPO 用在 LLM(如 ChatGPT 类模型)上有个明显的问题:Critic / Value Model 很重——模型本身已经很大,还要再养一个差不多大的 Critic 来估计基线。
GRPO(Group Relative Policy Optimization)的做法是:不用额外的 Value Model 估计 baseline,而是对同一个 prompt 生成多个回答,在组内做相对比较:
其中 是同组回答奖励的均值与标准差。
数字例子:给模型同一道题(比如 )生成 4 个回答,奖励 ,那么 ,于是正确的回答 (提高概率),错误的回答 (降低概率)。
一句话对比:
PPO:用 Critic 告诉我「正常水平」是多少
GRPO:我不养 Critic 了,同一道题多生成几个答案,让它们互相当参照物
PPO 和 GRPO 的完整推导见《从 PPO 到 DPO、GRPO:大模型强化学习到底在优化什么?》。
8.5 Policy-based 方法小结
| 方法 | 解决什么问题 | 一句话 |
|---|---|---|
| Policy Gradient | 直接学动作概率 | 好动作↑概率、坏动作↓概率 |
| REINFORCE | PG 的蒙特卡洛实现 | 用整局真实回报 更新(无偏、高方差) |
| Actor-Critic | REINFORCE 方差太大 | Actor 做、Critic 评,用 降低方差 |
| PPO | 策略更新太猛会训崩 | 概率比 + Clip,限制单步更新幅度 |
| GRPO | LLM 里 Critic 太贵 | 同一道题多个回答组内相对比较,省掉 Value Model |
九、整套强化学习的路线图
9.1 把整套强化学习串起来
看到这里,可以把强化学习基础压缩成一条完整的逻辑链:
目标不是最大化当前 Reward,而是最大化 。于是定义 判断状态好坏、 判断动作好坏。由于 得到 Bellman 方程。然后出现两种估值方式:
- Monte Carlo:完整跑完、使用真实 Return——multi-step、high variance、low bias;
- TD:走一步、用 reward + 下一状态价值立即更新——one-step、low variance、high bias、bootstrap。
TD 进一步作用于 得到 SARSA(,按实际策略选择的下一动作学习,On-policy)和 Q-Learning(,按理论最优下一动作学习,Off-policy)。状态空间太大存不下 Q Table 时,用神经网络近似 得到 DQN。另一条路线直接学习 得到 Policy Gradient(用整局回报实现就是 REINFORCE),再加一个 Critic 得到 Actor-Critic,用 Clip 限制更新得到 PPO,LLM 场景省掉 Critic 得到 GRPO。从这里继续往后,就可以理解 RLHF / LLM RL 等。
9.2 最重要的几个公式
| 概念 | 公式 | 一句话 |
|---|---|---|
| Policy | 状态 下选择动作 的概率 | |
| Return | 从现在开始未来累计能得到多少奖励 | |
| State Value | 状态 有多好 | |
| Action Value | 在状态 执行动作 有多好 | |
| Bellman | 当前价值 = 当前奖励 + 折扣后的未来价值 | |
| TD Error | 新估计 − 旧估计 | |
| TD Update | 慢慢修正价值 | |
| SARSA | 按实际策略学 | |
| Q-Learning | 按最优策略学 | |
| Policy Gradient | $\nabla_\theta J(\theta)=\mathbb E[\nabla_\theta\log\pi_\theta(a | s)\cdot Q^\pi(s,a)]$ |
| Actor-Critic | (或 ) | Actor 做、Critic 评 |
| PPO | 限制单步更新不要太猛 | |
| GRPO | (组内归一化) | 同组回答互相当参照物,省掉 Critic |
9.3 一张图记住整个框架
                  Reinforcement Learning
                           │
                           ▼
               Agent 与 Environment 交互
                           │
          ┌────────────────┴────────────────┐
          │                                 │
       State                             Action
          │                                 │
          └──────────→ Reward ←─────────────┘
                           │
                           ▼
                        Return
                           │
                           ▼
                    Value Function
                    /             \
                 V(s)             Q(s,a)
                           │
                           ▼
                    Bellman Equation
                           │
             ┌─────────────┴─────────────┐
             │                           │
      Monte Carlo                       TD
     完整轨迹更新                    单步更新
             │                           │
             │                 ┌─────────┴─────────┐
             │                 │                   │
             │               SARSA             Q-Learning
             │              On-policy          Off-policy
             │                                     │
             │                                     ▼
             │                                    DQN
             │
             └──────────────────┐
                                │
                           Policy-based
                                │
                         Policy Gradient
                                │
                         Actor-Critic
                                │
                               PPO
9.4 最后总结
如果只记住几句话,可以记下面这些:
- 强化学习到底在干什么? 找一个能够让长期累计 Reward 最大的 Policy。
- V 是什么? 当前状态值多少钱。
- Q 是什么? 当前状态下,这个动作值多少钱。
- Bellman 方程是什么? 当前价值 = 当前奖励 + 未来价值。
- Monte Carlo 是什么? 玩完一整局再总结。
- TD 是什么? 走一步学一步,用下一状态的估计帮助更新当前状态。
- SARSA 是什么? 按照自己真正执行的策略学习。
- Q-Learning 是什么? 按照理论上的最优策略学习。
- DQN 是什么? 用神经网络替代 Q Table。
- Policy Gradient 是什么? 不再学习「动作值多少分」,而是直接学习「动作应该以多大概率被选择」。
下一篇 《从 PPO 到 DPO、GRPO:大模型强化学习到底在优化什么?》 在这个基础上继续:PPO 的 Clip 与 GAE、DPO 的直接偏好优化,以及 GRPO 如何用组内相对 Advantage 省掉 Critic。
参考资料
- Bilibili:《【大白话 03】一文理清强化学习 RL 基本原理 | 原理图解+公式推导》:https://www.bilibili.com/video/BV1rooaYVEk8/
- Sutton & Barto, Reinforcement Learning: An Introduction:http://incompleteideas.net/book/the-book-2nd.html
- 强化学习的数学原理课程:https://github.com/MathFoundationRL/Book-Mathmatical-Foundation-of-Reinforcement-Learning