论文:Structure-Aware Representation Distillation for Tiny-Dense Object Segmentation(CVPR 2026) 作者:Liu 等|代码:github.com/liuuuuuuxuesong/SARD 定位:面向微型密集目标分割的结构感知蒸馏——不走”模仿 mask”,而是构造结构重要性图,在特征空间加权对齐师生,让学生把容量花在”几何信息丰富区域”
背景:微型密集目标为什么难蒸馏
任务:分割像岩石碎片、细胞、烟羽这类场景——一张图里成千上万个小而密集、互相接触的物体。小定位误差会被严重放大。
现有蒸馏方法的通病(论文批判):
现有方法(CWD/KD 等):对特征图所有位置【均匀加权】
  → 把"同质背景区域"和"关键结构边界"同等对待
  → 稀释了几何重要位置的学习信号
→ 导致:碎片边缘模糊、接触点(junction)丢失、密集区性能差结构复杂性的两个来源(论文定义):
① 实例内部结构:单个岩石多面/表面变化、细胞核与不规则膜 → 需要"内部几何"
② 实例间拥挤:物体堆叠/接触/重叠 → 接触点边界模糊 → 需要"空间密度"
教师与学生网络结构
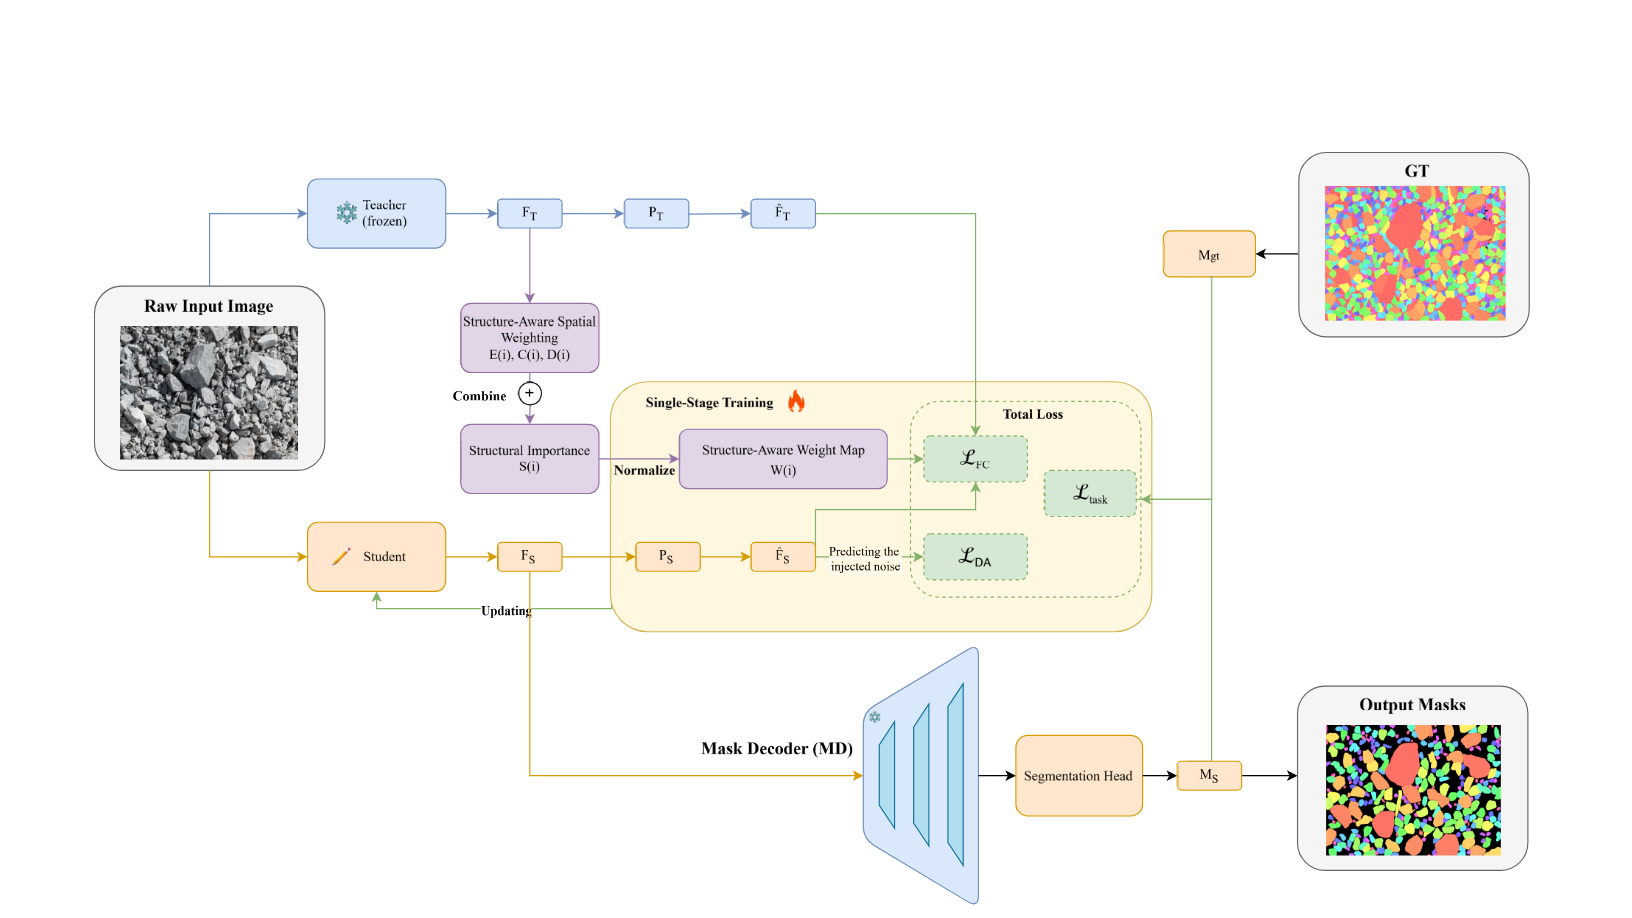
总体架构(教师-学生蒸馏)——双支路 + 中间蒸馏层:
                           输入 x(源域图像)
                                   │
              ┌────────────────────┴────────────────────┐
              ▼                                         ▼
   ┌─────────────────────┐                   ┌─────────────────────┐
   │ 教师支路 T(❄️全冻结) │                   │ 学生支路 S(🔥训练)    │
   │ 编码器 ET             │                   │ 编码器 ES             │
   │ (Swin-L / SAM-H /    │                   │ ← 更新:L_repr + L_task│
   │  Mask2Former-L)      │                   │ (Swin-T / ResNet-50)  │
   │ 【只用特征,分割输出】 │                   │ / EfficientSAM-Ti)    │
   └──────────┬──────────┘                   └──────────┬──────────┘
              │ FT ∈ R^(C×H×W)                          │ FS ∈ R^(C×H×W)
              ▼                                         ▼
   ┌──────────────────────────┐              ┌────────────────────┐
   │ ① 结构重要性计算(🔇无参数) │              │ ② 投影头 PS(🔥训练)   │
   │   Sobel→结构张量J         │              │ ← 更新:L_FC + L_DA │
   │   →E=λ1−λ2, C=λ1λ2, D    │              │ → F̂S(共享空间)     │
   │   → S = αeE+αcC+αdD      │              └─────────┬──────────┘
   │   → W(i) = S(i)/ΣS(j)    │                        │
   └──────────┬───────────────┘                        │
              │ 权重图 W(结构感知)                     │
              ▼                                        ▼
   ┌──────────────────────┐   L_FC = Σ_i W(i)‖F̂S−F̂T‖²  ┌────────────┐
   │ ③ 投影头 PT(❄️冻结)  │◄═══════════════════════════►│ 去噪头 g    │
   │ → F̂T(共享空间)       │   L_DA = Σ_i W(i)‖g(F̂S)−ε‖² │ (两层conv,  │
   │ → 加噪 F̃T(不更新)    │        (g ← 更新:只 L_DA) │  隐藏128)   │
   └──────────────────────┘                            └────────────┘
                                                              │
             学生解码器 DS/MD + 分割头(🔥训练)                  │
             ← 更新:只 L_task                               │
             DS(FS, p) → 分割掩码 MS                          │
             L_task = Dice(MS, Mgt) + BCE(MS, Mgt)  ←─────────┘
              │
              ▼
            推理:只用学生支路(教师/结构计算/去噪头全部退场)
损失 → 模块梯度分工一览:
| 损失 | 更新哪些学生参数 | 不更新 |
|---|---|---|
| L_FC(特征一致性) | ES(经 PS 回传)、投影头 PS | MD/分割头、去噪头 g |
| L_DA(分布对齐) | ES(经 g 回传)、投影头 PS、去噪头 g | MD/分割头 |
| L_task(Dice+BCE) | ES、MD/分割头 | 投影头 PS、去噪头 g |
| 总损失 L = L_repr + λ·L_task | 学生全部可训练参数 | 教师 ET/PT/结构计算器(冻结) |
架构分五层理解:
| 层 | 教师支路(❄️冻结) | 学生支路(🔥训练) | 产出 |
|---|---|---|---|
| 输入层 | 同一张图 x | 同一张图 x | — |
| 编码层 | 编码器 ET(分割大模型) | 编码器 ES(轻量模型) | FT / FS(C×H×W 特征) |
| 特征处理层 | 结构重要性计算(Sobel→张量→E/C/D→S→W)+ 投影 PT | 投影 PS(1×1 conv 映射到共享空间) | W 权重图 / F̂T / F̂S |
| 蒸馏层 | 加噪 F̃T(式 12) | 去噪头 g 预测噪声 | L_FC + L_DA(W 加权) |
| 输出层 | — | 解码器 DS → 掩码 MS | L_task(有 GT 时) |
公式定义(式 1-2):
关键数据流:
① 特征提取:教师和学生各自编码同一张图 → FT / FS
② 结构权重:只从【教师特征 FT】算 W(Sobel→结构张量→E/C/D→S→W)——不依赖学生、不需要标注
③ 空间对齐:W 同时加权 L_FC(F̂S vs F̂T)和 L_DA(g(F̂S) vs ε)——学生特征被"拽向"结构关键位置
④ 任务监督:学生解码器 DS(FS) → MS,和 GT 算 Dice+BCE
⑤ 反向传播:只更新学生 S + PS + g;教师 ET/PT 参数不动角色分工:
| 模块 | 是什么 | 冻结/训练 | 作用 |
|---|---|---|---|
| 教师 T | 分割大模型(Swin-L/SAM-H/M2F-L…) | ❄️ 冻结 | 提供特征 FT 和结构先验 |
| 结构计算器 | Sobel + 结构张量 + E/C/D(无参数运算) | 🔇 无参数 | 从 FT 生成结构权重 W |
| 投影头 PT | 1×1 卷积 | ❄️ 冻结 | 教师特征映射到共享空间 |
| 学生 S | 轻量分割模型(Swin-T/ResNet-50…) | 🔥 训练 | 蒸馏对象,推理只部署它 |
| 投影头 PS | 1×1 卷积 | 🔥 训练 | 学生特征映射到共享空间 |
| 去噪头 g | 两层卷积(隐藏 128) | 🔥 训练 | 学生预测教师特征被注入的噪声(分布对齐) |
训练时只更新:学生 S + 投影头 PS + 去噪头 g(教师 ET、投影头 PT、结构计算器全冻结/无参数);推理时只用学生(5~25M 参数),蒸馏装置零额外开销。 ⚠️ 教师只出”特征”,不出”分割结果”:教师本身是完整分割大模型(有解码器、能做分割),但 SARD 是 feature-based 蒸馏——只取教师编码器的特征 FT(供结构分析和特征对齐),教师的解码器/分割输出在蒸馏中完全用不上。学生用自己的 MD 学分割(L_task 对真值),教师只是”特征老师”。
核心思想:结构感知的”空间加权蒸馏”
不模仿 mask、不均匀对齐特征——先算一张”哪里重要”的结构图,再按重要性加权做特征对齐。
教师(冻结)特征 F_T
   ↓ 结构分析
结构重要性 S(i) = 边界显著性 + 几何复杂度 + 空间密度
   ↓ 归一化
权重图 W(i)
   ↓ 加权
Lrepr = Σ W(i)·[特征一致 + 分布对齐]  +  λ·Lseg
   ↓
学生(训练)总体目标(式 3-4):
模块①:结构重要性图 S(i)(核心创新)
权重归一化(式 5):
S(i) → W(i) 的机制:S(i) 是位置 i 的原始结构得分(任意正数),W(i) 是除以全图总和后的归一化权重(0~1,全图和=1)——本质是把”结构分数”变成”概率分布”。例如 S = [0.1, 0.5, 2.0, 0.4](总和 3.0)→ W = [0.033, 0.167, 0.667, 0.133]——结构最复杂的位置权重最大。
W(i) 的作用:作为蒸馏损失的空间乘子——。W(i) 大的位置(边界/密集接触区)蒸馏误差被放大 → 梯度大 → 学生优先把容量花在这里;背景区域 W(i) 小 → 学习信号被稀释。对比普通蒸馏的均匀加权,SARD 用 W(i) 把学习资源”押注”在几何关键位置。
为什么非要归一化:① 损失尺度稳定(,不随图像大小/内容漂移);② 只保留相对重要性(A 比 B 重要几倍),去掉绝对分数尺度。
S(i) 由三个互补分量组成(式 9):
| 分量 | 公式 | 大白话 | 抓什么 |
|---|---|---|---|
| 边界显著性 E | (结构张量特征值差) | 各向异性——梯度方向性越强越像边界 | 边界、棱边(定向过渡) |
| 几何复杂度 C | (特征值几何均值) | 多方向梯度强度 | 交点、角点、junction |
| 空间密度 D | 局部特征离散度(密度代理) | 拥挤区域(实例间接触) |
结构张量(式 6):——2×2 对称矩阵,特征值分解得
为什么用 D 不用实例计数:用局部特征离散度代理密度——不需要实例标注,SARD 兼容全监督和半监督。
三个分量的角色:E 管”方向性边界”、C 管”多方向交点”、D 管”拥挤度”——消融证明三者互补,联合最优。
结构图的完整计算流程(对应 Algorithm 1 前 5 步):
① 教师前向:FT = ET(x)
② 空间梯度(Sobel):对每个通道 c,用标准 Sobel-x/y 滤波器在 H×W 网格上算 ∂FT(c)/∂x 和 ∂FT(c)/∂y
③ 结构张量(式 6):在每个位置 i 形成 J(i) = Σ_c ∇FT(c)(i)·∇FT(c)(i)ᵀ(2×2 对称矩阵)
④ 局部线索(式 7-8):E(i) = λ1(i) − λ2(i),C(i) = λ1(i)·λ2(i),D(i) = 局部特征离散度
⑤ 组合权重(式 5/9):S(i) = αe·E(i) + αc·C(i) + αd·D(i) → 归一化 W(i)
为什么 λ1−λ2 能代表”边界”:结构张量 J(i) 编码了位置 i 的梯度方向分布——
理想边界:梯度基本朝一个方向 → λ1 大、λ2 小 → E = λ1−λ2 大(各向异性强)
平坦区域:梯度都小 → λ1 ≈ λ2 ≈ 0 → E ≈ 0
交点/角点:两个方向都有强梯度 → C = λ1·λ2 大(多方向强度)
为什么需要 D(密度):几何量(E/C)只能发现”哪里有结构”,但密集场景里到处是结构——D 用局部特征离散度找出”哪里结构最多最挤”,把权重进一步集中到最需要区分的接触区域。
模块②:统一表示损失 L_repr(特征一致性 + 分布对齐)
特征一致性 L_FC(式 11)——点对点匹配
师生特征先经 1×1 卷积投影到共享空间(),再按结构权重做点对点 L2:
大白话:结构重要处(边界/密集区)对齐误差被放大,逼学生优先学好这些位置。
分布对齐 L_DA(式 12-13)——去噪分数匹配(亮点)
只对齐点值不够——还要对齐局部特征分布。做法借鉴去噪分数匹配(denoising score matching):
① 给教师特征加高斯噪声:F̃T = √(ᾱ)F̂T + √(1−ᾱ)ε   (式 12,诱导平滑的教师分布)
② 训练轻量去噪头 g(两层卷积,隐藏 128):
   用学生特征预测教师被注入的噪声
   L_DA = Σ W(i)‖g(F̂S(i)) − ε(i)‖²                 (式 13)
大白话:结构重要处(边界/密集区)对齐误差被放大,逼学生优先学好这些位置。
L_FC 的机制细节:
① 为什么要投影:教师和学生特征通道数/语义空间可能不同 → 各自 1×1 卷积(PT/PS)映射到共享空间
② 为什么点对点就够:结构权重 W(i) 已经把"学哪里"分好工——点对点负责"该学的每个位置学准"
③ 结构加权的作用:W(i) 大的位置(边界/密集区)L2 误差被放大 → 梯度更大 → 学生把容量优先投给这里
为什么需要 L_DA(点对点 L_FC 的不足):
点对点匹配只约束"每个位置的取值像不像",约束不了"局部区域特征的整体分布像不像"
在密集簇内,特征变化剧烈 → 点对点学不准"这个区域到底有多少种结构在变化" → 需要分布级约束去噪分数匹配的直觉(式 12-13):
去噪分数匹配(denoising score matching):学习"加噪数据 → 噪声"的映射 ≈ 学习数据分布的梯度(score)
SARD 的做法:
  ① 教师特征 F̂T 加噪 → F̃T(把尖峰分布"抹平",变成可学习的平滑分布)
  ② 噪声 ᾱ=0.5 控制加噪强度(ᾱ 大 → 保留更多原特征,ᾱ 小 → 分布更平滑)
  ③ 学生特征 F̂S 过轻量去噪头 g → 预测教师被加的噪声 ε
  ④ 学生能"猜出噪声" ⇔ 学生特征已近似教师特征的 log-密度梯度(score)
→ 即使某位置点值没完全对齐,学生的"局部分布形状"也已经向教师靠拢大白话:学生要能”猜出教师特征被加了什么噪声”——这等价于让学生逼近教师特征分布的”分数”(log-密度梯度),学到点值之外的分布结构,对密集簇内的高特征变化区域尤其重要。
任务损失(式 14)
训练/推理流程
训练(单阶段,式 15):
① 教师冻结前向 → F_T
② 从 F_T 算结构图 S(i)(E/C/D)→ 权重 W(i)
③ 学生前向 → F_S, M_S
④ L = L_repr(所有图)+ λ·L_task(有 GT 的图)
⑤ 只更新学生/投影头/去噪头(教师参数不动)

推理:只用学生(教师+蒸馏全退场,零额外开销)实现细节:;密度窗口 (15×15);;噪声 ;AdamW(lr 1e-4),100 epochs,RTX 4090。
实验
数据集:Cityscapes、ADE20K、RockFrag(岩石碎片——每图数千个不规则接触碎片的极端微型密集挑战)
主结果(Table 1,mIoU / bIoU%):
| 方法 | Cityscapes | ADE20K | RockFrag |
|---|---|---|---|
| Teacher (Swin-L) | 81.2/76.8 | 48.6/42.3 | 62.4/48.9 |
| Student (Swin-T) scratch | 76.5/71.2 | 42.1/35.8 | 52.3/36.8 |
| CWD | 78.9/73.8 | 44.8/38.6 | 55.9/40.6 |
| SARD | 80.3/76.1 | 46.9/40.8 | 60.2/47.3 |
| vs CWD | +1.4/+2.3 | +2.1/+2.2 | +4.3/+6.7 |
关键发现:
- 边界提升 > mIoU 提升:所有数据集 bIoU 增益都超过 mIoU——验证”结构加权主要提升几何精度而非区域重叠”的设计目标;
- RockFrag 增益最大(+4.3/+6.7)——越密集越需要结构感知;
- 架构通用(Table 2):ViT-L→ViT-T、SAM-H→EfficientSAM-Ti、Mask2Former-L→M2F-R50 都 +1.5
1.8 mIoU/+2.32.7 bIoU——不是特定架构的启发式; - 消融(Table 3):uniform SARD 53.8 → 结构加权 58.6(+4.8 mIoU);E/C/D 单独用各有贡献,全组合最优;
- 效率(Table 4):ViT-T(5.7M)59.4/46.8 超 SegFormer-B1(55.1/41.5);ResNet-50 从 Swin-L 蒸馏 → 7.7× 参数减少、9× 吞吐。
与”蒸馏 + 目标检测/泛化”课题的联系
| SARD 的方法 | 迁移到检测蒸馏的机会 |
|---|---|
| 结构重要性加权(别均匀对齐) | 检测里物体边界/小目标也应加权——CD-FKD/特征蒸馏都均匀对齐,可加”重要性图” |
| 去噪分数匹配做分布对齐(L_DA) | 比纯点对点特征对齐多学”分布结构”——呼应 DSD”结构>数值”的思想,实现不同 |
| 教师无关性 | 教师可以是任意分割大模型(SAM/Mask2Former)——检测也可用异构教师 |
| 微型密集场景 | 若课题涉及小目标/密集交通场景,这个加权思想直接可用 |
一句话总结
SARD 用结构重要性图(边界显著性 E + 几何复杂度 C + 空间密度 D)给特征蒸馏做空间加权,配合”点对点一致性 + 去噪分数匹配分布对齐”两种损失,让学生把容量集中在微型密集物体的几何关键位置——RockFrag 上比 CWD +4.3 mIoU/+6.7 bIoU,还兼容任意教师架构、推理零开销。
相关资料
- 论文:Structure-Aware Representation Distillation for Tiny-Dense Object Segmentation(CVPR 2026)
- 代码:github.com/liuuuuuuxuesong/SARD
延伸阅读
- 知识蒸馏:SARD 所属的蒸馏主线——轻量学生从大模型中学习结构知识
- 论文阅读:DSD(ICML 2026):同样主张「结构/关系优于点值对齐」的蒸馏——结构感知思想的另一种实现