本文主要整理自王木头学科学《随机梯度下降、牛顿法、动量法、Nesterov、AdaGrad、RMSprop、Adam——理解梯度下降法的优化》(Bilibili),并补充了 AdamW 等内容,按「每个方法解决前一个方法的问题」的主线,串讲从梯度下降到 Adam 的完整演化过程。
一句话概括:优化器的发展,本质上就是不断修改「更新方向」和「更新步长」——Momentum 管方向、RMSProp 管步长,而 Adam 就是两者的结合。
一、训练神经网络就是在解一个优化问题
1.1 优化问题与优化器
训练一个神经网络,本质上在做什么?假设模型参数为 ,经过前向传播后得到预测结果,再通过 Loss Function 计算 ,训练的目标就是找到一组参数使损失最小:
也就是说,神经网络训练本质上就是一个优化问题。问题是 通常是一个极其复杂的高维函数,我们不可能直接把最优解算出来,于是就需要 Optimizer(优化器)。如果把 Loss Function 想象成一座山,训练神经网络就相当于让一个小球从山上出发,想办法尽快走到最低点——最基础的方法就是 Gradient Descent(梯度下降)。
但普通梯度下降会出现很多问题:走得太慢、来回震荡、学习率不好选、遇到平坦区域速度很慢、不同参数最好使用不同学习率、在复杂曲面上表现很差。于是出现了两条改进路线:SGD → Momentum → Nesterov,以及 AdaGrad → RMSProp,最终两条路线汇合成 Adam()。这两条路线各管一件事:SGD → Momentum → Nesterov 优化的是「更新方向」(往哪走),AdaGrad → RMSProp 优化的是「更新步长」(走多远)。这篇文章就按照这个发展过程,一步一步理解这些优化算法究竟解决了什么问题。
1.2 梯度下降:跟着导数反方向走
先从一个最简单的函数开始:,我们希望找到 ,显然 时取最小值。但假设我们「不知道答案」,现在从 出发,怎么知道应该往左走还是往右走?看导数:,当 时 是正数,说明 ,所以如果希望 变小就应该让 减小——也就是向导数的反方向走。因此梯度下降的更新公式为:
推广到参数就是:
其中 就是 Gradient, 就是 Learning Rate(学习率)。
这里最重要的直觉是:Gradient 指向函数增长最快的方向,因此 就是局部下降最快的方向。所以梯度下降做的事情其实特别简单:计算当前位置梯度 → 找到最陡上坡方向 → 反方向走一步 → 重新计算梯度 → 再走一步,直到 :
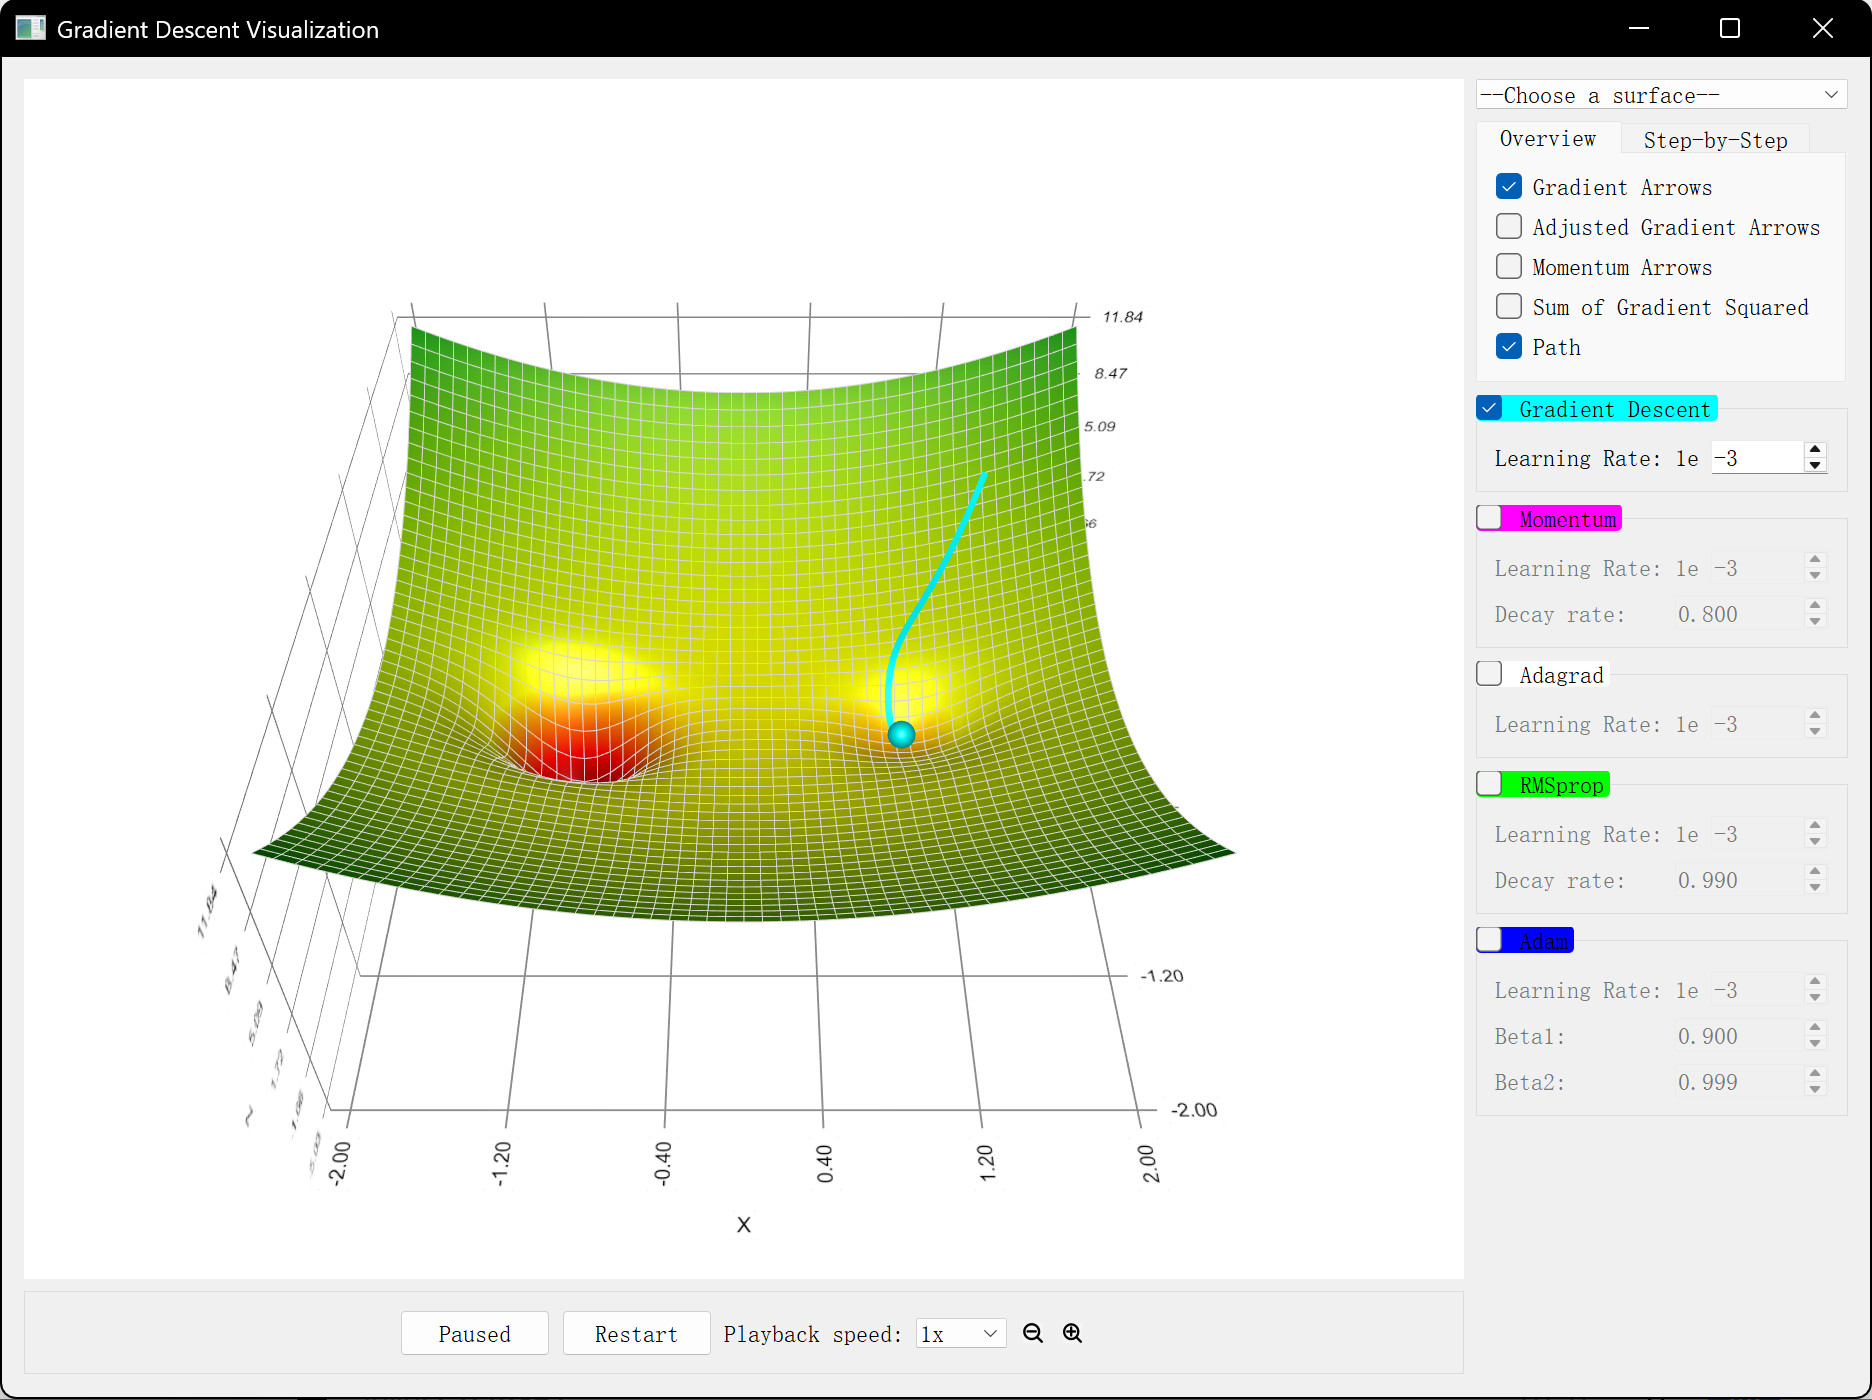
1.3 学习率为什么这么重要
更新公式里真正控制「走多远」的就是 。学习率太小,每一步都特别短,虽然可能收敛但太慢;学习率太大,每一步都直接冲过最低点,不断震荡,严重时甚至 最终发散。所以优化器研究里一个非常核心的问题就是:
后面的 AdaGrad、RMSProp、Adam,其实都在不同程度上回答这个问题。
二、从 Batch GD 到 SGD:算不动怎么办
2.1 Batch Gradient Descent 的问题
传统梯度下降如果有 个训练样本,会计算整个数据集的平均梯度 才更新一次参数,这叫 Batch Gradient Descent。问题很明显:如果训练数据有 条,每更新一次参数都要把全部数据算一遍,太慢了。
2.2 SGD 与 Mini-batch
于是有了 Stochastic Gradient Descent(随机梯度下降):最极端情况下每次随机拿 1 个样本 估计梯度 ,然后 ,不用等整个数据集算完就能更新参数。但一个样本算出来的梯度可能并不能很好地代表整个数据集的真实梯度,所以 SGD 的路径通常不是直线冲向 Minimum,而是带有比较明显的噪声(一会 ↘ 一会 ↙)。
实际深度学习中更常见的是折中方案 Mini-batch:假设 Batch Size ,则 ,再 。这样既不会像 Batch GD 那么慢,又不会像单样本 SGD 那么 noisy。所以今天我们日常说「用 SGD 训练模型」,通常实际指的都是 Mini-batch SGD。
三、Momentum 与 Nesterov:让方向更稳
3.1 SGD 的第一个问题:震荡
假设 Loss Surface 是一个狭长的山谷,理想情况当然希望直线冲向 Minimum,但普通 SGD 可能会左右来回震荡。原因是某个方向的坡度特别陡(),每一步在这个方向都走得很远,结果就是左右或者上下不断震荡,但真正需要前进的方向移动得很慢。于是出现一个很自然的问题:能不能利用前几步的信息?这就是 Momentum。
3.2 Momentum:给梯度下降加上「惯性」
想象一个球从山坡滚下来,现实中的球并不是每走一步就忘记之前发生过什么,它有惯性:如果连续很多步都朝右,向右的速度应该越来越快;如果梯度不断上下交替,这个方向的速度应该越来越小。Momentum 就是把这种思想加入梯度下降——定义一个速度 ,常见写法:
也有很多教材写成 再 ,两种形式只是尺度约定不同,核心思想相同:当前更新不仅考虑当前梯度,还考虑过去累积的运动方向。Sutskever 等人在 ICML 2013 的工作中展示了合理初始化和精心设置的 Momentum 对深层、循环网络训练的重要作用。
3.3 为什么 Momentum 能减少震荡
假设 方向一直朝右,历史梯度 和当前梯度 方向一致,于是 越来越大,朝目标方向加速;反过来如果 方向上下交替, 和 经常方向相反、互相抵消,震荡方向减弱。所以 Momentum 可以粗略理解成:
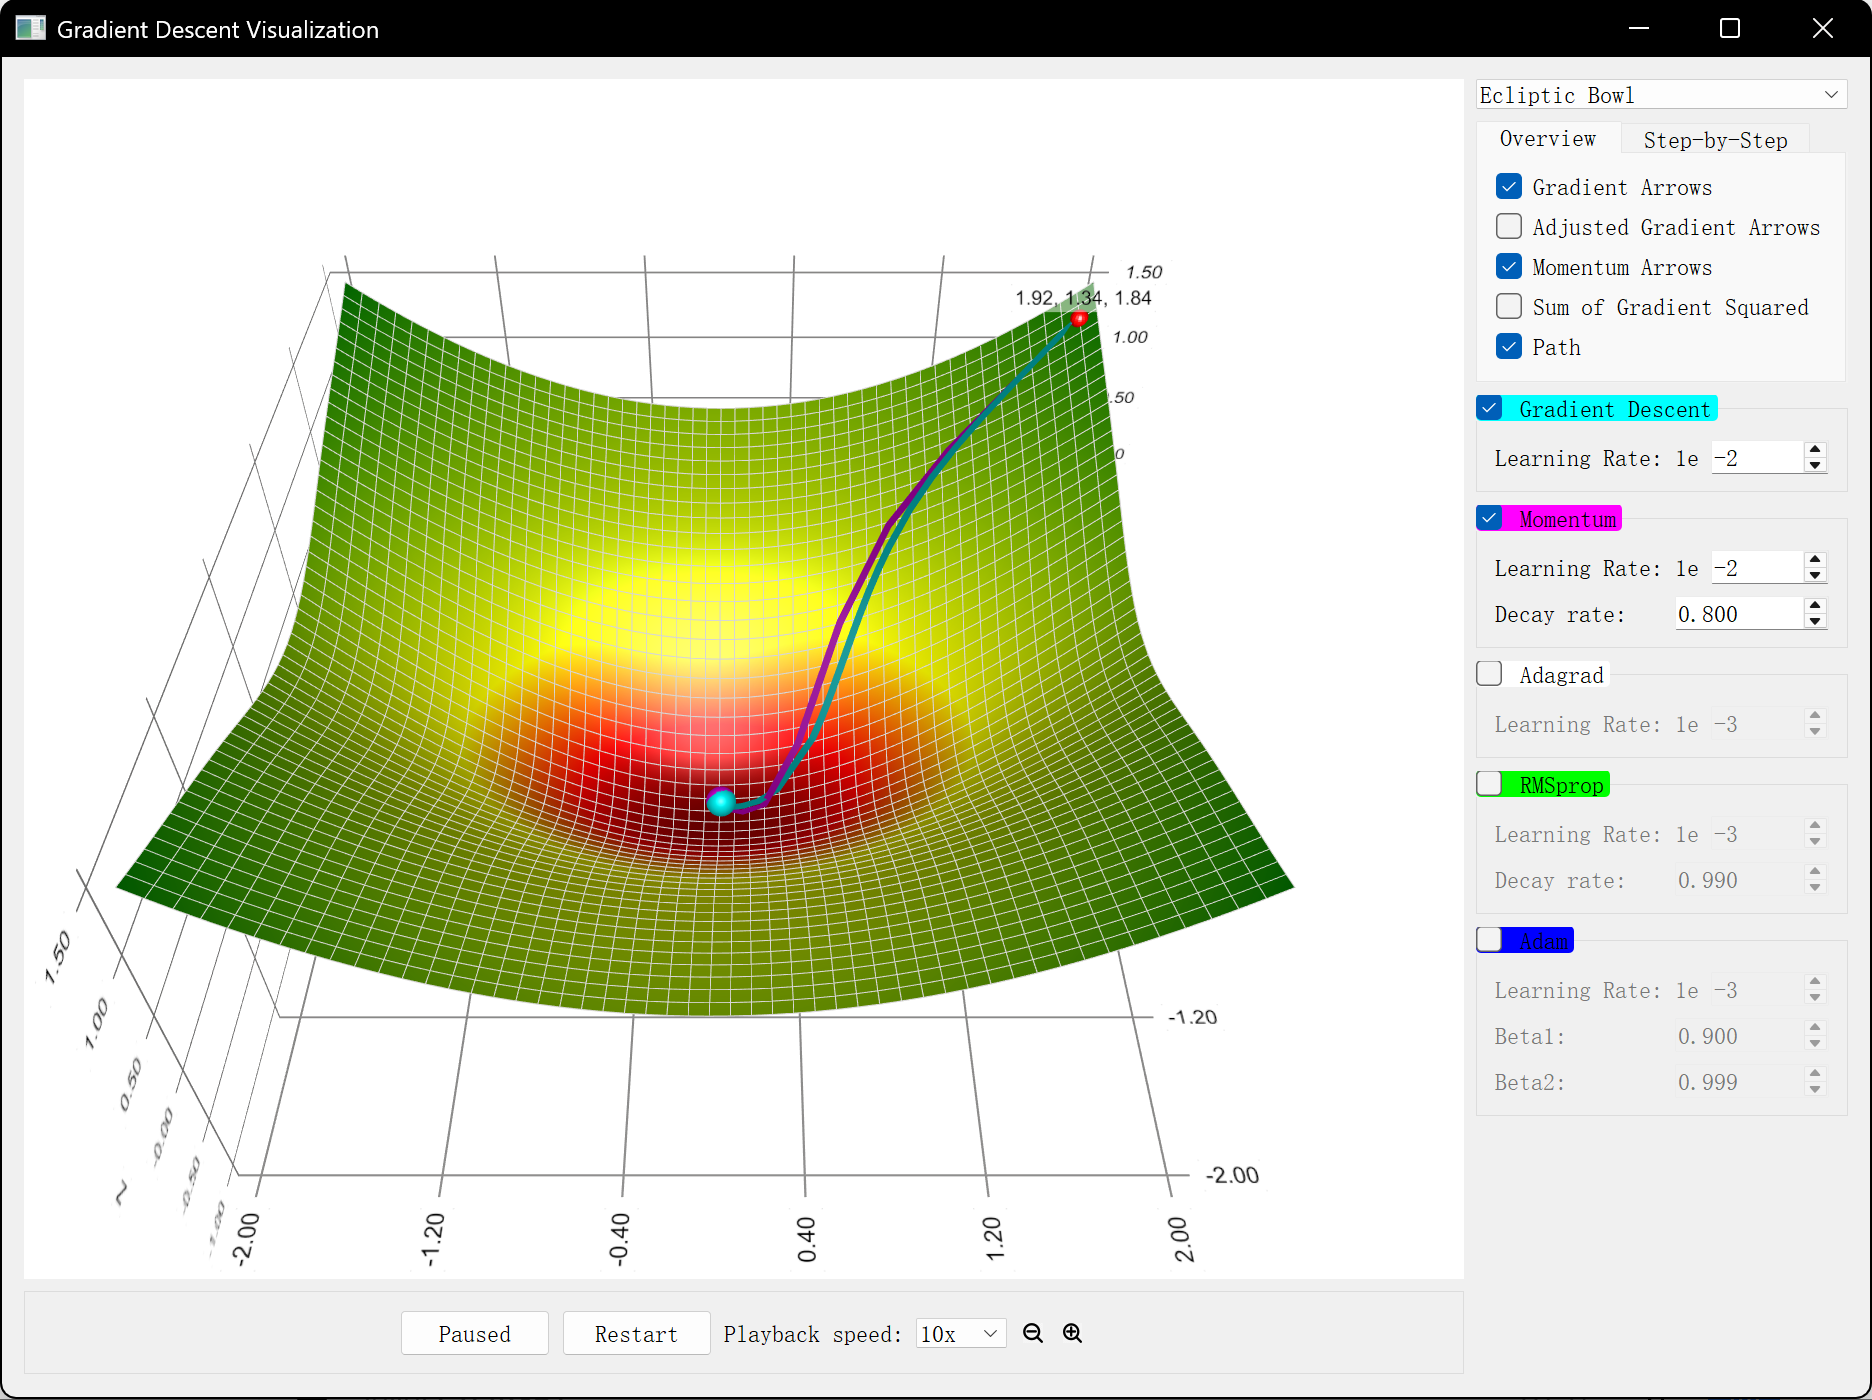
图中可以看出 Momentum 倾向于原来的轨迹,而 GD 更倾向即时的梯度轨迹。
更进一步,把 展开会发现:越近的梯度权重越大,越久以前的梯度权重越小( 时权重按 指数衰减)。所以 Momentum 本质上是在对过去的 Gradient 做 Exponential Moving Average——这个思想后面在 RMSProp 和 Adam 里还会再次出现。
3.4 Nesterov:先往前看一步
Momentum 有惯性既是优点也是缺点:一个球高速冲向最低点时,由于已经积累了很大的速度,即使快接近最优解也可能直接冲过去再回来。所以又产生一个问题:既然已经知道下一步大概会走到哪里,能不能先看看那里是什么情况? 于是有了 Nesterov Accelerated Gradient(NAG)。
普通 Momentum 是「当前位置 → 算梯度 → 结合 Momentum → 更新」;Nesterov 是「当前位置 → 按照 Momentum 先向前看一步 → 在预计到达的位置计算梯度 → 再修正方向」,所以它经常被称为 Look Ahead(前瞻)。直觉区别是:Momentum 说「我现在看看坡度,再结合惯性决定往哪走」,Nesterov 说「我已经知道自己有惯性,那我先看看按照惯性冲过去以后那里是什么情况,再提前刹车或者转弯」——就像开车时预测汽车马上会到的位置、提前观察那里再调整方向。Sutskever 等人的工作发现,经过合理设置后 Nesterov 能显著改善部分深度网络优化问题。
四、AdaGrad 与 RMSProp:每个参数自己的学习率
4.1 为什么不能共享一个学习率
到目前为止,我们优化的主要是「方向」。Momentum()解决的是梯度方向不稳定的问题(Direction)。但还有另一个很重要的问题:Step Size。例如现在两个参数 的梯度分别是 、,却使用同一个学习率 ,那么 ,而 ,两者差异巨大。于是问题来了:为什么所有参数一定要共享同一个学习率? 能不能让 和 拥有自己的自适应学习率?这就是 AdaGrad。
4.2 AdaGrad:根据历史梯度调整每个参数
AdaGrad 的核心思想是根据历史梯度大小自动调整每个参数的实际步长:首先累计历史梯度平方 ,然后:
其中 是一个非常小的数,防止 导致除零。AdaGrad 于 2011 年由 Duchi、Hazan 和 Singer 系统提出,其核心思想就是根据此前观察到的数据和梯度几何信息,自适应改变不同参数方向上的更新尺度。
直觉是这样的:某个参数的梯度一直很大, 不断累积、 不断变小——梯度经常很大的方向,学习率逐渐变小;而某些很少出现、梯度比较稀疏的参数, 仍然比较小、有效学习率比较大。因此 AdaGrad 特别适合 Sparse Features:比如 NLP 里 the 出现十万次、罕见的 aardvark 只出现几十次,如果两个参数用完全相同的学习率未必合理,AdaGrad 能给罕见特征更大的相对更新空间。原论文也特别强调了这种自适应方式对稀有但预测性强的特征的优势。
4.3 AdaGrad 的致命问题
注意 ,所以 只会越来越大、永远不会减小,那么 只会越来越小,训练到后面可能出现 Effective Learning Rate ,模型几乎不再更新。这就是 AdaGrad 最大的问题:它记住了从训练开始以来所有梯度——但十万步以前发生的事情,真的还那么重要吗?显然未必。所以很自然地产生一个想法:能不能像 Momentum 一样,让久远历史逐渐遗忘? 于是就有了 RMSProp。
4.4 RMSProp:只关注近期历史
RMSProp 把 AdaGrad 的 改成:
区别在于:AdaGrad 把 全部永久保存,RMSProp 则是 ,越久以前权重越小——也就是对 做 Exponential Moving Average of Squared Gradients。于是 可以变大也可以变小,Effective Learning Rate 能够动态调整。Hinton 的 Neural Networks for Machine Learning 课程将 RMSProp 描述为:用梯度近期平方/幅度的移动平均来归一化梯度。
RMSProp 在鞍点上表现更好的原因也在这里。神经网络高维 Loss Surface 中经常存在 Saddle Point(鞍点),比如 在 处 但不是最低点——一个方向向上弯、另一个方向向下弯,形状像马鞍,普通梯度下降在这种区域可能下降得很慢。而 RMSProp 会根据不同方向近期梯度平方调整有效步长 ,让不同方向拥有不同的实际学习率:
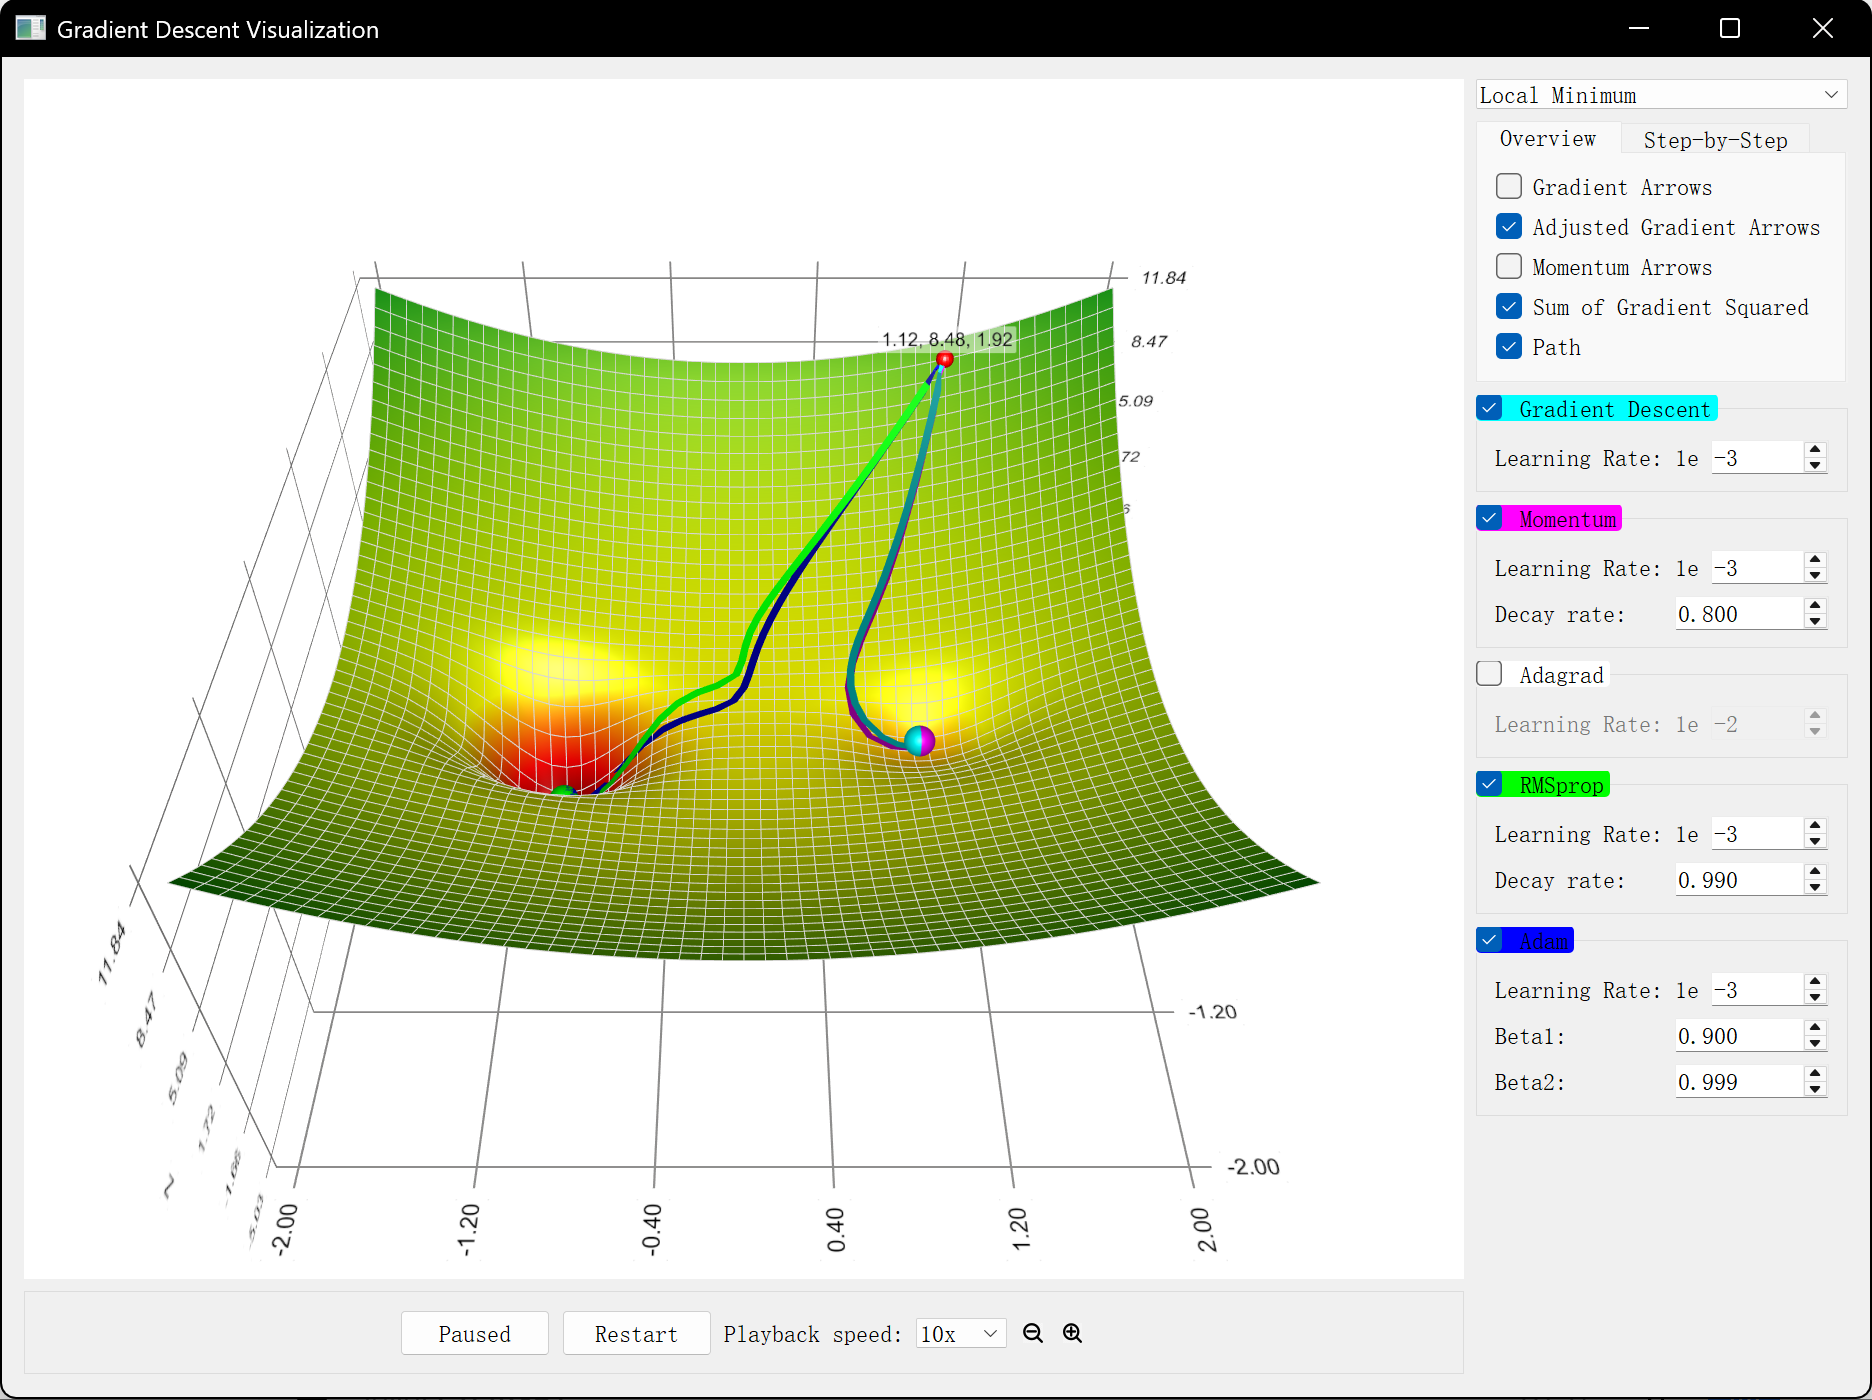
五、Adam:Momentum + RMSProp
5.1 两条路线的汇合
到这里已经出现两条非常清楚的优化路线。第一条是 Momentum,解决 Direction 问题,利用 让更新方向更加稳定:;第二条是 RMSProp,解决 Step Size 问题,利用 调整每个参数的实际学习率:。那么一个非常自然的问题出现了:为什么不把两个都用上? 于是 Adam 出现了。
5.2 Adam 的公式
Adam 全称 Adaptive Moment Estimation,2014 年由 Kingma 和 Ba 提出。它同时维护两个量:(非常像 Momentum,是梯度的一阶矩估计)和 (非常像 RMSProp,是梯度平方的二阶原始矩估计):
最终更新:
可以非常直观地理解成「方向 ÷ 尺度」: 负责往哪里走, 负责这个方向应该走多大。所以:
Adam 原论文将其描述为一种基于梯度低阶矩自适应估计的随机一阶优化方法。
5.3 为什么 Adam 还需要 Bias Correction
Adam 初始化 、,训练刚开始的时候 和 会受到初始值 0 的影响导致偏小,所以 Adam 会做偏差修正:
完整的更新就是 。Adam 原论文的典型默认设置是 、、,并指出该算法计算效率较高、内存需求较低,适合大规模参数和噪声/稀疏梯度问题。
5.4 一张表看懂优化器的发展
| 优化器 | 使用当前梯度 | 历史梯度 | 梯度平方 | 自适应 LR | Momentum |
|---|---|---|---|---|---|
| GD / SGD | ✓ | ||||
| Momentum | ✓ | ✓ | ✓ | ||
| Nesterov | ✓ | ✓ | ✓ | ||
| AdaGrad | ✓ | ✓ | ✓ | ||
| RMSProp | ✓ | ✓ EMA | ✓ | ||
| Adam | ✓ | ✓ | ✓ EMA | ✓ | ✓ |
可以看到整个发展过程并不是突然跳出来的,而是每个方法都在解决前一个方法的问题。用一句话记住每一种优化器:Gradient Descent 看当前坡度下山;SGD 不用看整座山、随机抽一些数据估计方向;Momentum 下山时带上惯性;Nesterov 有惯性但提前看看马上要到的位置再决定怎么走;AdaGrad 每个方向根据历史梯度拥有自己的学习率;RMSProp 是 AdaGrad 别把一辈子的历史全记住、只关注近期;Adam 是 Momentum 管方向、RMSProp 管步长,两者一起用。
六、从牛顿法到 AdamW
6.1 牛顿法:用上二阶导数
视频中还讲到了 Newton’s Method(牛顿法),它和前面这些方法的思路有一个明显区别:梯度下降只使用一阶导数 ,只知道当前位置往哪边下降;而牛顿法进一步使用二阶导数,也就是曲率信息。一维情况下:
多维情况下:
其中 就是 Hessian Matrix,包含 。也就是说,牛顿法不只是问「坡往哪里下?」,它还问「这个地方到底有多弯?」。梯度下降所有方向基本依赖同一个 ,而牛顿法的 Hessian 告诉模型不同方向的 Curvature,因此它可以根据 Loss Surface 的形状调整步长和方向。从优化理论角度看,它相当于在当前位置做二阶 Taylor 展开 ,然后直接寻找这个局部二次近似的最低点。
6.2 为什么深度学习不用牛顿法
关键问题是:Hessian 太大。假设模型有 个参数,那么 ;如果 (十亿参数),Hessian 就是 的规模,更不用说还需要求逆 。所以对于现代神经网络,显式计算和保存完整 Hessian 通常是不现实的——这也是为什么深度学习主流优化器仍然主要基于 First-order Optimization(一阶优化,也就是梯度)。
6.3 Adam 一定比 SGD 好吗
不是,这也是学习优化器时很容易形成的误区。SGD → Momentum → RMSProp → Adam 看起来像旧版 → 新版 → 更强新版,但它们不是简单的版本替代关系。Adam 通常收敛快、对初始学习率相对鲁棒、对稀疏梯度友好、超参数通常比较容易设置,因此很适合作为默认起点;但在一些视觉模型训练中 SGD + Momentum 依然非常常见,而现代 Transformer 中则经常看到 AdamW。所以实际使用优化器时,不应该简单认为 Adam > RMSProp > Momentum > SGD,而应该理解:它们拥有不同的优化动态和归纳偏置。
6.4 AdamW:解耦 Weight Decay
虽然这个视频主要讲到 Adam,但继续往现代模型走,很快就会遇到 AdamW,它解决的一个核心问题是 Weight Decay 和 Adam 的 Adaptive Update 应该如何结合。传统 L2 Regularization 是 ,其梯度为 ;对于普通 SGD,这和 Weight Decay 在一定条件下可以对应起来。但对于 Adam 这种自适应优化器, 会重新缩放梯度,因此 L2 Regularization 和 Weight Decay 不再简单等价。AdamW 的思路就是:把 Weight Decay 从梯度更新中解耦出来。所以现在训练 ViT、BERT、GPT 等大量 Transformer 时经常看到 torch.optim.AdamW(…),而不是直接 torch.optim.Adam(…)。
七、回顾与总结
7.1 整个发展过程:一串连续的问题
现在可以把优化器演化看成几个连续的问题:
- 怎么让 Loss 下降? → Gradient Descent;
- 全部数据算梯度太慢怎么办? → SGD / Mini-batch;
- SGD 震荡太严重怎么办? → Momentum;
- Momentum 会冲过头怎么办? → Nesterov;
- 所有参数共享一个学习率合理吗? → AdaGrad;
- AdaGrad 学习率越来越小怎么办? → RMSProp;
- 既想要 Momentum,又想自适应 Learning Rate 怎么办? → Adam。
所以:优化器的发展,本质上就是不断修改「更新方向」和「更新步长」。
7.2 最核心的一张关系图
整个优化器发展可以记成:
                    Gradient Descent
                           │
                          SGD
                           │
              ┌────────────┴────────────┐
              │                         │
          优化方向                   优化步长
              │                         │
          Momentum                   AdaGrad
              │                         │
          Nesterov                   RMSProp
              │                         │
              └────────────┬────────────┘
                           │
                          Adam
                           │
AdamW也可以写成:、,而:
这是理解 Adam 最简洁的一种方式。
7.3 一句话总结
训练神经网络本质上是在解决 ,最基础的方法 就是梯度下降。但普通梯度下降存在梯度噪声、震荡、学习率难调、不同参数共享学习率、复杂 Loss Surface 下优化效率低等问题。于是 Momentum 利用历史梯度 改善方向;AdaGrad 开始根据 调整每个参数的实际学习率;RMSProp 进一步把 改成 ,避免 AdaGrad 学习率持续衰减;最后 Adam 把二者结合—— 负责方向、 负责尺度:
所以如果只记住这篇文章的一句话:优化器的发展,本质上就是想办法让模型知道:下一步应该往哪里走,以及应该走多远。
参考资料
- 王木头学科学:《随机梯度下降、牛顿法、动量法、Nesterov、AdaGrad、RMSprop、Adam——理解梯度下降法的优化》:https://www.bilibili.com/video/BV1r64y1s7fU/
- Lili Jiang, Gradient Descent Visualization(支持 GD / Momentum / AdaGrad / RMSProp / Adam 的可视化):https://github.com/lilipads/gradient_descent_viz
- Sutskever, Martens, Dahl, Hinton, On the Importance of Initialization and Momentum in Deep Learning, ICML 2013:https://proceedings.mlr.press/v28/sutskever13.html
- Duchi, Hazan, Singer, Adaptive Subgradient Methods for Online Learning and Stochastic Optimization, JMLR 2011:https://jmlr.org/papers/v12/duchi11a.html
- Geoffrey Hinton, Neural Networks for Machine Learning — Lecture 6e(RMSProp 的经典出处之一)
- Kingma & Ba, Adam: A Method for Stochastic Optimization, ICLR 2015:https://arxiv.org/abs/1412.6980