论文:Concepts’ Information Bottleneck Models(CIBMs,概念信息瓶颈模型) 作者:Karim Galliamov、Syed M Ahsan Kazmi、Adil Khan、Adin Ramirez Rivera(阿姆斯特丹大学 / 西英格兰大学 / 赫尔大学 / 奥斯陆大学) 出处:ICLR 2026(conference paper) 定位:可解释 AI(XAI)方向——把 信息瓶颈(IB) 正则化直接施加到 概念瓶颈模型(CBM) 的概念层上,用信息论做“最小充分概念”,同时提升精度、降低概念泄漏、增强可干预性。与 Single-DGOD/蒸馏无直接任务重叠,但“用 I(X;C) 压缩抑制泄漏”的机制与 Cauvis 的“抑制伪相关”、蒸馏的“传什么不传什么”高度同构(见文末课题启发)。
0. 一句话核心
CBM 的概念层会“泄漏”多余输入信息(concept leakage),既伤可解释性又伤下游精度。本文引入显式信息瓶颈正则化:压 I(X; C)、保 I(C; Y),让概念既精简又充分——不改架构、不加监督,任何 CBM 家族都能即插即用,实验全面优于 vanilla 对应物。
1. 背景与动机
- CBM(Koh et al., 2020):通过人类可理解的概念层 C 做预测,支持测试时对概念进行干预(intervention)。但 CBM 普遍比黑盒模型精度低,且存在 concept leakage——概念激活里编码了超出预期语义的输入信息(Mahinpei 2021; Margeloiu 2021)。
- 已有修复路线:改架构 / 增强概念嵌入(Havasi 2022; Kim 2023)→ 复杂度高、降低可干预性、难以跨 CBM 变体泛化。
- 本文立场:与其修结构,不如用信息论直接在概念空间做“受控压缩”——把泄漏从根上掐掉。
核心病根(作者解释):vanilla CBM 是“过度压缩”——把 I(X;C) 和 I(X;Z) 压缩得过狠,连同任务相关信息一起丢掉;而 CIBM 做的是“先充分、后选择性压缩”:保留驱动 Y 的信号(高 I(C;Y)),只丢掉噪声(低 I(X;C))。
2. 方法:Concepts’ Information Bottleneck(CIB)
2.1 目标函数(从潜在空间 IB 迁移到概念空间 IB)
CBM 管道:X → Z → C → Y。
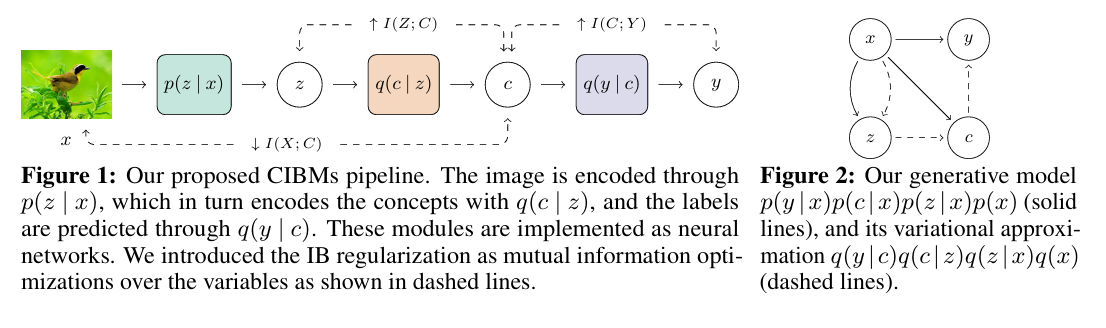
图注:图像 x 经编码器 p(z|x) 得到表示 z,再经 q(c|z) 得到概念 c,最后经 q(y|c) 预测标签 y;虚线标出三个优化方向——↑I(Z;C)、↑I(C;Y)、↓I(X;C)。右半部分(论文 Figure 2)是生成模型(实线 p 路径)与变分近似(虚线 q 路径)的概率图模型,对应 §2.2 的变分近似。
- 经典 IB(Tishby 2000)作用于潜在空间:
- 本文改为作用在概念空间(核心创新):
为什么换空间:数据处不等性只保证 I(X;C) ≤ I(X;Z)——压 Z 只能“隐含地、间接地”限制 C;而显式压 I(X;C) 能直接掐断冗余/伪相关信息进入概念层的通路(哪怕 Z 容量很大,“泄漏”也没法从 Z→C 幸存下来)。这是比传统 IB 更强的可解释性约束。
2.2 两种可实现的变体
① IBB(Bounded CIB,用变分界)——把互信息项拆成交叉熵: 最大化 ≈ 最小化 y、c 的交叉熵 + 调节概念熵 H(C)。需要估计 p(c) 的熵(附录 D.4)。
② IBE(Estimator-based CIB,保留显式互信息项): 其中 I(X;C) 用 Monte-Carlo 互信息估计器(沿用 Kawaguchi et al. 2023)显式估计:假设概念 logits 服从高斯(估 log p(c|x)),随机采样 batch 近似边缘 log p(c),I(C;X) ≈ E[log p(c|x) − log p(c)]。
两者关系:IBB 把互信息简化成交叉熵,IBE 保留对 I(X;C) 的显式控制,因而对泄漏的约束更紧、效果更好。作者还指出 IBB 在 vanilla 设置下训练不稳定——H(C) 的梯度会损伤特征编码器 p(z|x),修法是从 H(C) 到编码器做 stop-gradient,之后与 IBE 相当。
2.3 理论(PAC-Bayes)
- 定理 2:CIBM 的泛化上界比 vanilla CBM 严格更紧——只要正则强度 λ 足够小(确保泛化差距 >0),复杂度降低带来的收益超过训练误差的轻微增加。推导见附录 B。
3. 实验与结果
- 数据集:CUB、AwA2、aPY(三个属性/概念标注基准)。
- 6 个 CBM 家族:hard/soft × joint/independent(HJ/HI/SJ/SI)+ ProbCBM + IntCEM + AR-CBM,全部做“等容量 vanilla vs +IBB/+IBE”的同法内对比(同一骨干/数据/训练配方)。
- 评测维度:概念精度、类别精度、概念泄漏(OIS / NIS)、干预性能(AUCTTI / NAUCTTI)、信息平面分析。
要点结果(表 1):
- CUB:IBB/IBE 在类别精度上普遍不低于 vanilla,且概念精度持平或略升;完整对比见论文表 1(PDF 表格在文本抽取中列有错位,数值以原表为准)。
- AwA2:类别精度增益温和(数据集较简单,提升空间小),概念精度持平。
- aPY:正则化后显著超过 vanilla CBM,甚至超过 black-box——既保可解释性又拿回精度,是本文最有说服力的一档。
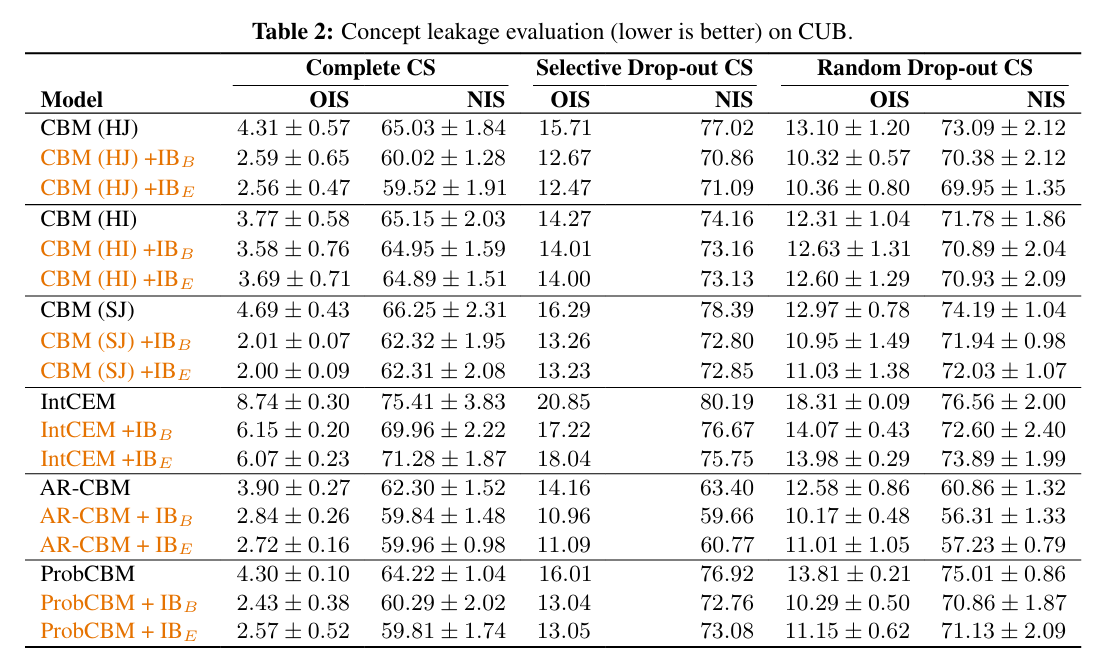
概念泄漏(表 2,CUB,OIS/NIS 越低越好):在 Complete / Selective Drop-out(丢掉最可预测的一半概念)/ Random Drop-out 三种设置下,IBB 与 IBE 的 OIS/NIS 都降到最低——即使删掉大量概念也不崩。
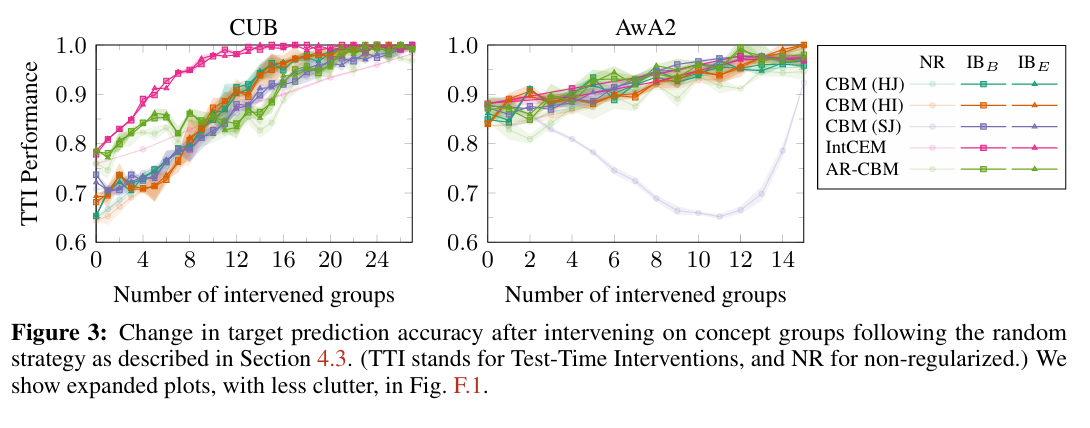
干预(图 3):IBB/IBE 随干预概念组数单调上升、无回撤;soft-joint CBM 中段出现明显回落(表征泄漏多、随机组纠正下不稳);hard CBM 起步低、涨得慢。IntCEM 和 AR-CBM 受益最大。
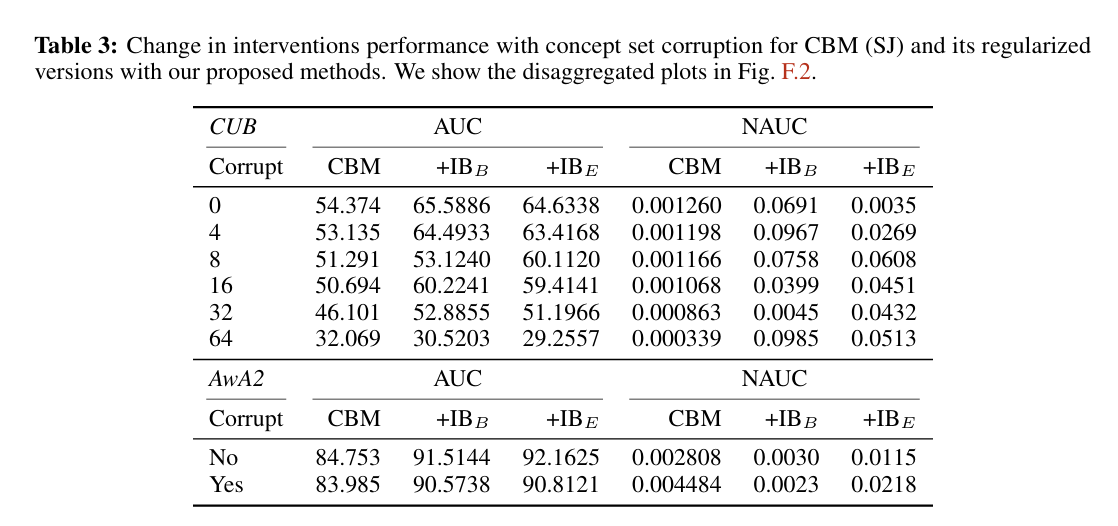
概念集质量度量(表 3,AUCTTI/NAUCTTI):概念集被污染时,IBE 对概念质量更敏感 → 是更好的“概念集好坏”指示器;NAUC 为负说明存在概念泄漏。
信息平面(附录 H):CIBM 比 vanilla 有更高的 I(C;Y)(保住了任务信号)、更低的 I(X;C)(滤掉了噪声);vanilla CBM 是“盲目压缩”,这正是其精度低、泄漏高的来源。
超参(§4.6,表 D.3/D.4):vanilla 公平设置下 IBE > IBB(IBB 不稳定来自 H(C) 梯度);stop-gradient 修复后 IBB ≈ IBE;λ 扫了 6 个值结果不显著,统一取 λ = 0.5。
4. 结论与卖点
- 首个把 IB 正式落到 CBM 概念层的框架(此前 IB 都作用在通用潜在特征 Z 上);
- 即插即用、与架构无关、不需要额外监督或旁路;
- 同时拿到:更高类别精度、大幅降低概念泄漏、更好或持平的概念精度、更可靠可单调的测试时干预;
- 关键洞察:“泄漏对概念‘使用’的伤害远大于对概念‘检测’的伤害”——这也解释了为什么“概念预测近满分”的 CBM 端到端性能仍可能很差。
5. 短板(读后总结)
- IBB 稳定性问题需要 stop-gradient 这种“补丁式”修复,说明理论界与实际优化之间仍有 gap;
- λ 选择“扫不出显著性、统一 0.5”略显草率,正则强度对数据集/模型的敏感性没被真正刻画;
- 只在属性分类基准(CUB/AwA2/aPY)验证,没碰视觉检测/分割等更复杂任务;
- 未讨论概念数量很多(数百)时 Monte-Carlo MI 估计的方差与计算开销;
- 所有对比都是“同一配方内加正则”,跨骨干/跨训练范式的鲁棒性未深入。
🔒 6. 与课题(蒸馏 × Single-DGOD / Cauvis)的启发
(跨任务迁移,需自行验证)
- 给 Cauvis 补“显式解耦损失”的理论依据:Cauvis 的因果/辅助双分支只有标准检测损失驱动,没有任何显式约束。CIB 告诉我们:想抑制“伪相关/泄漏进特征”,可以直接压 I(X; C)(C=因果/域不变特征),同时保 I(C; Y)——这正是“最小充分、域不变”的严格写法。可以给 Cauvis 的因果分支加一个概念级 IB 正则项(I(X; C_causal) 压低 + I(C_causal; Y) 保持),替代目前“靠结构先验 + 隐式优化”。
- 蒸馏的“传什么”信息论判据:蒸馏本质是“学生从教师学知识”,但知识里混着教师的泄漏/域特有成分。CIB 框架给出判据:只传**与任务充分(I(C;Y) 高)又不泄漏输入冗余(I(X;C) 低)**的表示——对应“蒸馏域不变内容特征(Fc)、别蒸域特有/风格特征”的路线(SE-COT/MR-DCoT 的风格-内容解耦蒸馏)。
- 与 Night Rainy 短板的联系:雨夜特征里“泄漏”最重(低照度+雨纹都是强伪相关)。用 IB 式压缩压低 I(X;C) 可能比“造更真实的雨夜样本”更根本——和 Cauvis 的因果派哲学一致(不造数据,洗伪相关)。
- 概念瓶颈 → 检测头:CIB 的“干预 = 用 GT 概念覆盖预测概念”对应到检测,可以类比“用 GT 框覆盖/修正教师预测框”的测试时修正思路(仅作机制类比)。
7. 一句话总结
把信息瓶颈从“潜在空间”搬到“概念空间”:压 I(X;C)、保 I(C;Y),用最轻的正则同时治好 CBM 的“泄漏”与“过度压缩”,实现精度、可解释性、可干预性三赢——也为“用显式互信息约束抑制伪相关”提供了可迁移到 SDGOD/蒸馏的理论模板。
8. 相关资料
- 论文(arXiv):Galliamov et al., Concepts’ Information Bottleneck Models, ICLR 2026:https://arxiv.org/abs/2602.14626
- 关键参考文献:IB(Tishby 2000 / Alemi 2017)、CBM(Koh 2020)、泄漏(Havasi 2022; Margeloiu 2021; Mahinpei 2021)、泄漏指标 OIS/NIS(Espinosa Zarlenga 2023a)、IB 泛化分析(Kawaguchi 2023)、ProbCBM(Kim 2023)、IntCEM(Espinosa Zarlenga 2023b)、AR-CBM(Havasi 2022)
- 相关博客: